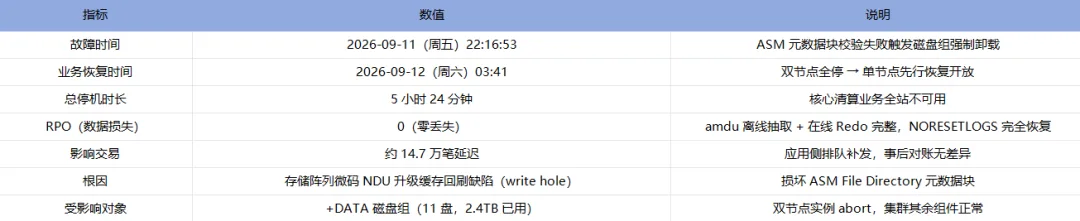
2026-09-11 22:16:53,一套 11.2.0.4 双节点 RAC 的 +DATA 磁盘组在 4 秒内完成"元数据校验失败 → 强制卸载 → 双实例 abort"的传导。集群件本身健康,主机与链路无异常,存储介质扫描也报告 0 坏扇区——坏的是 ASM 文件目录的一个元数据块。
最终用 amdu 绕过损坏元数据把 3.2TB 数据文件抽到 NFS,再以单实例模式挂载、RENAME、RECOVER,走 NORESETLOGS 路径完全恢复,RPO=0,停机 5 小时 24 分钟。
这篇复盘的重点不是"怎么修",而是"先取证再动手":在确认盘头完好、损坏范围仅限单个元数据块之前,任何 kfed repair、MOUNT FORCE、重建磁盘组的动作都可能把可恢复变成不可恢复。
环境与故障概况
环境架构
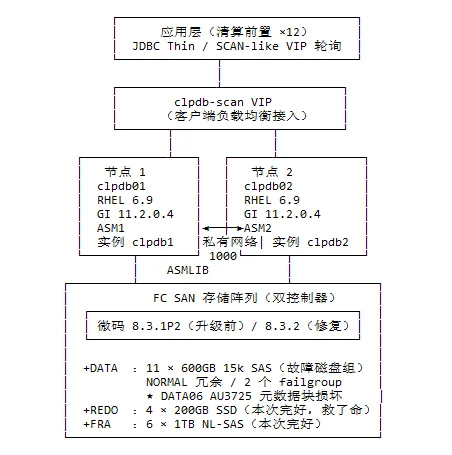
应用层为 12 台清算前置,JDBC Thin 经 SCAN 类 VIP 轮询接入;两个数据库节点共享一套 FC SAN 双控制器阵列,ASMLIB 管理磁盘。
环境参数
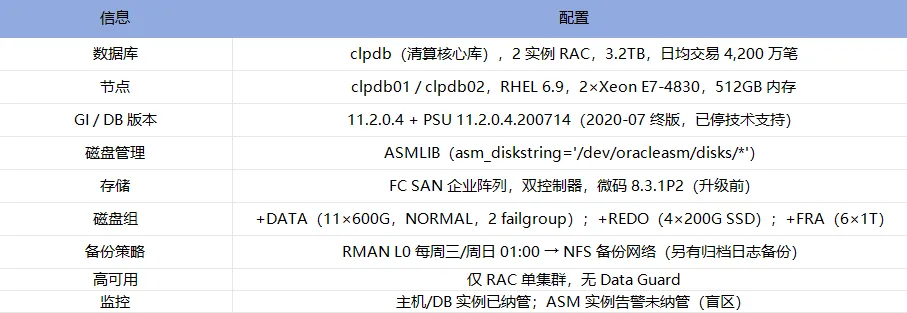
| 项目 | 配置 |
|---|---|
| 数据库 | clpdb(清算核心库),2 实例 RAC,3.2TB,日均交易 4,200 万笔 |
| 节点 | clpdb01 / clpdb02,RHEL 6.9,2×Xeon E7-4830,512GB 内存 |
| GI / DB 版本 | 11.2.0.4 + PSU 11.2.0.4.200714(2020-07 终版,已停技术支持) |
| 磁盘管理 | ASMLIB(asm_diskstring='/dev/oracleasm/disks/*') |
| 存储 | FC SAN 企业阵列,双控制器,微码 8.3.1P2(升级前) |
| 磁盘组 | +DATA(11×600G,NORMAL,2 failgroup);+REDO(4×200G SSD);+FRA(6×1T) |
| 备份策略 | RMAN L0 每周三/周日 01:00 → NFS 备份网络(另有归档日志备份) |
| 高可用 | 仅 RAC 单集群,无 Data Guard |
| 监控 | 主机/DB 实例已纳管;ASM 实例告警未纳管(盲区) |
两个设计细节决定了这次能零丢失恢复:Redo 独立放在 +REDO(SSD 盘组),归档独立放在 +FRA,两者在本次故障中都完好。
关键时间点
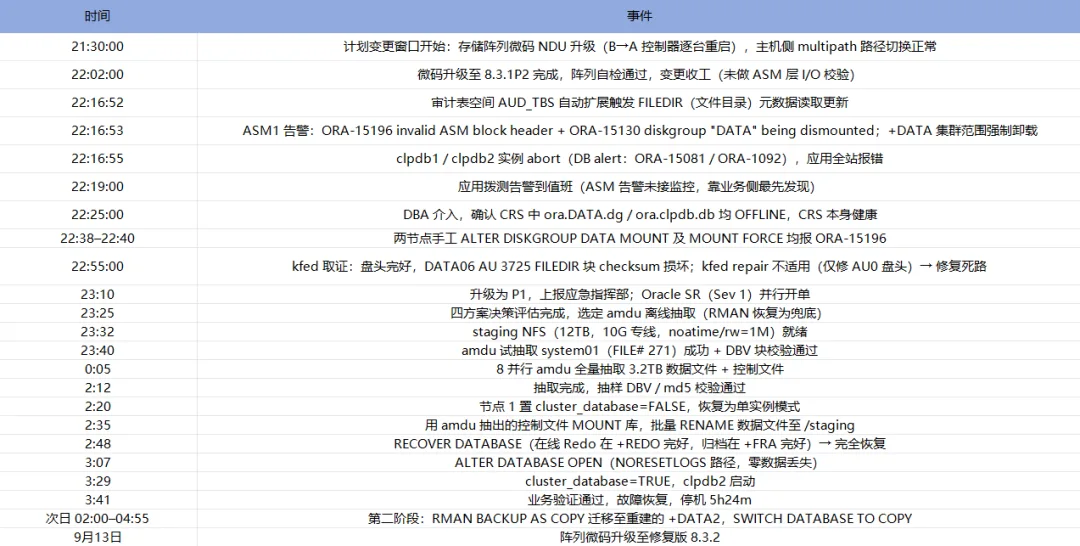
| 时间 | 事件 |
|---|---|
| 21:30 | 变更窗口开始,阵列微码 NDU 升级(B→A 控制器逐台重启),主机侧 multipath 路径切换正常 |
| 22:02 | 微码升级至 8.3.1P2 完成,阵列自检通过,变更收工(未做 ASM 层 I/O 校验) |
| 22:16:52 | 审计表空间 AUD_TBS 自动扩展,触发 FILEDIR(文件目录)元数据读取更新 |
| 22:16:53 | ASM1 报 ORA-15196,+DATA 集群范围强制卸载 |
| 22:16:55 | clpdb1 / clpdb2 实例 abort,应用全站报错 |
| 22:19 | 应用探测告警到值班(ASM 告警未监控,靠业务侧最先发现) |
| 22:25 | DBA 介入,确认 CRS 中 ora.DATA.dg / ora.clpdb.db 均 OFFLINE,CRS 本身健康 |
| 22:38–22:40 | 两节点手工 MOUNT 及 MOUNT FORCE 均报 ORA-15196 |
| 22:55 | kfed 取证:盘头完好,DATA06 AU 3725 FILEDIR 块 checksum 损坏;kfed repair 不适用 → 修复死路 |
| 23:10 | 升级为 P1,上报应急指挥部;Oracle SR(Sev 1)并行开单 |
| 23:25 | 四方案决策评估完成,选定 amdu 离线抽取(RMAN 恢复为兜底) |
| 23:32 | staging NFS(12TB,10G 专线,noatime/rw=1M)就绪 |
| 23:40 | amdu 试抽取 system01(FILE# 271)成功 + DBV 块校验通过 |
| 00:05 | 8 并行 amdu 全量抽取 3.2TB 数据文件 + 控制文件 |
| 02:12 | 抽取完成,抽样 DBV / md5 校验通过 |
| 02:20 | 节点 1 置 cluster_database=FALSE,恢复为单实例模式 |
| 02:35 | 用 amdu 抽出的控制文件 MOUNT 库,批量 RENAME 数据文件至 /staging |
| 02:48 | RECOVER DATABASE(在线 Redo 在 +REDO 完好,归档在 +FRA 完好)→ 完全恢复 |
| 03:07 | ALTER DATABASE OPEN(NORESETLOGS 路径,零数据丢失) |
| 03:29 | cluster_database=TRUE,clpdb2 启动 |
| 03:41 | 业务验证通过,故障恢复,停机 5h24m |
| 次日 02:00–04:55 | 第二阶段:RMAN BACKUP AS COPY 迁移至重建的 +DATA2,SWITCH DATABASE TO COPY |
| 9 月 13 日 | 阵列微码升级至修复版 8.3.2 |
故障现象
ASM 实例视角
+ASM1 alert log:
Fri Sep 11 22:16:53 2026
NOTE: user (oracle) terminating process 23719 (pid: 23719)
Errors in file /u01/app/grid/diag/asm/+asm/+ASM1/trace/+ASM1_ora_23719.trc:
ORA-15196: invalid ASM block header [kfc.c:26165] [183925669] [2] [6] [3725] [0] [] []

-- 参数解读: 磁盘组#2 / 磁盘#6(DATA06) / AU#3725 / 块#0
ERROR: no PST quorum in group 2: required 2, found 1
WARNING: dirty detached from diskgroup 2
ERROR: ORA-15130 thrown in RBAL for group 2/0x3f2ba1b0
ORA-15130: diskgroup "DATA" is being dismounted
NOTE: cache deleting group DATA
NOTE: disk 6 (DATA06) in group 2 is offline for (2849) seconds
Fri Sep 11 22:16:54 2026
ERROR: disk 6 (DATA06) in group 2 mount read failure, status=3
两节点 ASM 告警几乎同步(GIPC 广播强制卸载),+ASM2 随后也报 diskgroup "DATA" is being dismounted。
数据库实例视角
clpdb1 alert log:
Fri Sep 11 22:16:55 2026
Errors in file /u01/app/oracle/diag/rdbms/clpdb/clpdb1/trace/clpdb1_dbw0_21991.trc:
ORA-15081: failed to submit all I/O operations to an ASM instance
ORA-15196: invalid ASM block header
Fri Sep 11 22:16:56 2026
ORA-1092 : opitsk aborting process
Instance terminated by ORA-1092
clpdb2 同秒随 +DATA 卸载而 abort。数据库层面没有任何数据文件/坏块报错,所有 I/O 故障的源头都在 ASM 层。
集群件视角
crsctl stat res -t
ora.DATA.dg     OFFLINE  OFFLINE  OFFLINE  OFFLINE
ora.clpdb.db    OFFLINE  OFFLINE  OFFLINE  OFFLINE
ora.asm         ONLINE   ONLINE   ONLINE   ONLINE
ora.crs / css / evm / 网络栈     全部 ONLINE
CRS/CSS/网络栈完好 → 排除集群自身故障,问题收敛到"磁盘组为什么挂不起来"。
六步排查
第一步:三视角告警对齐,先定性
- 用 adrci 提取两节点 ASM/DB 告警,按时间轴对齐:ASM ORA-15196(第一因)→ +DATA 强制卸载(ORA-15130)→ DB 双实例 abort(ORA-15081/ORA-1092),因果链在 4 秒内完成传导。
- CRS 三层(CSS/CRS/EVM)日志无网络心跳、表决异常,排除集群/私网问题,避免被"实例批量崩溃"的表象带偏去查集群驱逐。
这一步的价值在于:双实例同时死,第一反应通常是集群或私网;但时间戳显示 ASM 先报错,DB 是受害者。
第二步:MOUNT 复现与错误指纹
SQL> alter diskgroup data mount;
alter diskgroup data mount
*
ERROR at line 1:
ORA-15032: not all alterations performed
ORA-15040: diskgroup is incomplete
ORA-15196: invalid ASM block header [kfc.c:26093] [183925669] [2] [6] [3725] [0] [] []
- MOUNT FORCE 同样失败。FORCE 只能容忍"缺盘",不能容忍"在线盘的元数据内容坏"。
- 错误指纹定位:
[2] [6] [3725] [0]= 磁盘组 2 / 磁盘 6(DATA06)/ AU 3725 / 块 0。 - 语义区分:ORA-15063(发现盘数量不足)≠ ORA-15196(盘都在、内容校验失败),本例是后者。
第三步:kfed 底层取证
先体检磁盘头,排除"盘头丢失/覆写"类故障:
$ $ORACLE_HOME/bin/kfed read dev=/dev/oracleasm/disks/DATA06 aunum=0 aus=1048576
kfbh.endian:                          1 ; 0x000: 0x00000001
kfdhdb.dskname:                  DATA06
kfdhdb.grptyp:                       2 ; kfdhdb.hdrsts: 3 (MEMBER)
kfdhdb.grpname:                  DATA
kfdhdb.cincostamp/kfdhdb.fcnst...  正常

-- kfdhRead 通过 → 盘头与备份副本一致
再定位损坏块:
$ kfed read dev=/dev/oracleasm/disks/DATA06 aunum=3725 blkn=0 aus=1048576
kfbh.check:                    0x0   ; kfbh.check 输入与存储值不匹配
kfbh.b.type:                   0x0   ; 期望 FILEDIR 元数据块类型
kfdhData.aunum...              结构不可解析
结论:FILEDIR(文件目录,元数据文件 #1)在 DATA06 AU3725 的镜像副本 checksum 失败。
- 由于 NORMAL 冗余,FILEDIR 该块在 failgroup 内另有副本,但 11.2 mount 流程对"某盘元数据块校验失败"直接中止,不会自动用副本修复(这是 11.2 行为,12c+ 部分场景有改善,也是本案例恢复困难的版本因素)。
kfed repair只适用于 AU0 磁盘头(有副本可校验),对 AU3725 的 FILEDIR 块无效 → 元数据修复路线封死。
第四步:排除主机、链路与介质
multipath -ll、/var/log/messages:无路径抖动、无 SCSI reset、无介质错误。oracleasm querydisk:ASMLIB 标签正常,11 块盘全部可见。- 阵列侧介质扫描(media scan)报告 0 坏扇区 → 排除介质坏块,区别于"BBU 掉电真坏块"类故障。
- 故障呈现"内容坏而硬件不坏",唯一能写入该 LUN 的变量就是 22:02 完成的微码升级。
第五步:厂商协同定位写入路径缺陷
- 调取阵列事件日志:22:01:47 控制器 B NDU 停机前,cache flush 出现 2 次 rewrite 重试(当时未告警)。
- 将损坏 AU 映射到阵列 LUN 的物理块区间:DATA06 AU 3725 对应的 LUN offset 恰命中 22:01:47 控制器 B 回刷的条带。
- 厂商工程师确认:微码 8.3.1P2 存在已知 write hole 缺陷——NDU 缓存镜像回刷时,对同一 RAID 条带的并发小块写存在"旧数据后落盘"竞态(read-modify-write 竞态),会在无校验差异告警的情况下污染条带;修复版本 8.3.2。
- 该缺陷命中率低(本阵列上线 3 年首例),但一旦命中元数据区域即致命。
第六步:恢复验证与闭环
- amdu 试抽取 system01 → DBV 块级校验 0 坏块 → 验证"元数据坏 ≠ 数据坏"的假设。
- 全量抽取后按 1/64 抽样 md5 + DBV 复核。
- OPEN 后
RMAN> RESTORE DATABASE VALIDATE、业务对账 14.7 万笔补发交易零差异 → 恢复正确性闭环。 - 厂商测试阵列复现 NDU 回刷竞态(同微码版本可重现,8.3.2 不可)→ 根因确认闭环。
相邻错误码怎么区分
ASM 挂载失败时常同时出现多个错误码,语义不同,处理方向也不同:
| 错误码 | 含义 | 处理方向 |
|---|---|---|
| ORA-15063 | 发现的盘数量不足,磁盘组不完整 | 先查盘、路径、ASMLIB 标签,补齐磁盘 |
| ORA-15040 | 磁盘组不完整 | 通常是缺盘的下游表现,跟随 15063 处理 |
| ORA-15196 | 盘都在,但元数据块内容校验失败 | 取证定位损坏块,评估 amdu / 备份恢复 |
| ORA-15130 | 磁盘组正在被卸载 | 结果而非原因,向上找第一条 ASM 报错 |
本例 ORA-15040 与 ORA-15196 同时出现,容易被误判成"缺盘"。真正的判据是 v$asm_disk 里 11 块盘全部可见、header_status 均为 MEMBER,而 mount 仍在同一 AU 上报校验失败。
恢复方案
为什么选 amdu
时间线里只记录了一条决策结论:"四方案决策评估完成,选定 amdu 离线抽取(RMAN 恢复为兜底)"。现场真正排除的路线有三条:
- 等 Oracle SR 给元数据修复手段:11.2 已停支持,时间不可控。
- 重建 +DATA 后 RMAN 全库恢复:备份为 L0,RPO 与恢复时间都不可接受,只能作兜底。
kfed repair修 FILEDIR:该命令只作用于 AU0 盘头(有副本可校验),对 AU3725 的 FILEDIR 块无效。
选 amdu 的关键判断是:数据文件本身没坏,坏的只是 ASM 用来定位文件的元数据。amdu 直接按文件号从磁盘抽取内容,不经过 FILEDIR,因此能绕开这个单点。
Step 1:amdu 离线抽取
# 元数据目录 dump(确认文件号分布)
$ amdu -diskstring '/dev/oracleasm/disks/DATA*' -dump -noredir -outputdir /staging/amdu/dump

# 试抽取(先小后大,先验证可行性)
$ amdu -diskstring '/dev/oracleasm/disks/DATA*' -extract DATA.271 -outputdir /staging/amdu
$ dbv file=/staging/amdu/DATA_271.f blocksize=8192   -- 0 坏块 → 假设成立

# 全量并行抽取(8 并行,按文件号分片)
$ for f in 263 271 272 ... ; do
amdu -diskstring '/dev/oracleasm/disks/DATA*' -extract DATA.$f -outputdir /staging/amdu &
done
先抽 system01 验证假设,再全量抽取。8 并行是按文件号分片,避免多个 amdu 抢同一文件。
Step 2:单实例模式挂载
-- 修改 pfile: *.cluster_database=false, control_files='/staging/amdu/DATA_263.f'
SQL> startup nomount pfile='/tmp/clpdb_pfile.ora';
SQL> alter database mount;

-- 控制文件内仍是 +DATA 旧路径,批量重命名到 /staging:
SQL> alter database rename file '+DATA/clpdb/datafile/system.256.861234501' to
'/staging/amdu/DATA_256.f';
... (56 个数据文件逐一 RENAME)
控制文件是从 ASM 抽出来的副本,里面的路径仍指向 +DATA,必须全部 RENAME 到抽取目录,否则 OPEN 时仍会去访问损坏的磁盘组。
Step 3:完全恢复并打开
SQL> recover database;          -- 应用在线 Redo(+REDO 完好)+ 归档(+FRA 完好)
SQL> alter database open;       -- NORESETLOGS 路径,零数据丢失
SQL> alter system set cluster_database=true scope=spfile;

-- 节点2 启动,恢复双实例 RAC
设计救赎点:Redo 日志独立放在 +REDO(SSD 盘组)、归档独立放在 +FRA,本层故障才得以实现完全恢复(零丢失)。若 Redo 与数据文件同盘组,则只能 RESETLOGS,损失故障瞬间未落盘事务。
第二阶段:迁回 ASM
恢复业务后,新建 +DATA2,用 RMAN 把库迁回 ASM,再升级阵列微码到 8.3.2。
RMAN> backup as copy database format '+DATA2';
RMAN> switch database to copy;
现场取证顺序
磁盘组挂不起来时,最容易犯的错是直接 MOUNT FORCE 或重建磁盘组。正确的顺序是先回答四个问题,每个问题都有对应的只读命令:
- 盘都在吗?
oracleasm querydisk -d DATA06、select name,path,header_status from v$asm_disk。header_status 为 MEMBER 说明盘头可识别。 - 盘头好吗?
kfed read dev=... aunum=0。能读出 dskname、grpname、hdrsts,说明 AU0 完好,问题不在盘头。 - 坏在哪一块? 用告警里的四元组
[group] [disk] [au] [block]直接定位,再kfed read aunum=<AU> blkn=0看 checksum 与块类型。 - 数据坏没坏?
amdu -extract抽一个数据文件,dbv校验。0 坏块说明只是元数据损坏,数据文件仍可救。
四个问题答完,才轮到选方案。顺序反了,轻则多做无用功,重则把仅有的副本覆盖掉。
命令速查
ASM 告警与状态
adrci> show alert -tail 200 -path diag/asm/+asm/+ASM1
SQL> select group_number,name,state,type from v$asm_diskgroup;
SQL> select disk_number,name,path,header_status,failgroup from v$asm_disk;
SQL> select * from v$asm_operation;  -- rebalance/平衡状态
kfed 取证三件套
kfed read dev=<disk> aunum=0 aus=<AU大小>       -- 磁盘头体检
kfed read dev=<disk> aunum=<错误中的AU号> blkn=0 -- 损坏块定位
kfed repair dev=<disk> aus=<AU大小>   -- 仅限 AU0 磁盘头(有副本)
amdu 抢救
amdu -diskstring '<ASM_DISKSTRING>' -dump -noredir  --dump 元数据目录
amdu -diskstring '<ASM_DISKSTRING>' -extract <DG>.<file#> --按文件号抽取
dbv  file=<抽取文件> blocksize=8192              -- 块级校验
无控制文件场景恢复四步
1) startup nomount pfile=...(cluster_database=false, control_files=抽取文件)
2) alter database mount; alter database rename file ... ;(批量改路径)
3) recover database; alter database open;(Redo/归档完好 → NORESETLOGS 零丢失)
4) 恢复 cluster_database=true,启动其余实例
元数据备份与巡检
asmcmd md_backup /staging/meta/`date +%F`_DATA2.md --每日例行
adrci 定时扫描:  ORA-15196 | ORA-15130 | ORA-15063 | ORA-15040
v$asm_disk_iostat 时延基线采集(reads/writes + elapsed_time)
微码/固件变更后: kfed 抽查盘头 + 小事务读写验证 + md_backup 快照
amdu 使用注意
-diskstring要覆盖磁盘组内所有盘,只给一块盘会抽不全条带。-extract的文件号要与-dump输出的目录、v$datafile的 file# 交叉核对,再开始批量抽取;抽错文件号会得到内容不匹配的片段。- 抽取目标目录所在文件系统要预留足够空间,本例 3.2TB 数据文件加控制文件,staging 给了 12TB。
- 抽取过程是只读的,不会改动源盘;但并行度过高会打满 HBA 与阵列前端,本例按文件号分片开了 8 路并行。
- 抽完后必须做
dbv与抽样 md5,确认抽取过程没有静默截断。
参考资料
原文附带的 MOS 文档:
- Doc ID 603054.1 — How to Restore Files to a New Diskgroup When ASM Diskgroup Cannot be Mounted
- Doc ID 1930346.1 — ORA-15196 / Diskgroup Cannot Be Mounted 处理路径
复盘结论
- 变更后必须做 ASM 层 I/O 校验。 阵列自检通过不等于数据库能读。微码升级收工前,至少做一次小事务读写、一次
kfed read盘头抽查、一次md_backup。 - ASM 告警必须纳入监控。 本次靠应用探测才发现,晚了几分钟;ASM 实例的 ORA-15196/ORA-15130 应单独告警。
- Redo 与数据文件分盘组是硬要求。 这次能 NORESETLOGS 零丢失,靠的就是 +REDO 和 +FRA 独立且完好。
- 先取证再动手。 kfed 确认盘头完好、损坏仅限单块之后,才敢走 amdu;如果先
kfed repair或重建磁盘组,证据和退路都会一起消失。 - 11.2 已停支持。 该版本对元数据块校验失败直接中止 mount,不会用冗余副本自愈,恢复难度显著高于 12c+。
待核对
- 环境表中的 PSU 版本、内存容量、磁盘数量来自原文图片,若用于对外发布请与 CMDB 核对。
- "56 个数据文件"与 +DATA 中实际文件数需按
v$datafile核对;文中 RENAME 示例只列出一个文件。 kfed repair的适用范围以目标版本官方文档为准,本文按原文表述保留。
原文首发于微信公众号「止水研习社」。

文章评论