CPU 持续高位、业务查询变慢,最常见的组合不是「服务器不够」,而是几条 SQL 在做全表扫描和大规模哈希连接。加 CPU 只能把故障推迟,找到那几条 SQL 才能解决。
排查顺序是固定的:先确认是数据库在烧 CPU 还是主机上别的进程,再定位到会话和 SQL_ID,再看执行计划确认扫描方式和连接方式,最后才谈索引和改写。跳过前面几步直接加索引,很容易建了一堆用不上的索引,写入反而更慢。
下面是一次完整的压测复现和优化过程。环境是千万级订单大表,已有主键和常规单字段索引,多会话并发执行同一类业务查询,复现出 CPU 打满、响应变慢的现象。
一、先复现问题
压测表是 hruser.ord_big_table,千万级数据,配置了主键以及 create_time、status、cust_id 上的单字段索引,接近真实生产结构。用多个会话并发执行订单查询,观察主机 CPU 和数据库等待。

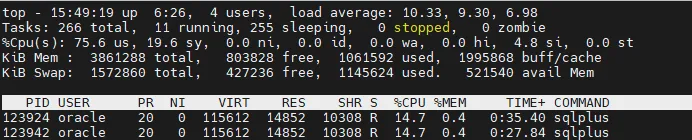
现象很典型:CPU 使用率随并发数线性上升,没有明显 I/O 瓶颈,会话状态多数是 ON CPU 而不是 WAITING。这说明数据库在做计算,不是在等磁盘。计算量来自哪里,要靠下一步的统计信息回答。
二、定位到会话
2.1 按 CPU 消耗排序会话
SELECT
    s.sid,
    s.serial#,
    s.username,
    s.sql_id,
    s.program,
    se.value cpu_used
FROM v$session s
JOIN v$sesstat se ON s.sid = se.sid
JOIN v$statname sn ON se.statistic# = sn.statistic#
WHERE sn.name = 'CPU used by this session'
ORDER BY cpu_used DESC;
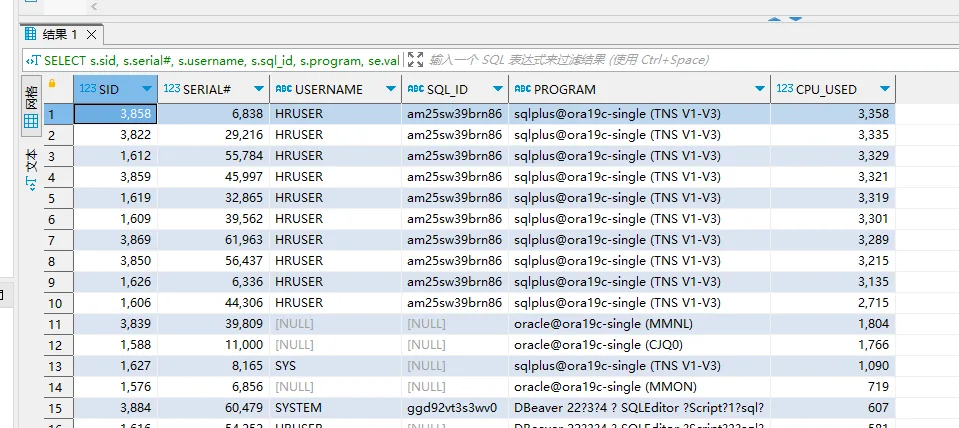
这条语句有三个细节要注意。
第一,v$sesstat 里的 CPU used by this session 是累计值,从会话建立开始累加,不是当前速率。一个跑了三天的后台会话可能排在第一,但当前并不消耗 CPU。要看增量,得采两次快照做差,或者结合 v$session.status 和 v$session.event 判断。
第二,这条语句没有行数限制,结果会返回所有会话。生产上建议加 FETCH FIRST 20 ROWS ONLY,或者先过滤 s.status='ACTIVE',否则在几百个连接的库上输出很难看。
第三,v$session 和 v$sesstat 按 sid 关联,RAC 环境要改用 gv$session 和 gv$sesstat,并带上 inst_id,否则会串实例。
2.2 拿 SQL 原文
拿到 sql_id 后:
SELECT
    sql_id,
    sql_fulltext
FROM v$sql WHERE sql_id = '&input_sql_id';
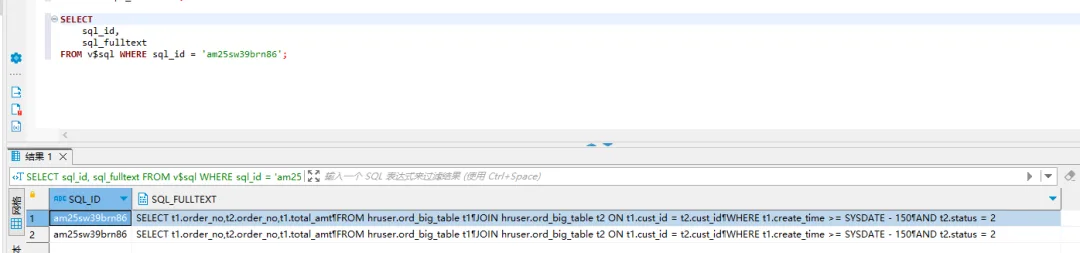
本次抓到的问题语句:
SQL_ID 是 am25sw39brn86,语句本身:
SELECT t1.order_no,t2.order_no,t1.total_amt
FROM hruser.ord_big_table t1
JOIN hruser.ord_big_table t2 ON t1.cust_id = t2.cust_id
WHERE t1.create_time >= SYSDATE - 150
AND t2.status = 2;
这条 SQL 的业务含义是「取最近 150 天内、状态为 2 的订单,按客户关联出对应的订单号」。问题在于同一张大表自关联,两个过滤条件分别落在两个别名上,没有任何一个条件能同时缩小两侧的数据集。
2.3 用 ASH 看最近 15 分钟
SELECT sql_id,COUNT(*) sample_count
FROM v$active_session_history
WHERE sample_time >= SYSDATE - INTERVAL '15' MINUTE
AND wait_class = 'ON CPU'
GROUP BY sql_id
ORDER BY sample_count DESC;
ASH 每秒采样一次活动会话,sample_count 近似等于该 SQL 占用的 CPU 秒数。这条查询回答的是「最近 15 分钟谁在烧 CPU」,比累计统计更能反映当前状态。
两个前提:一是 v$active_session_history 只保留内存中的最近部分采样,实例重启或缓冲区循环覆盖后数据会丢;二是 wait_class = 'ON CPU' 只统计 CPU 采样,如果语句在等 I/O 或等锁,要换成对应的 wait_class 或直接不过滤。
2.4 用 AWR 看历史
SELECT
    sql_id,
    executions_delta exec_cnt,
    ROUND(cpu_time_delta / 1000000,2) cpu_sec
FROM dba_hist_sqlstat
ORDER BY cpu_time_delta DESC;
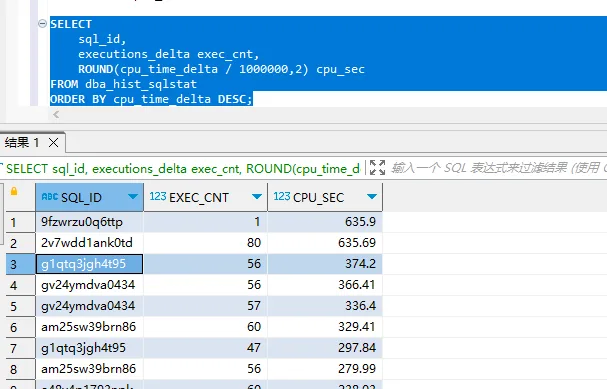
cpu_time_delta 是两次快照之间的增量,单位微秒,除以 1000000 得到秒。这条语句没有加时间范围,直接查会返回所有快照的累计值,实际使用时必须加 snap_id 或 dbid 条件,否则排序结果没有意义。
更实用的写法是按 CPU 时间降序取前 20,同时看 executions_delta。执行次数很少但 CPU 时间很高的,通常是单条大查询;执行次数很多、单次 CPU 不高的,可能是硬解析或索引设计问题。
三、看执行计划
EXPLAIN PLAN FOR
SELECT t1.order_no,t2.order_no,t1.total_amt
FROM hruser.ord_big_table t1
JOIN hruser.ord_big_table t2 ON t1.cust_id = t2.cust_id
WHERE t1.create_time >= SYSDATE - 150
AND t2.status = 2;

SELECT * FROM TABLE(DBMS_XPLAN.DISPLAY());
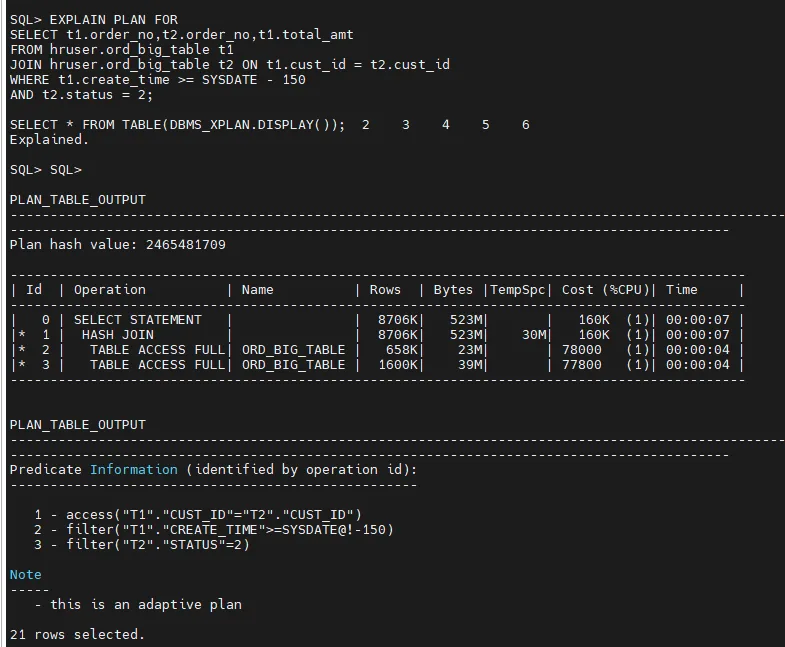
计划主体:
Id | Operation         | Name
---|-------------------|--------------
0  | SELECT STATEMENT  |
1  | HASH JOIN         |
2  | TABLE ACCESS FULL | ORD_BIG_TABLE  -- t1全表扫描
3  | TABLE ACCESS FULL | ORD_BIG_TABLE  -- t2全表扫描
计划解读:
1、两张千万级表全部走 TABLE ACCESS FULL 全表扫描,
然后做HASH JOIN哈希连接。

2、Cost 达到 160K,TempSpc 临时空间消耗 30M,预估返回 87 万行。

3、Predicate:过滤条件t1.create_time>=SYSDATE‑150、
t2.status=2是全表扫描完成之后才过滤,没有利用索引提前过滤数据。

4、自适应执行计划adaptive plan,
两张大表读取大量数据放入内存做哈希匹配,
CPU、逻辑读很高,就是 CPU 高故障现象。
现状是:create_time、status、cust_id 上都有单字段索引,但优化器没有用,直接选了两次全表扫描。原因不复杂。
单字段索引只能过滤一个条件。用 create_time 索引,能筛出最近 150 天的行,但查询还要 order_no、total_amt、cust_id,每一行都得回表;回表的随机 I/O 在千万级表上代价很高。用 status 索引,status=2 的选择性可能很差,回表的行数更多。优化器算完成本,认为全表扫描加哈希连接更便宜,于是放弃了索引。
这不是优化器选错,是索引结构不支持这种查询。索引里没有查询需要的列,回表成本就把索引的优势吃掉了。
四、建复合覆盖索引
4.1 索引列的顺序
列顺序没有一条万能公式,按三个约束排:过滤列在前,等值条件优先于范围条件;范围列之后的列不能再做精确过滤,但可以用于覆盖;连接列要紧跟过滤列,返回列放最后。
-- t1驱动表:where条件(create_time) + join关联字段(cust_id) + 查询返回字段(order_no,total_amt)

CREATE INDEX hruser.idx_ord_t1_join ON hruser.ord_big_table(create_time, cust_id, order_no, total_amt);

-- t2被驱动表:where条件(status) + join关联字段(cust_id) + 查询返回字段(order_no)

CREATE INDEX hruser.idx_ord_t2_join ON hruser.ord_big_table(status, cust_id, order_no);
两个索引的差别来自各自的过滤条件。
idx_ord_t1_join 以 create_time 打头,因为它是范围条件(>=),范围列后面的列不能再用索引做精确查找,但可以随索引一起返回,避免回表。cust_id 放在第二位,用于连接;order_no 和 total_amt 放在最后,纯粹是为了覆盖查询列。
idx_ord_t2_join 以 status 打头,它是等值条件;cust_id 第二位用于连接;order_no 第三位用于返回。
覆盖的意思是:查询需要的所有列都在索引里,执行计划出现 INDEX RANGE SCAN 后不再有 TABLE ACCESS BY INDEX ROWID。代价是索引变大,DML 时要维护更多列。total_amt 这种会频繁更新的金额列放进索引,更新成本要提前评估。
4.2 刷新统计信息
EXEC DBMS_STATS.GATHER_TABLE_STATS(OWNNAME=>'HRUSER',TABNAME=>'ORD_BIG_TABLE',CASCADE=>TRUE);
新索引建完,优化器不一定立刻知道。虽然索引创建时会收集索引统计,但表级统计和列分布没变,成本估算仍可能按旧信息走。手动收集一次,让优化器看到新的访问路径。
生产上不要对大表随便跑全量收集,尤其是有 CASCADE=>TRUE 时会连带收集索引统计。更稳妥的做法是用 DBMS_STATS.GATHER_TABLE_STATS 配合 DEGREE 和 ESTIMATE_PERCENT,在维护窗口执行,并先确认没有正在运行的统计收集任务。
4.3 改写 SQL:先过滤,再关联
索引只是提供路径,SQL 写法决定了优化器能不能用上。原语句的两个过滤条件分别写在两个别名上,优化器需要先做连接再过滤。改成两个子查询各自过滤,数据集在连接前就缩小了:
set time on
set timing on
EXPLAIN PLAN FOR
SELECT t1.order_no,t2.order_no,t1.total_amt
FROM (
    SELECT cust_id,order_no,total_amt
    FROM hruser.ord_big_table
    WHERE create_time >= SYSDATE - 150
) t1
INNER JOIN (
    SELECT cust_id,order_no
    FROM hruser.ord_big_table
    WHERE status = 2
) t2
ON t1.cust_id = t2.cust_id;
SELECT * FROM TABLE(DBMS_XPLAN.DISPLAY());
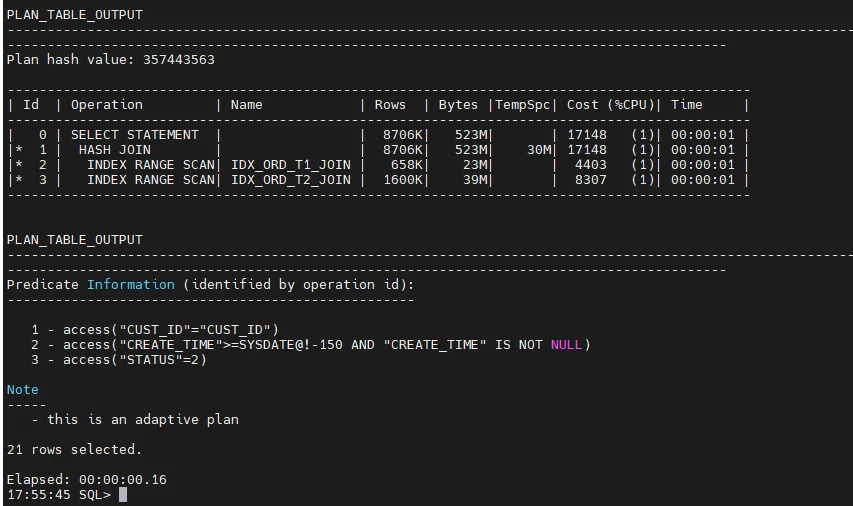
优化后的预期变化:
不再出现TABLE ACCESS FULL,替换为 INDEX RANGE SCAN索引范围扫描;

索引直接拿到全部需要字段,无回表(Index‑Only 访问);

参与 Hash Join 的行数大幅下降,Cost、TempSpc 临时空间显著降低;

过滤条件在索引扫描阶段完成,不是扫描完整大表之后再过滤。
这里要注意,子查询写法本身不保证一定走索引。优化器可能会做子查询展开(subquery unnesting),把两个子查询合并回原来的连接形式。如果展开后成本仍然指向全表扫描,可以临时加 /*+ no_unnest */ 或者用 MATERIALIZE 提示验证,但生产上不建议长期固定 hint。
4.4 hint 只用于验证
SELECT /*+ index(t1 idx_ord_t1_join) index(t2 idx_ord_t2_join) */
t1.order_no,t2.order_no,t1.total_amt
FROM (
    SELECT cust_id,order_no,total_amt
    FROM hruser.ord_big_table
    WHERE create_time >= SYSDATE - 150
) t1
INNER JOIN (
    SELECT cust_id,order_no
    FROM hruser.ord_big_table
    WHERE status = 2
) t2
ON t1.cust_id = t2.cust_id;
hint 的作用是验证「走索引到底快不快」。如果加了 hint 变快,说明是成本估算问题,应该去修统计信息或调整索引,而不是把 hint 写进代码。如果加了 hint 反而更慢,说明索引设计不对,回表或索引扫描的成本确实高于全表扫描。
所以 hint 只用于定位问题,不写进生产代码。它会把手里的执行计划锁死在某个版本,数据分布变化、索引重建、版本升级之后,原来的 hint 可能变成性能炸弹。
五、验证效果
优化后重新压测,观察三个层面:
数据库层:v$sesstat 的 CPU 增量下降,v$sysstat 的 'CPU used by this system' 增速放缓,
         'session logical reads' 总量下降。
语句层:v$sql 中该 sql_id 的 CPU_TIME、BUFFER_GETS、DISK_READS 下降,
        执行计划从 TABLE ACCESS FULL 变为 INDEX RANGE SCAN。
主机层:CPU 使用率回落,run queue 下降,业务响应时间恢复。

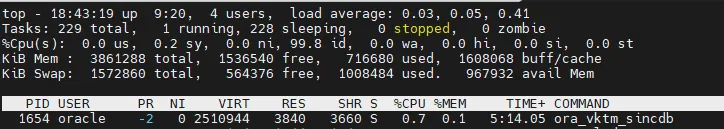
验证时不要只看一次采样。CPU 曲线有波动,至少观察一个完整的业务周期,确认高峰时段也稳定。同时用 v$sql 确认执行计划真的变了,而不是因为缓存了旧计划、或者压测数据量变化导致偶然变快。
六、同类低效写法
常见的同类问题,在这个案例里都能对应上:
- 索引列上做函数运算,比如
to_char(create_time,'yyyymmdd') = '20260101',索引失效。改写条件或建函数索引。 - 左模糊匹配
like '%xxx',B 树索引无法定位起点,只能全扫。能改成右模糊就改,不能改就考虑全文索引或外部检索。 OR条件跨多个列,优化器可能放弃索引。可以拆成UNION ALL,或者确认各分支都能走索引。- 大表自关联,两边都没有 Selective 的过滤条件,哈希连接的数据量是乘积级。
UNION去重,排序开销大。确认业务允许重复时改成UNION ALL。- 深度分页
order by ... offset N rows fetch next M,N 很大时要扫描并丢弃前 N 行。用游标分页或基于上次最大 ID 的键集分页。 DISTINCT对大结果集去重,本质是一次排序或哈希。先确认重复是不是连接放大造成的,从根上消除。
这些写法的共同点是让数据库做多余的中间计算。索引能解决访问路径,改写能减少计算量,两者要一起做。
七、容易踩空的几个点
第一,索引建完不等于立刻生效。执行计划有缓存,v$sql 里的旧计划可能还在用。可以用 DBMS_SHARED_POOL.PURGE 清掉单条游标,或者在测试环境重新解析验证。生产上不要为了看新计划去 flush shared pool,那会让所有 SQL 重新硬解析,CPU 反而更高。
第二,覆盖索引不是列越多越好。每多一列,索引块就多一份,扫描的字节数也增加。total_amt 这种宽列如果更新频繁,维护成本可能超过收益。评估方法是比较优化前后的 buffer_gets 和 disk_reads,不只看执行时间。
第三,统计信息过期会让新索引白建。表数据量从百万涨到千万,num_rows 还是旧值,优化器算出的回表成本偏低或偏高,都可能选错路径。大表建议锁定统计信息或使用增量统计,避免每次全量收集。
第四,压测环境和生产环境的差异要交代清楚。数据分布、绑定变量窥探、并行度、optimizer_mode 都会影响计划。压测里走索引,生产上不一定走;反过来也一样。
八、要点
- 先分清 CPU 高还是等待高。
ON CPU占主导才是计算问题,WAITING占主导要查 I/O、锁和网络。 v$sesstat是累计值,必须做差或结合会话状态看,不能直接排序下结论。- ASH 看当前热点,AWR 看历史趋势,两者互补,不能只用其中一个。
- 单字段索引在「过滤 + 返回多列」的查询上容易被优化器放弃,原因是回表成本。
- 复合覆盖索引的列顺序:等值条件、范围条件、连接列、返回列。范围列之后的列不能用于精确过滤,但可以用于覆盖。
- 改写 SQL 让过滤发生在连接之前,比单纯加索引更有效。
- hint 用来验证,不要用来上线。执行计划要稳定,靠统计信息和索引设计,不靠提示。
- 优化后必须验证执行计划确实改变,并观察完整业务周期。
待核对
- 原文执行计划只给了三行摘要,完整的
DBMS_XPLAN输出(含Cost、TempSpc、Predicate信息)在图片中,本文按原文文字描述保留,未补全计划细节。 Cost 160K、TempSpc 30M、预估返回 87 万行均来自原文环境,换环境后数值会不同。- 原文 2.4 的 AWR 查询没有时间过滤条件,直接执行会返回全部快照的累计值,本文已提示需要加
snap_id或dbid。 - 原文提到的「千万级生产模拟订单大表」是压测环境,不是真实生产库,结论迁移时需重新验证。
- 索引名
idx_ord_t1_join、idx_ord_t2_join和表名ord_big_table为原文所有,实际建索引前需确认命名规范和不与现有索引重复。
原文首发于微信公众号「止水研习社」。

文章评论