这是一次"容灾看起来一直在,实际早就没了"的故障。主库 10-01 09:40 存储控制器故障,DBA 按惯例准备切换,才发现备库的 apply lag 已经 21 小时 07 分、GAP 41 个序列、传输目的地状态是 ERROR / ORA-16191。再往前翻,传输在 09-26 04:30 就断了,中间 5 天没有任何人收到有效告警。
根因不复杂:安全平台在 09-26 02:00 轮换了 SYS 口令,而 01:30 值班脚本按月度备份窗口把 LOG_ARCHIVE_DEST_STATE_2 置成了 DEFER,口令变更的 redo 没能传到备库;04:30 备份结束、脚本恢复 ENABLE 时,主库用新口令、备库用旧密码文件,认证直接失败。之后的 5 天里,DG 巡检脚本把 apply lag 标为 P4,安全平台把"备库口令仍是旧强度"生成了低优先级工单,两条救命信号都被搁置。
本文按时间线、现象、13 分钟决策、ORA-16191 原理、双端取证、修复与改进项展开。环境为 Oracle 19.3.0.0 + RU 19.21 单机主库 + 同城物理备库,无 Broker,LGWR ASYNC。
故障概览
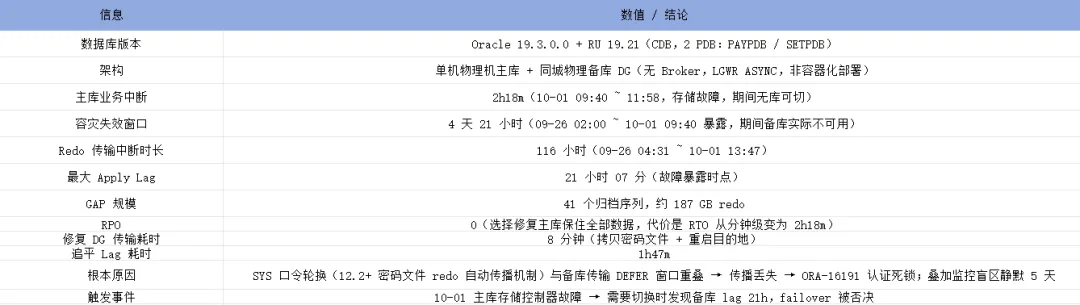
| 项目 | 数值 / 结论 |
|---|---|
| 数据库版本 | Oracle 19.3.0.0 + RU 19.21(CDB,2 PDB:PAYPDB / SETPDB) |
| 架构 | 单机物理主库 + 同城物理备库 DG(无 Broker,LGWR ASYNC;原文"非容器化部署"指非 Docker/K8s,非 CDB 含义) |
| 主库业务中断 | 2h18m(10-01 09:40 ~ 11:58,存储故障,期间无库可切) |
| 容灾失效窗口 | 09-26 02:00 ~ 10-01 09:40(原文记 4 天 21 小时,见文末待核对),期间备库实际不可用 |
| Redo 传输中断时长 | 09-26 04:31 ~ 10-01 13:47(原文记 116 小时,见文末待核对) |
| 最大 Apply Lag | 21 小时 07 分(故障暴露时点) |
| GAP 规模 | 41 个归档序列,约 187 GB redo |
| RPO | 0(选择修复主库保住全部数据,代价是 RTO 从分钟级变为 2h18m) |
| 修复 DG 传输耗时 | 8 分钟(拷贝密码文件 + 重启目的地) |
| 追平 Lag 耗时 | 1h47m |
| 根本原因 | SYS 口令轮换(12.2+ 密码文件 redo 自动传输机制)与备库传输 DEFER 窗口重叠 → 传输丢失 → ORA-16191 认证死锁;叠加监控盲区静默 5 天 |
| 触发事件 | 10-01 主库存储控制器故障 → 需要切换时发现备库 lag 21h,failover 被拒 |
环境架构
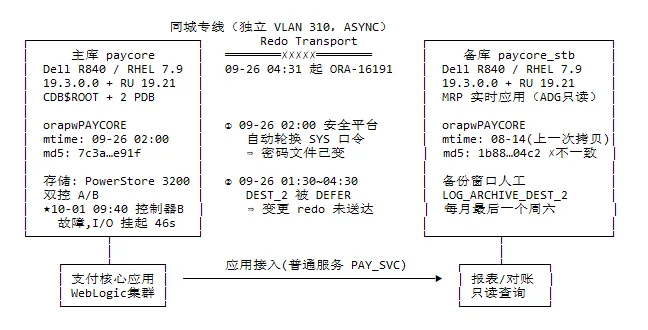
主库 paycore 与备库 paycore_stb 之间是同城专线(独立 VLAN 310,ASYNC)。主库侧密码文件 orapwPAYCORE 的 mtime 是 09-26 02:00,md5 为 7c3a..e91f;备库侧 mtime 是 08-14 11:22,md5 为 1b88..04c2,两端不一致。
备库的归档目的地配置为 LOG_ARCHIVE_DEST_2,备份窗口由人工脚本控制;"每月最后一个周六"做一次密码文件手工同步,这就是备库文件停留在 8 月 14 日的原因。
故障时间线
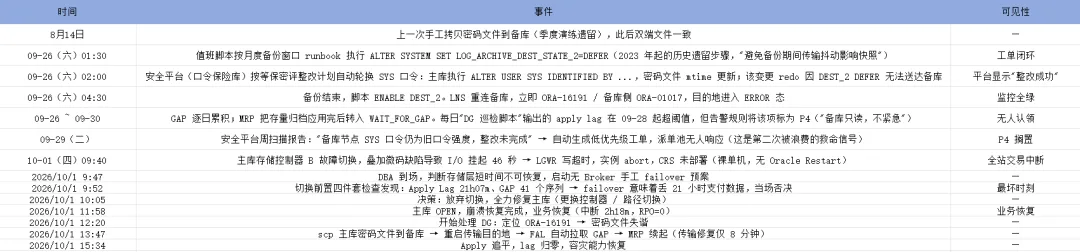
| 时间 | 事件 | 可见性 |
|---|---|---|
| 8 月 14 日 | 上一次手工拷贝密码文件到备库(季度演练遗留),此后双端文件一致 | — |
| 09-26(六)01:30 | 值班脚本按月度备份窗口 runbook 执行 ALTER SYSTEM SET LOG_ARCHIVE_DEST_STATE_2=DEFER(2023 年起的历史遗留步骤,"避免备份期间传输抖动影响快照") | 工单闭环 |
| 09-26(六)02:00 | 安全平台(口令保险库)按等保密评整改计划自动轮换 SYS 口令:主库执行 ALTER USER SYS IDENTIFIED BY ...,密码文件 mtime 更新;该变更 redo 因 DEST_2 DEFER 无法送达备库 | 平台显示"整改成功" |
| 09-26(六)04:30 | 备份结束,脚本 ENABLE DEST_2;LNS 重连备库,立即 ORA-16191 / 备库侧 ORA-01017,目的地进入 ERROR 态 | 监控全绿 |
| 09-26 ~ 09-30 | GAP 逐日累积;MRP 把存量归档应用完后转入 WAIT_FOR_GAP。每日"DG 巡检脚本"输出的 apply lag 在 09-28 起超阈值,但告警规则将该项标为 P4("备库只读,不紧急") | 无人认领 |
| 09-29(二) | 安全平台周扫描报告:"备库节点 SYS 口令仍为旧口令强度,整改未完成" → 自动生成低优先级工单,派单池无人响应(这是第二次被浪费的救命信号) | P4 搁置 |
| 10-01(四)09:40 | 主库存储控制器 B 故障切换,叠加微码缺陷导致 I/O 挂起 46 秒 → LGWR 写超时,实例 abort,CRS 未部署(裸单机,无 Oracle Restart) | 全站交易中断 |
| 2026/10/1 9:47 | DEA 到场,判断存储短时间不可恢复,启动无 Broker 手工 failover 预案 | — |
| 2026/10/1 9:52 | 切换前置四件套检查发现:Apply Lag 21h07m、GAP 41 个序列 → failover 意味着丢 21 小时支付数据,当场否决 | 最坏时刻 |
| 2026/10/1 10:05 | 决策:放弃切换,全力修复主库(更换控制器 / 路径切换) | — |
| 2026/10/1 11:58 | 主库 OPEN,崩溃恢复完成,业务恢复(中断 2h18m,RPO=0) | 业务恢复 |
| 2026/10/1 12:20 | 开始处理 DG:定位 ORA-16191,备库 alert 对应 ORA-01017 | — |
| 2026/10/1 13:47 | scp 主库密码文件到备库 → 重启传输目的地 → FAL 自动拉取 GAP → MRP 续起(传输修复仅 8 分钟) | — |
| 2026/10/1 15:34 | Apply 追平,lag 归零,容灾能力恢复 | — |
故障现象
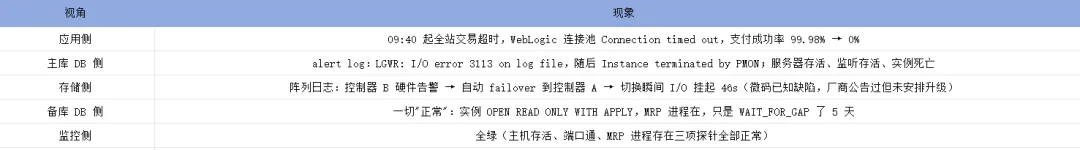
| 视角 | 现象 |
|---|---|
| 应用侧 | 09:40 起全站交易超时,WebLogic 连接池 Connection timed out,支付成功率 99.98% → 0% |
| 主库 DB 侧 | alert log: LGWR: I/O error 3113 on log file,随后 Instance terminated by PMON;服务器存活、监听存活、实例死亡 |
| 存储侧 | 阵列日志:控制器 B 硬件告警 → 自动 failover 到控制器 A → 切换瞬间 I/O 挂起 46s(微码已知缺陷,厂商公告过但未安排升级) |
| 备库 DB 侧 | 一切"正常":实例 OPEN READ ONLY WITH APPLY,MRP 进程在,只是 WAIT_FOR_GAP 了 5 天 |
| 监控侧 | 全绿(主机存活、端口通、MRP 进程存在三项探针全部正常) |
这份表最值得记住的是最后两行:备库"看起来正常",监控"看起来全绿"。进程存活和端口连通,无法证明数据在流动。
应急响应与决策
13 分钟切换决策
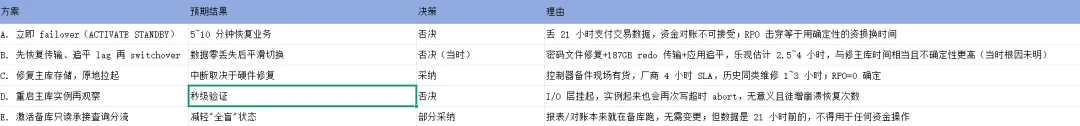
09:47 DEA 到场,09:52 拿到切换前置检查结果,10:05 定案。从"发现无库可切"到"决定修主库"是 13 分钟,评估了五个方案:
| 方案 | 预期结果 | 决策 | 理由 |
|---|---|---|---|
| A. 立即 failover(ACTIVATE STANDBY) | 5~10 分钟恢复业务 | 否决 | 丢 21 小时支付交易数据,资金对账不可接受;RPO 击穿等于用确定性的资损换时间 |
| B. 先恢复传输、追平 lag 再 switchover | 数据零丢失后平滑切换 | 否决(当时) | 密码文件修复 + 187GB redo 传输 + 应用追平,乐观估计 2.5~4 小时,与修主库时间相当且不确定性更高(当时根因未明) |
| C. 修复主库存储,原地拉起 | 中断取决于硬件修复 | 采纳 | 控制器备件现场有货,厂商 4 小时 SLA,历史同类维修 1~3 小时;RPO=0 确定 |
| D. 重启主库实例再观察 | 秒级验证 | 否决 | I/O 层挂起,实例起来也会再次写超时 abort,无意义且徒增崩溃恢复次数 |
| E. 激活备库只读承接查询分流 | 减轻"全盲"状态 | 部分采纳 | 报表/对账本来就在备库跑,无需变更;但数据是 21 小时前的,不得用于任何资金操作 |
复盘结论:方案 C 是当时约束下的正确选择(实际中断 2h18m,优于 B 的不确定性),但它"正确"得极其侥幸,如果主库是数据文件级损坏而非控制器故障,修复时间将不可控。真正的问题不是决策质量,而是 5 天前就没有退路了。
无 Broker 时手工 failover 的顺序
这次因为 lag 太大没有执行,但顺序值得固定下来,避免下次临场翻文档:
1. 确认主库确实不可恢复(或修复时间超出 RTO)
2. 在备库查 v$dataguard_stats、v$archive_gap、v$archive_dest
3. 评估 GAP 对应的业务数据能否接受丢失,形成书面结论
4. 停止应用写入,冻结所有指向主库的连接
5. 备库取消 MRP:ALTER DATABASE RECOVER MANAGED STANDBY DATABASE CANCEL;
6. 应用完已收到的归档:ALTER DATABASE RECOVER MANAGED STANDBY DATABASE FINISH;
7. 激活:ALTER DATABASE ACTIVATE STANDBY DATABASE;
8. 打开:ALTER DATABASE OPEN;
9. 校验数据字典、业务对账,再切连接串
第 3 步是唯一不能由 DBA 单独决定的环节。本例 21 小时的支付数据,任何"先切了再说"的方案都过不了资金对账这一关。
主库恢复后 DG 修复
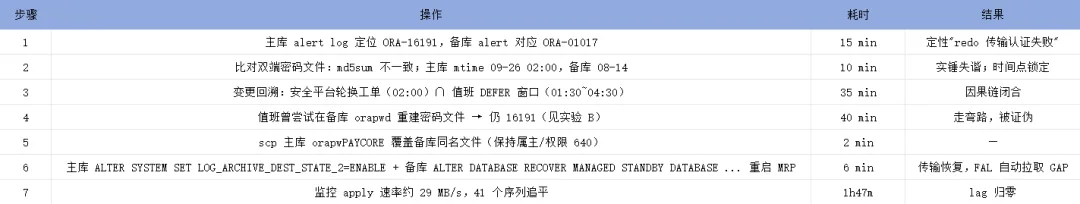
12:20 到 15:34 的修复过程:
| 步骤 | 操作 | 耗时 | 结果 |
|---|---|---|---|
| 1 | 主库 alert log 定位 ORA-16191,备库 alert 对应 ORA-01017 | 15 min | 定性"redo 传输认证失败" |
| 2 | 比对双端密码文件:md5sum 不一致;主库 mtime 09-26 02:00,备库 08-14 | 10 min | 实锤失谐;时间点锁定 |
| 3 | 变更回溯:安全平台轮换工单(02:00)∩ 值班 DEFER 窗口(01:30~04:30) | 35 min | 因果链闭合 |
| 4 | 值班曾尝试在备库 orapwd 重建密码文件 → 仍 16191(原因见第 3 步) | 40 min | 走弯路,被证伪 |
| 5 | scp 主库 orapwPAYCORE 覆盖备库同名文件(保持属主/权限 640) | 2 min | — |
| 6 | 主库 ALTER SYSTEM SET LOG_ARCHIVE_DEST_STATE_2=ENABLE + 备库 ALTER DATABASE RECOVER MANAGED STANDBY DATABASE ... 重启 MRP | 6 min | 传输恢复,FAL 自动拉取 GAP |
| 7 | 监控 apply 速率约 29 MB/s,41 个序列追平 | 1h47m | lag 归零 |
排查过程
第 1 步:故障定界——主库还能不能救
# 主机层:存活,负载正常
uptime && multipath -ll | grep -i failed
# 存储链路层:8 条路径中 4 条 failed(控制器 B 路径全灭)

# 数据库层:实例死亡,alert log 末尾
tail -100 alert_PAYCORE.log | grep -E "error|terminated"
输出:故障域在存储控制器,DB 是受害者。转入"切换 or 修复"决策(见"应急响应与决策"一节)。
第 2 步:无 Broker 手工切换前置四件套
-- 备库 lag 三兄弟(无 Broker 下唯一的真相来源)
SELECT name, value, unit FROM v$dataguard_stats;
-- transport lag: 21:07:33   ← 爆了
-- apply lag:     21:07:31

-- GAP 清单
SELECT * FROM v$archive_gap ORDER BY thread#, low_sequence#;
-- 41 行:LOW_SEQUENCE# 4281 ~ HIGH_SEQUENCE# 4342

-- 传输目的地状态
SELECT dest_id, status, error FROM v$archive_dest WHERE dest_id=2;
-- STATUS=ERROR, ERROR='ORA-16191'   ← 凶手名字第一次出现

-- 备库打开模式
SELECT open_mode, database_role FROM v$database;
-- READ ONLY WITH APPLY / PHYSICAL STANDBY
输出:切换不可行。转修复主库;同时 ORA-16191 立项为第二故障单并行排查。
这四件套应该在每次切换前无条件执行。没有 Broker 时,v$dataguard_stats 和 v$archive_gap 是唯一能证明"备库可用"的证据;v$archive_dest 的 STATUS 只能说明当前状态,不能说明过去 5 天发生过什么。
第 3 步:ORA-16191 的认证链路
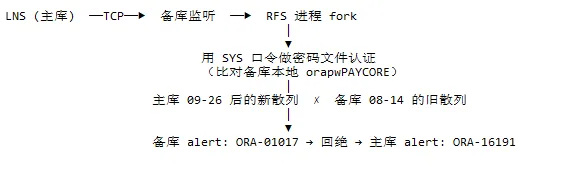
认证发生在备库的监听进程里:
LNS(主库) --TCP--> 备库监听 --> RFS 进程 fork
                                  |
                        用 SYS 口令做密码文件认证
                        (比对备库本地 orapwPAYCORE)
                                  |
                    主库 09-26 后的新散列 × 备库 08-14 的旧散列
                                  |
                        备库 alert: ORA-01017 → 回绝 → 主库 alert: ORA-16191
关键认知:认证用的是"备库本地的密码文件",口令本身不跨网络传输。所以修复方向只有一个:让备库文件内容与主库一致。与"再改一次密码""重启监听""重启 MRP"全部无关。
值班在备库用 orapwd 重建密码文件的尝试同样失败。原文没有记录失败的具体原因;从机制上说,密码文件认证比对的是文件内的 verifier,重建时必须与主库当前的 verifier 完全一致(含大小写敏感设置与条目集合),任何偏差都会继续 ORA-16191。因此可靠做法只有从主库整文件拷贝,而不是在备库重建。
第 4 步:双端取证——时间戳即供词
# 主库
ls -l $ORACLE_HOME/dbs/orapwPAYCORE
# -rw-r----- 1 oracle oinstall 7680 Sep 26 02:00   ← 安全平台轮换时刻

# 备库
ls -l $ORACLE_HOME/dbs/orapwPAYCORE
# -rw-r----- 1 oracle oinstall 7680 Aug 14 11:22   ← 上一次手工拷贝

md5sum orapwPAYCORE   # 双端不一致
两个 mtime 相差 43 天,正好把"上一次同步"和"这一次轮换"钉在时间轴上。
修复步骤
1. 修复主库存储(控制器更换 + 路径恢复),实例拉起,崩溃恢复完成,RPO=0。
2. 文件级拷贝密码文件:scp orapwPAYCORE paycore_stb:$ORACLE_HOME/dbs/(保持 640/oracle:oinstall),严禁在备库 orapwd 重建。
3. ENABLE DEST_2 + 重启 MRP,FAL 自动补 41 个 GAP 序列,1h47m 追平。
4. 追平后执行一次手工 switchover 演练验证(含反向传输认证),双向均通。
具体命令:
# 主库:确认目的地状态
sqlplus -s / as sysdba <<'EOF'
SELECT dest_id, status, error FROM v$archive_dest WHERE dest_id=2;
EOF

# 主库:恢复传输
sqlplus -s / as sysdba <<'EOF'
ALTER SYSTEM SET LOG_ARCHIVE_DEST_STATE_2=ENABLE;
ALTER SYSTEM SWITCH LOGFILE;
EOF

# 备库:确认文件一致后重启 MRP
md5sum $ORACLE_HOME/dbs/orapwPAYCORE
sqlplus -s / as sysdba <<'EOF'
ALTER DATABASE RECOVER MANAGED STANDBY DATABASE DISCONNECT FROM SESSION;
EOF
注意 LOG_ARCHIVE_DEST_STATE_2=ENABLE 只是打开目的地,不会自动补历史 GAP;补 GAP 依赖 FAL(Fetch Archive Log)机制,由备库向主库请求缺失序列。如果 v$archive_gap 长时间不收敛,再检查 FAL_SERVER / FAL_CLIENT 参数。
改进项
- 禁止在备份窗口 DEFER 传输。 这条 2023 年留下的 runbook 步骤,收益是"备份快照不抖动",代价是把容灾窗口变成了盲区。备份应使用
BACKUP ... NOT BACKUP或独立通道,而不是停传输。 - apply lag 告警从 P4 提到 P1/P2。 备库只读不等于不紧急;lag 超过 30 分钟就应升级。
- 监控探针改为"数据在动"。 主机存活、端口通、MRP 进程存在,这三项全部通过也可能 5 天没传一条日志。应直接采集
v$dataguard_stats的 apply lag 与v$archive_dest的 error。 - 口令轮换必须纳入 DG 变更清单。 12.2+ 的密码文件 redo 自动传输只在目的地 ENABLE 时有效;轮换前检查 DEST 状态,轮换后立即核对双端
md5sum。 - 每月密码文件同步改为每次口令变更后同步。 固定周期同步无法覆盖窗口外的变更。
- 季度做一次真实 switchover 演练。 演练要包含反向传输认证,否则只验证了单向。
待核对
- 原文概览表记"Redo 传输中断时长 116 小时",但按同一行给出的 09-26 04:31 ~ 10-01 13:47 计算,实际为 129 小时 16 分。两者不一致,正文保留原始时间戳,未改写数字。
- 原文概览表记"容灾失效窗口 4 天 21 小时",按 09-26 02:00 ~ 10-01 09:40 计算为 4 天 7 小时 40 分。差异原因不明,发布前请以监控原始数据核对。
- "187 GB redo / 41 个序列 / 29 MB/s"来自原文与监控截图,实际值以
v$archived_log汇总为准。 - 概览表同时出现"CDB,2 PDB"与"非容器化部署",按上下文理解为"非 Docker/K8s 部署",不是 non-CDB;发布前请与原文作者确认。
- 存储微码版本号原文未给出具体值,只说明"厂商公告过但未安排升级";对外发布前建议补型号与微码版本。
原文首发于微信公众号「止水研习社」。

文章评论