企业的权限设计最初都是给人用的。一个高级工程师可能有部署生产、查敏感库、撤别人权限的资格。这些权限当然有风险,但传统上风险被两个假设限制住了:人会停下来想,人的操作速度有上限。
AI 智能体把这两个假设都打破了。决策是非确定性的,而且它可以不疲倦、不休息地重复同一个动作。一个看似合理实则错误的判断,在人反应过来之前,可能已经执行了上万次。
Cloudflare One 最近推出的几项能力,就是冲这个来的:识别经过审查的 MCP 流量、显示是哪些用户和服务器产生了这些流量、对托管网络路径上的直连进行管控。配合 MCP Server Portals,管理员能看清智能体到底走的是批准过的路径,还是绕过了防护。
MCP 为什么难管
MCP 给智能体提供了一种通用方式,去探索和调用第三方 SaaS、内部应用和 API 支持的工具。权限逻辑本身不新鲜,变的是「谁来做出每一次决策」,以及「一个错误决策能扩散多快」。
把智能体接上这些工具,可能只需要一行配置。员工可以把 Claude Code、Codex、Cursor、OpenCode、VS Code 或任何 AI 框架指向一个 MCP 服务器,完全不需要检查它有没有被批准。
而这些流量没有明显的形状。MCP 不要求固定主机名,也不要求路径里带 /mcp,一次直连看起来和任何普通的 HTTPS API 调用没有区别。
一次工具调用长什么样
同一个 MCP 工具调用,在系统里传输时有三种形态:客户端内部,它是「用一组参数调用某个工具」的决策;网络层,它是一次携带 JSON-RPC 消息的 HTTP 事务;服务端,它变成对工具处理程序的调用,这个程序可能读数据、改状态、或者执行别的动作。
以一个想查奥斯汀天气的智能体为例,一个远程 MCP 请求大致是这样:
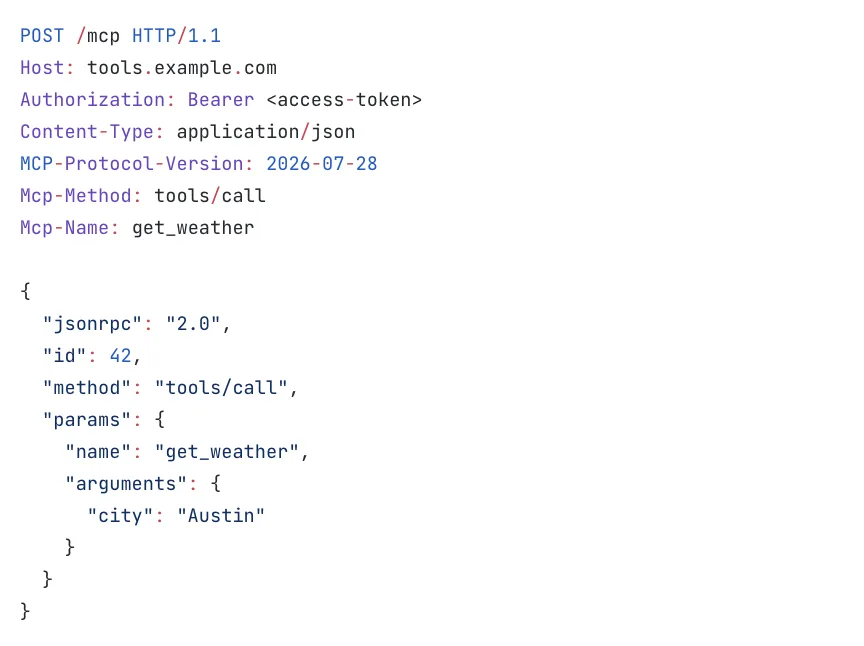
这个请求里封装了几个有价值的信号:
- 主机名与路径:标识目标地址。
- Authorization 头:服务端需要认证时携带的凭证。
- MCP-Protocol-Version 头:标识协议版本。
- Mcp-Method 与 Mcp-Name 头:在无状态协议里直接暴露操作类型和工具名。
- JSON-RPC 外壳:重复请求方法、给请求一个 ID 用于匹配响应、在 params 里带工具参数。
参数是其中最敏感的部分。它可能包含搜索词、源代码、客户数据,或者针对具体操作的指令(建工单、改基础设施)。工具名说明智能体想调什么功能,参数说明它会发什么数据、希望服务端做什么。
调用成功,服务端返回一个同 ID 的 JSON-RPC 响应,附带执行结果,这个响应同样可能含敏感数据。审请求能在隐患执行前拦住;审响应并记日志,能看清工具最终把什么数据交给了智能体。
三个可以下手的位置
客户端内部。 Hook 可以在模型选好工具之后、客户端序列化请求之前运行。这个阶段不用解密流量就能看到目标服务器、工具名和参数。它可以拒绝不在白名单上的服务器、要求用户确认敏感操作、或者在数据离开设备前把参数里的敏感内容删掉。它还能覆盖本地 stdio 服务器——这类服务器根本不产生网络流量。
问题是标准化。安全团队要让这套策略生效,得在员工用的每一个客户端上复刻一遍。客户端管控在「同时管客户端和设备」的组织里效果最好,但单一客户端的遥测永远拼不出完整的 MCP 使用清单。
设备的网络边界。 安全 Web 网关在 HTTP 请求离开客户端后观察。通过 TLS 解密,它能把请求和具体用户、设备关联起来,检查目标地址和协议头,不依赖特定的 MCP 客户端就能施加策略。
网络层拥有托管路径上最广的视野,能识别出绕过 Portal 直连外部服务器的行为,并在请求到达前拦截。在有 DLP 的环境里,代理还能进一步检查 JSON-RPC 方法和参数里的敏感数据。代价是它看不到本地 stdio 调用,也看不到不经过网络的流量。
服务器调用工具之前。 服务器有最丰富的执行上下文:它已经完成了身份验证、解析了 MCP 消息、把 get_weather 映射到具体处理函数、并按输入 Schema 校验了参数。这是工具真正运行前最后一个拒绝机会。
Agents SDK 的处理程序或类似的中间件,可以针对特定工具授权调用方、限流、检查参数、记录结果。这些检查必须在调用处理程序之前做,尤其是会写数据或触发外部动作的工具。执行完再记日志,只能解释发生了什么,阻止不了它发生。
Cloudflare 内部 MCP 服务器普遍用了这个模式,叫 WriteGuard。每个工具有风险等级和启用状态,读请求原样放行,允许的写请求加上智能体属性归因和审计事件,临界动作在处理程序运行前直接拦掉。因为逻辑在服务端,终端用户换客户端或者关掉本地 Hook 都绕不过去。
三者协同:客户端和服务器有最深的请求视角,网络层有最广的覆盖。组合起来能在数据离开设备前拦截、发现未受管的 MCP 流量、在工具执行前拒绝未授权操作。
怎么把 MCP 流量从 HTTPS 里认出来
网络管控点的覆盖面最广,但它首先得把 MCP 流量和普通 HTTPS 区分开。靠 URL 匹配不行:一个 MCP 服务器完全可能挂在任意路径上,用主机名或 /mcp 后缀判断会漏掉大量部署。反过来,主机名或路径里恰好带 mcp 字母的无关服务也会被误判——概率低,但确实遇到过。
对符合标准的 Streamable HTTP 客户端,协议头是更具体的信号。MCP 2025-11-25 规范要求客户端在初始化完成后的每个 HTTP 请求里都带 MCP-Protocol-Version;2026-07-28 规范更严,要求每个 POST 都带。
但这也不是完备手段。旧版客户端的初始请求可能不带;2025-06-18 之前的协议版本没定义这个头;本地 stdio、自定义传输、不符合规范的流量可能永远不带。它存在是强充分条件,它缺失不能证明不是 MCP。
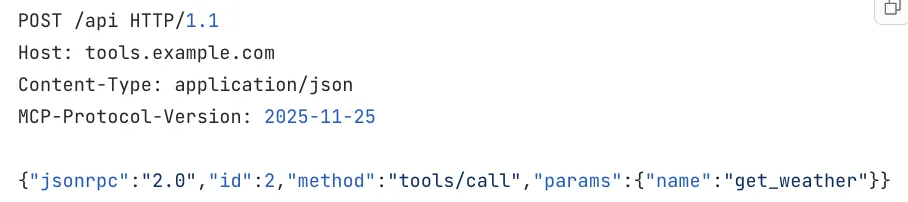
旧版 MCP 流量始于一个不带 MCP-Protocol-Version 的 initialize 请求,所以网络管控手段无法仅凭这个头识别对未知端点的首次请求。特征只有在客户端和服务端完成初始化之后才显现。
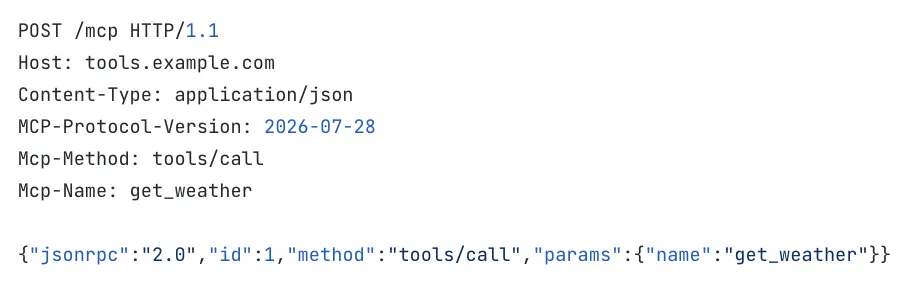
2026-07-28 规范改了这件事。核心协议变成无状态:完全移除 initialize 握手,每个请求都带协议版本和具体操作。Mcp-Method 和 Mcp-Name 让通用 HTTP 基础设施不用解析 body 就能识别具体操作——负载均衡器可以据此路由,限速工具能区分 tools/list 和 tools/call,安全产品能在每个请求里拿到更有价值的信息。
这些协议信号给了 Gateway 可评估的依据,不用再维护一份 MCP URL 列表。
影子 MCP 和绕过 Portal 是两件事
影子 MCP 是连到了组织没批准的服务器。员工可能在代码仓库、产品文档或同事消息里看到某个服务器,直接加进了自己的客户端。安全团队完全不知道它暴露了哪些工具,也不知道员工往里发了什么。
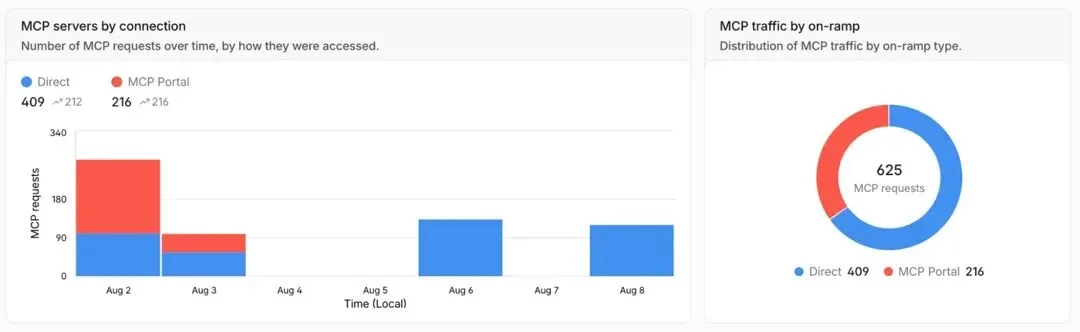
绕过 Portal 不一样:起点是组织已经放进 MCP Portal 的「已批准服务器」,但员工直接连了它的上游 URL,绕开了 Access 策略、工具目录、DLP 和工具级审计。
Gateway 是管托管路径上影子 MCP 的主要手段:识别经过 TLS 检查的 MCP 流量、显示目的地和用户、施加策略。而「绕过 Portal」还得靠源站拒绝直连——Access 策略、源 IP 限制,或者 MCP 服务器自己做的企业级授权。
在 Gateway 里检测 MCP
对已经用 Gateway 并开了 TLS 检查的用户,新增了一条检测启发式规则,回答每个被检查请求的一个简单问题:这是 MCP 流量吗?
对基于会话的 Streamable HTTP 连接,客户端初始化后会发 MCP-Protocol-Version 头。Gateway 检查每个 TLS 解密后的请求里的这个头,基于 Cloudflare 网络每天处理的数百万次请求观察到的模式做分类。这种分类能识别 MCP 的协商和代理过程,不需要预先知道具体主机名或 URL。
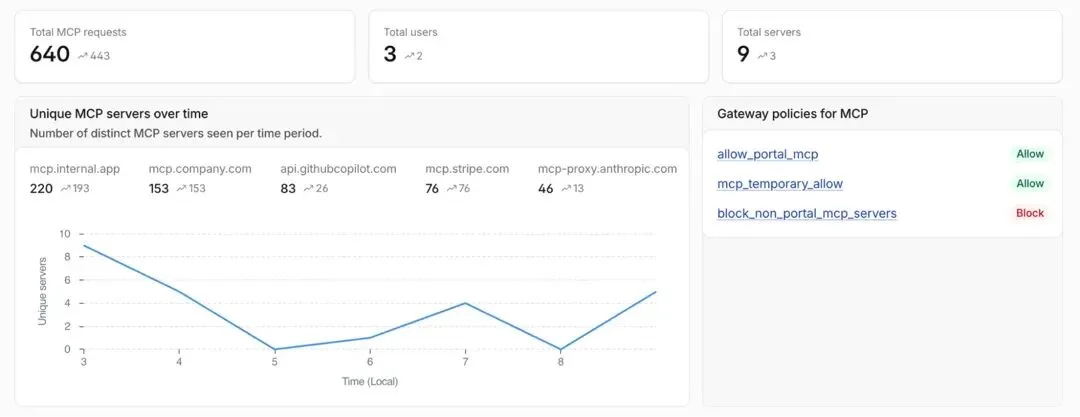
现在所有 Zero Trust 用户都能在 Gateway HTTP 日志里看到 MCP 流量标记,也可以用新的选择器显式拦截或放行:
experimental.is_mcp == true这是个布尔值。Gateway 在 TLS 检查过的请求里检测到 MCP-Protocol-Version 头,值就是 true。管理员可以在 allow 或 block 策略里用它,不用自己维护一份「看起来像 MCP」的域名清单。
直接加密的流量必须先 TLS 解密才能检查这些头;本地 stdio 服务器、网络外的连接、「不检查」的流量、以及从未经过 Gateway 的请求,都不在这个视野里。
MCP Portal 的两个扩展
OAuth 支持扩大。 更多上游服务器的认证方式可以走 OAuth,不用为每个服务器单独配密钥。
把专用 MCP 服务器纳入统一 Portal。 企业 MCP 目录里,公有 SaaS 只占一部分。真正敏感的东西在公有云、私有云或者本地机房,只能通过专用网络访问。目前 Portal 必须能通过互联网解析并连上上游服务器,纯内网的就接不进来。
Cloudflare 正在做的是让 Portal 通过 Gateway 路由和 Cloudflare One 网络连这些专用服务器。这样专用服务器可以保留私有主机名,Portal 通过私有路由访问它,把它和公有上游一起呈现;Access 策略、Portal 日志、工具管控仍然在同一个入口生效。
Portal 流量走 Gateway 还会被打上 mcp_portal 来源标识,Gateway 策略就能区分「来自 Portal 的请求」和「员工的直连」。这个功能还在开发中。
Agents SDK 支持无状态模型
MCP 项目发布的 2026-07-28 规范是一次大改:用无状态、单次请求的模型,替代原来基于连接作用域的初始化方式。
Agents SDK v0.20.0 同时作为客户端和服务端支持这个规范。每个连接,客户端先用 server/discover 探测新协议;服务器不支持,就在同一连接上回退到旧版 initialize 握手。现有的 addMcpServer 调用不用单独配置协议,也不需要单独的客户端。
服务端,createMcpHandler 可以直接从 Worker 提供无状态的 tools、prompts、resources 和 elicitation,不用创建 transport session 或 Durable Object。
这个回退机制很关键,因为协议迁移很少一步到位。新客户端还得访问没升级的旧服务器,新服务器也得兼容没迁移的旧客户端。过渡期里 SDK 得同时把两条路走通。
从看清开始,再堵住不该存在的路径
一套能落地的 MCP 安全体系,起点是搞清楚流量的形状、MCP 的实际使用情况,然后就「哪些工具、哪些入口是批准的」达成一致。
具体三步:先查流经 Gateway 的 MCP 流量,把目标地址和组织批准的服务器清单对一遍;再把更多已批准的服务器迁到 MCP Portal 保护之下;然后固化边界——用 Gateway 策略把 MCP 检测条件和流量来源、目标地址组合起来,拦掉来自受管设备和站点的直连;条件允许的话,让自托管的上游服务器只接受来自 Portal 的流量。
后续还会有更细的能力:针对特定工具调用的管控,以及覆盖环境里所有 MCP 服务器(无论安全团队是否已知)的工具使用报告。
我的判断
这件事真正的转折点不是「多了几个检测规则」,而是 MCP 协议本身在往「可观测」的方向改。2026-07-28 把协议版本和操作名提到 HTTP 头里,等于给网络层开了一扇窗——以前只能靠猜的流量,现在有了明确的信号。
对企业的实际意义:如果你已经在用 Cloudflare One,这条策略几乎零成本,打开 experimental.is_mcp 就能先看清现状。看清之后再决定拦什么,比一上来就封禁要理性得多。
真正难的部分还在后面:员工装一个新客户端、连一个新服务器,只需要一行配置。技术手段能发现和拦截,但「哪些工具该被批准」是治理问题,不是产品能解决的。

文章评论