我给自己的 AI 助手换过三次部署方式,每次都死在同一个地方:维护成本。
想让助手全天候待命,就得在 NAS 上堆好几个容器——模型、向量库、缓存、前端各一个。常年开机费电不说,机器断网或者休眠重启,预设的早报提醒就断了。折腾到最后,使用价值还没维护成本高。
Talorys 走的是另一个方向:0 台服务器,0 个外部数据库,连后台常驻进程都没有。一条命令引导授权,就把聊天、长效记忆、待办和定时提醒全套跑进了 Cloudflare 免费账户。
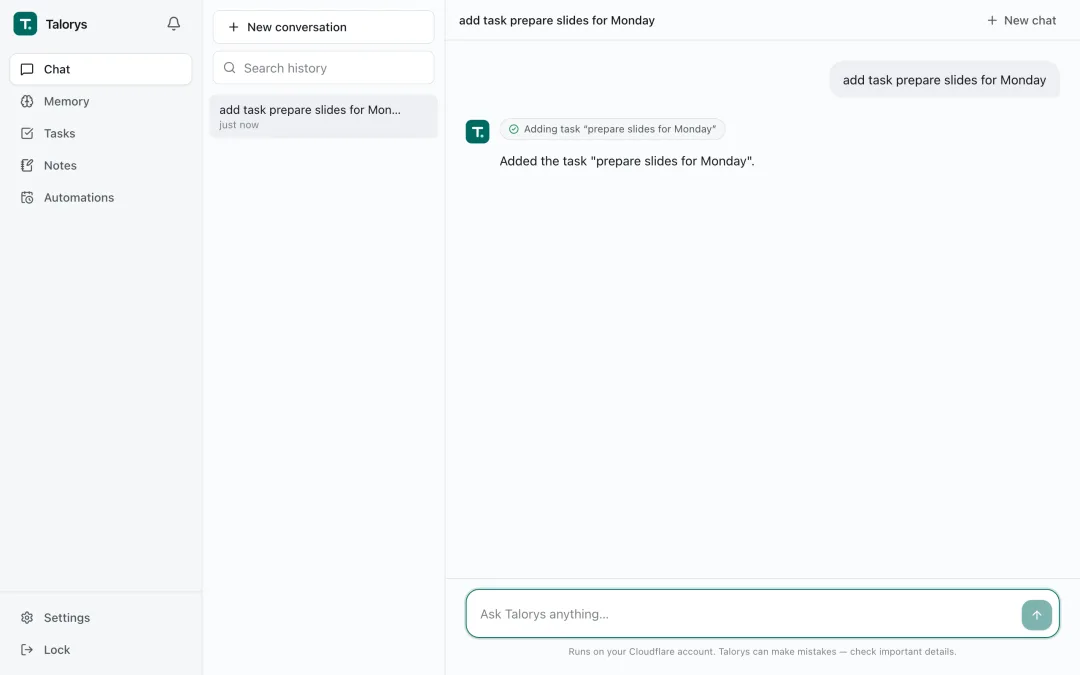
一个 Durable Object 就是整个后端
常规 Agent 项目一旦要存状态,架构图立刻变重:单独配 PostgreSQL,再加一个向量库,还要考虑两者之间怎么对账。
Talorys 没有申请 D1、KV 或 R2。核心状态全部落在 Agents SDK 的持久对象(Durable Object)里,整个助手只由一个叫 personal-agent 的对象承载。对象内部原生集成 SQLite,对话、待办、笔记、提醒都写在这张本地表里。
好处很直接:没有跨网络往返,点开页面秒开;也没有第二个需要备份、需要迁移、需要保持一致的数据源。前端聊天走 SSE 流式返回,调用工具时动态展开卡片,执行动作能直接看见。
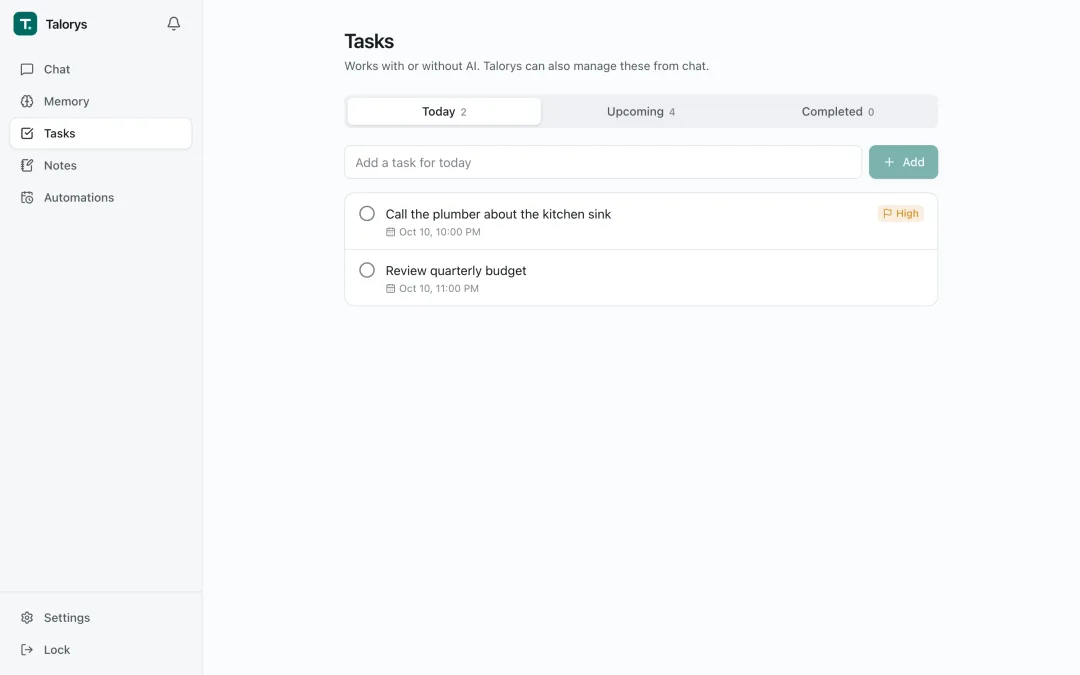
后端 Worker 关闭了公网路由,没有暴露接口,全靠 Pages 前端通过私有 Service Binding 转发。这个细节决定了它的攻击面——对外只有一个登录页,猜密码是唯一的入口。
记忆不是堆向量,而是有生命周期
很多私人助理用几天就吃灰,症结在记忆机制。项目讨论区有个很经典的测试:先告诉助手“我的车是老甲壳虫”,过几天更新说“换成了特斯拉”,再问“我现在开什么车”。常规检索多半回答甲壳虫——旧记录带“车”字,新记录只有品牌。全塞进向量库,矛盾的新旧事实就会在上下文里打架。
Talorys 的做法是给记忆加一套生命周期。提取新事实时,流水线先核验逻辑关联;一旦新事实取代了旧记录,旧数据被打上 historical 标签归档。
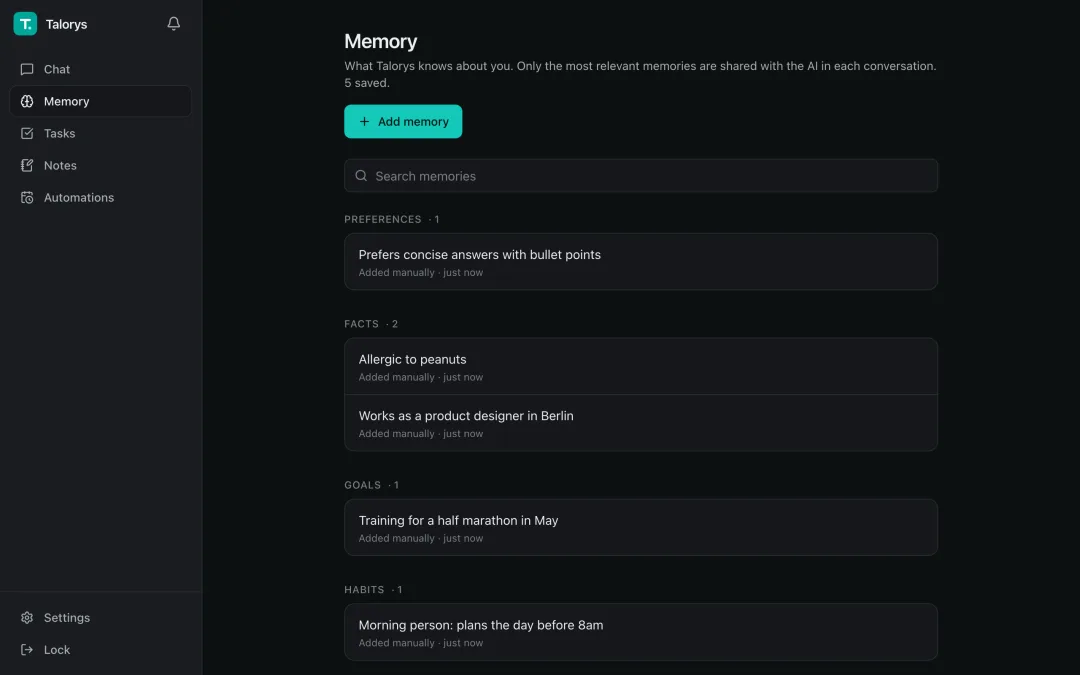
平时聊天只把当前有效的事实和偏好带进提示词。只有主动追问过去,历史档案才会被调出来。这比“全都检索一遍”要多做一步判断和归档,但换来的是回答不会前后自相矛盾。
用边缘原生闹钟代替常驻轮询
私人助理必须能在指定时间主动说话。自建方案为了跑定时提醒,后台总要挂一个轮询进程,随时担心被系统 OOM 杀掉。
Talorys 直接用 Durable Object 的 Alarms。每个任务在后台注册成一个时间戳:触发前边缘端没有任何实例在运行,CPU 和内存占用归零;到点唤醒对象执行,推完通知立刻睡下。
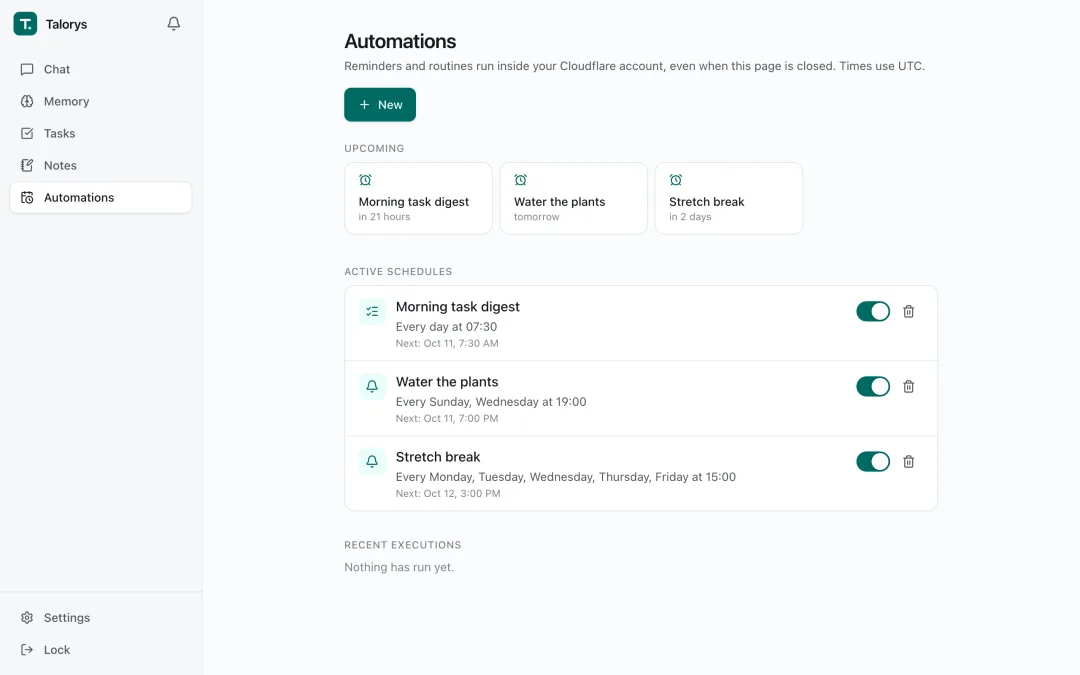
这意味着电脑关机、手机离线,云端日程照样准点生效。当天免费推理额度用完,纯文本提醒和任务简报依然发得出来——那部分不经过模型。
部署前必须接受的四个限制
- 纯单人定位:没有多租户和团队权限,只认一把主人密码,别想着给同事开账号。
- 免费额度约束:走 Workers AI 的每日配额,高频、长篇对话会碰到上限。
- 语义检索默认关闭:默认用 FTS5 全文搜索,想要向量语义召回得自己去设置里打开。
- 冷启动微延迟:长期闲置后首次唤醒,偶尔有几百毫秒的等待。
这四条不是 bug,是把架构压到这么薄必须付的代价。能接受,它就是极省心的方案;不能接受,说明你需要的是另一类产品。
和自建方案比,省掉的到底是什么
很多人算这笔账时只算电费,其实真正省掉的是三件事。
第一是常驻进程的心智负担。 自建方案里,模型服务、向量库、定时任务各是一个容器,任何一个挂了,表现出来都是“助手不回消息”。排查要一个个看日志。Talorys 把这些都收进一个对象里,出问题只有一处。
第二是数据一致性。 对话在 PostgreSQL、向量在另一个库、待办在第三个地方时,“我刚说的事它记不记得”取决于三个系统的同步时序。单对象单 SQLite 没有这个问题,代价是不能横向扩展——但单人助手本来也不需要。
第三是运维窗口。 升级、备份、迁移,自建方案每次都要停机。跑在边缘上的对象,升级就是一次部署,状态留在原地。
反过来说,如果你的需求超出“一个人用”,这套架构会很快碰到天花板:没有多租户、没有细粒度权限、没有跨对象的事务。它的取舍非常明确——用扩展性换掉了几乎全部运维工作。
适合谁
如果你不想为一个月只用几次的助手常年开一台机器,又希望数据不落在第三方 SaaS 里,Talorys 是少见的、把“够用”做得很彻底的项目。它没有试图做一个通用 Agent 平台,只解决一个人的日常:聊天、记事、提醒。
项目地址:rociiu/talorys

文章评论