在周末的投资圈子里,DeepSeek-R1对算力需求的影响引发了热烈讨论。为了避免读者被一些网络上不准确的信息误导,我们来分享一下对这个问题的看法。
首先,R1是基于V3基础模型训练出的推理模型。一个月前DeepSeek发布V3时,也曾引发过类似的算力需求争议。这两个问题其实有重叠之处。V3的训练成本被报道为557.6万美元,但这个数字有水分,因为开发者明确指出,这仅包括正式训练阶段的费用,并不涵盖前期对架构、算法和数据的研发,以及消融实验等成本。这些前期工作才是AI算力需求的主要消耗。
其次,无论R1还是V3,其本质都是在现有大模型研究成果的基础上,进一步优化算法和训练效率,相当于“站在巨人的肩膀上”。这是否能威胁到OpenAI或Meta等巨头?恐怕不会。这些海外大模型领导者们专注于研发下一代模型,而不是仅仅优化现有版本。
我们距离实现AGI(通用人工智能)还有很长的路要走。DeepSeek的模型目前表现不错,但远未达到完美,不需要进一步进步的程度。目前,我们仍处于AI技术的快速发展期。在可预见的未来,以OpenAI和Google为首的公司和机构将继续向AGI发起挑战,不断推出更大规模的模型或革新基础架构。在此过程中,算力需求只会持续增长。
第三,投资界目前主要关注LLM(大语言模型)的训练算力需求,但很多人忽略了未来推理端的算力需求,以及其他AI领域(如自动驾驶和机器人)的训练与推理需求。对于大语言模型,如果未来某代模型足够成熟,而像DeepSeek这样的公司能大幅降低训练算力,那非但不会对算力市场造成负面影响,反而会是利好,因为它将激发海量的推理需求。
这就引出了我们今天的核心话题:人形机器人需要多少算力?
需要说明的是,这个问题目前没有标准答案。因为以Tesla Optimus为代表的人形机器人大多还处于开发阶段,其模型参数规模和算力需求并不公开。而且,对人形机器人训练的定义也存在争议。例如,Agility Robotics曾表示,现阶段他们只需训练机器人处理标准箱子的搬运任务,而非各种复杂工作。对于这类简单任务,人形机器人的训练和推理相对容易。马斯克也提到,Optimus初期将用于自家工厂的重复性劳动。但显然,马斯克的野心不止于此,他开发机器人是为了追求AGI。因此,我们主要以特斯拉为切入点,来估算人形机器人的算力需求。
1. 人形机器人训练端的算力需求
首先来看训练端的算力。2024年6月,特斯拉拥有相当于超过35,000块NVIDIA H100芯片的算力,用于FSD(全自动驾驶)AI训练集群,并计划在2024年底扩展到近90,000块H100等效算力,用于更广泛的AI训练。这里的用途有所不同:早期35,000块主要针对FSD,而后续扩展的算力,除了FSD外,可能主要用于人形机器人。
此外,马斯克在2024年3月表示,他们已不再缺少AI训练算力,这暗示FSD的算力需求已基本满足。因此,特斯拉未来的算力扩充很可能主要服务于人形机器人。
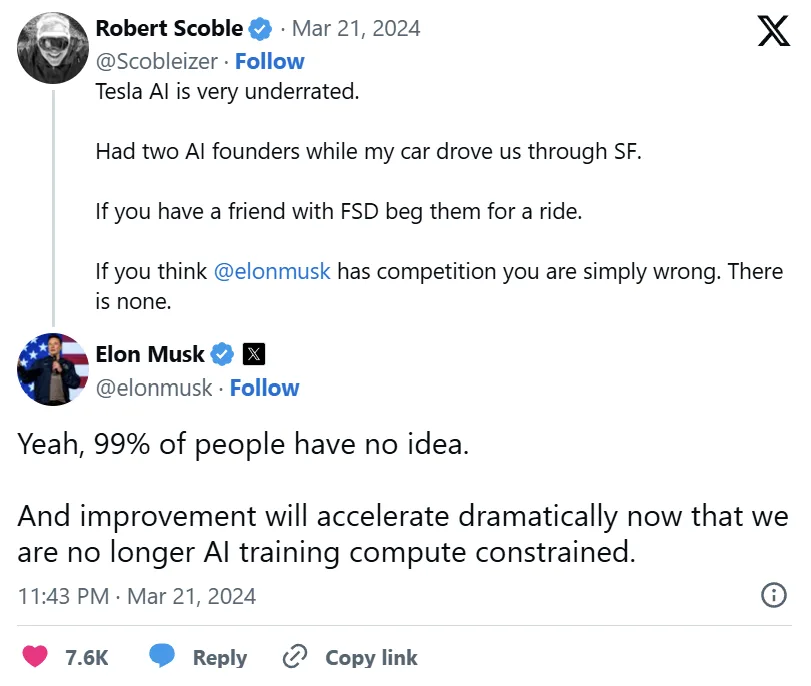
以每块H100约30,000美元计算,90,000块等效算力的GPU价值约27亿美元。我个人估计,其中至少三分之一(约9亿美元)是为机器人训练准备的。
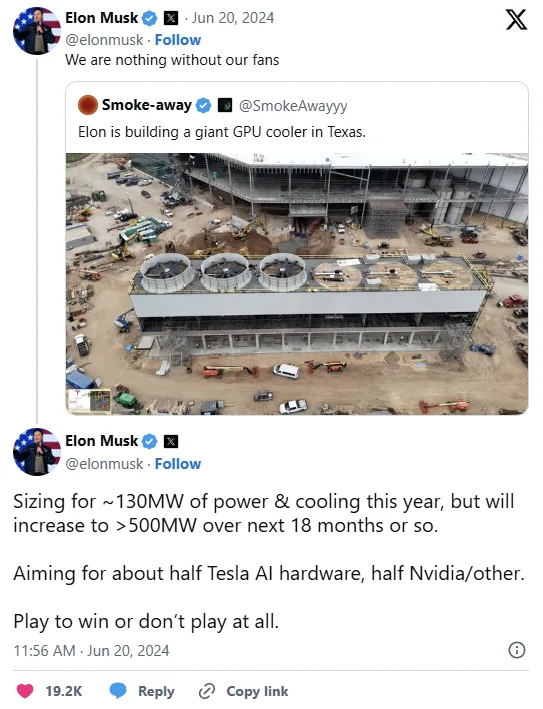
马斯克还透露,特斯拉2024年的数据中心容量约为130MW,并计划在2025年底达到超过500MW。一块H100功耗约700W,90,000块等效算力对应约63MW。考虑到GPU占服务器功耗的80%,加上数据中心散热等因素,总容量约130MW,这与规划吻合(也侧面验证了马斯克的数据中心规划可靠)。由此推算,到2025年底,特斯拉可能拥有相当于35万块H100的算力。其中,可能超过一半是为人形机器人训练准备的。假设20万块,这对应约60亿美元的GPU投资,扣除2024年底的9亿美元,新增约50亿美元。
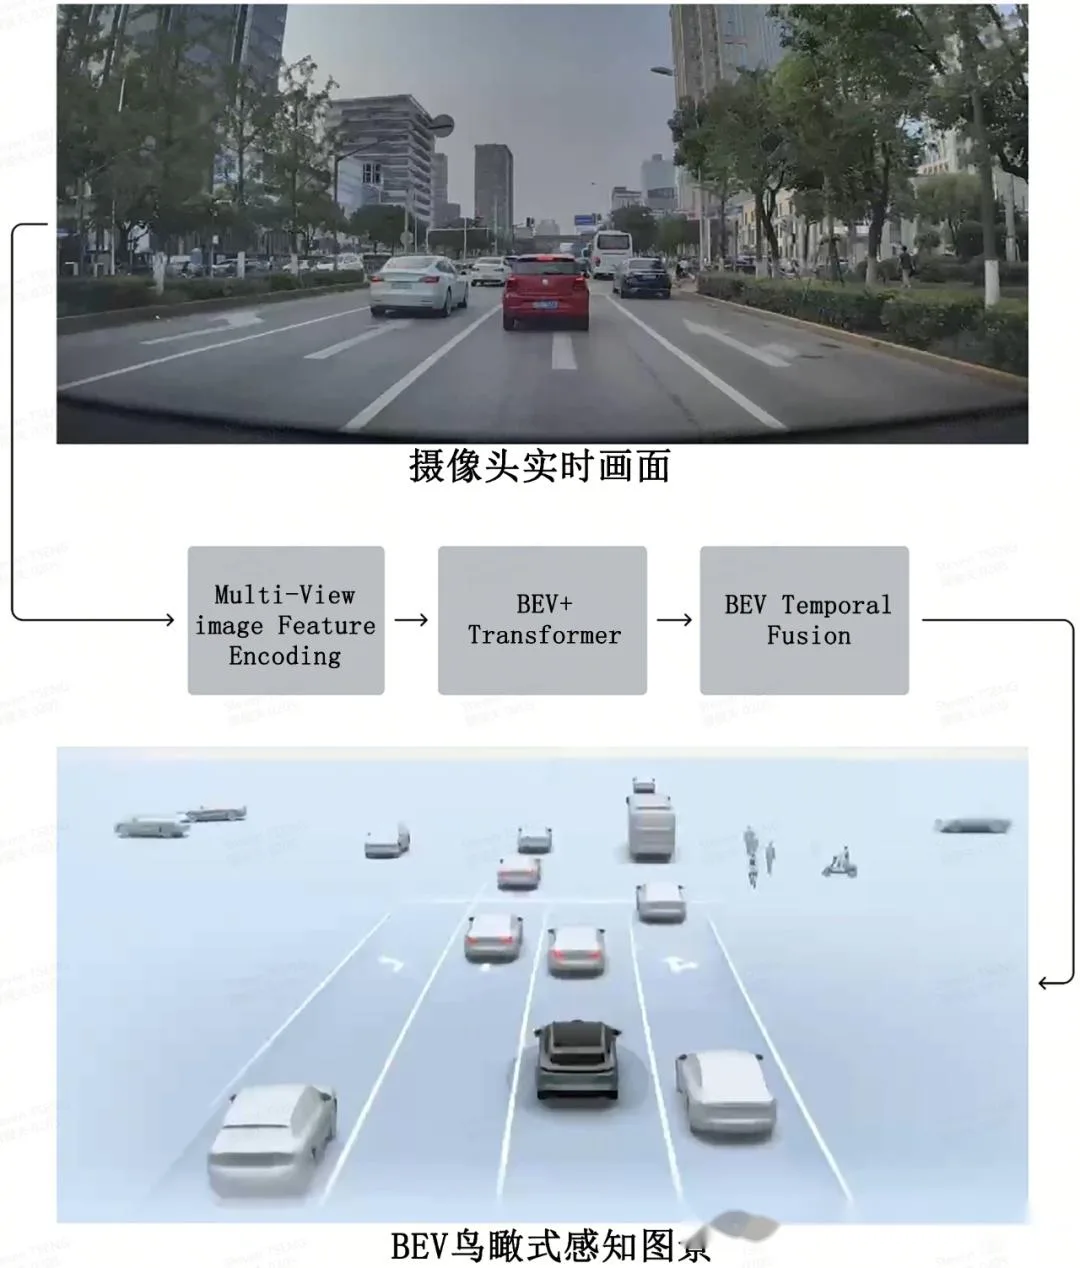
以上是基于推测的分析。接下来,我们深入探讨。要实现马斯克设想的通用型人形机器人,其训练难度远超自动驾驶。自动驾驶本质上是二维空间的路径规划问题,早期的BEV(鸟瞰视角)+ Transformer架构就是如此。后来特斯拉升级到Occupancy Network,构建三维视图,但车辆主要仍在二维平面移动。
相比之下,人形机器人的训练复杂得多。除了行走(类似于自动驾驶),还涉及其他三维空间的任务。更重要的是,机器人训练包括物体接触和交互,而非仅避开障碍。这大大增加了难度。
另外,自动驾驶的数据收集相对容易:安装传感器即可从行驶车辆中积累数据。但机器人数据稀缺,部署成本高,因此必须依赖虚拟环境进行训练和数据积累。虚拟环境的生成和模拟也会消耗算力。下期我们将讨论机器人虚拟训练,这是当前机器人研发的核心挑战。
总之,开发通用型人形机器人所需的训练难度和算力远高于自动驾驶。我预计,特斯拉2025年在人形机器人训练上的GPU投入约50亿美元,对应数据中心总投入约100亿美元。特斯拉并非唯一玩家,如果其他企业跟进,2025年全球人形机器人训练算力投入可能达到150亿美元,并将在未来几年高速增长。
2. 人形机器人推理端的算力需求
训练端之外,我们简要谈谈推理端的算力。与自动驾驶类似,人形机器人的推理主要依赖端侧(本地)算力,而非云端,以避免网络问题导致功能中断。同时,两者对延迟要求极高,需要低时延完成计算。目前,公开讨论人形机器人端侧算力的不多,因为现阶段任务简单,对算力需求不高。但随着向通用型发展,端侧算力将成为瓶颈。
目前最强的机器人端侧平台可能是NVIDIA即将发布的Jetson Thor,基于Blackwell架构,提供约800 TFLOPS的8位浮点算力。
此前,地平线估计L4级自动驾驶需50 TFLOPS,L5级需500 TFLOPS。Jetson Thor或许能满足L5级自动驾驶,但对通用型人形机器人很可能不足。有些创业公司已关注此问题,探索存内计算等技术来提升端侧算力。
感谢阅读!欢迎在评论区或后台留言讨论!

文章评论