把渗透测试交给 AI Agent,最大的障碍从来不是模型不够聪明,是「不敢让它自己跑」。一个能调用 nmap、sqlmap、metasploit 的 Agent,如果判断错了,可能把生产环境打挂,也可能在你没有授权的目标上动手。
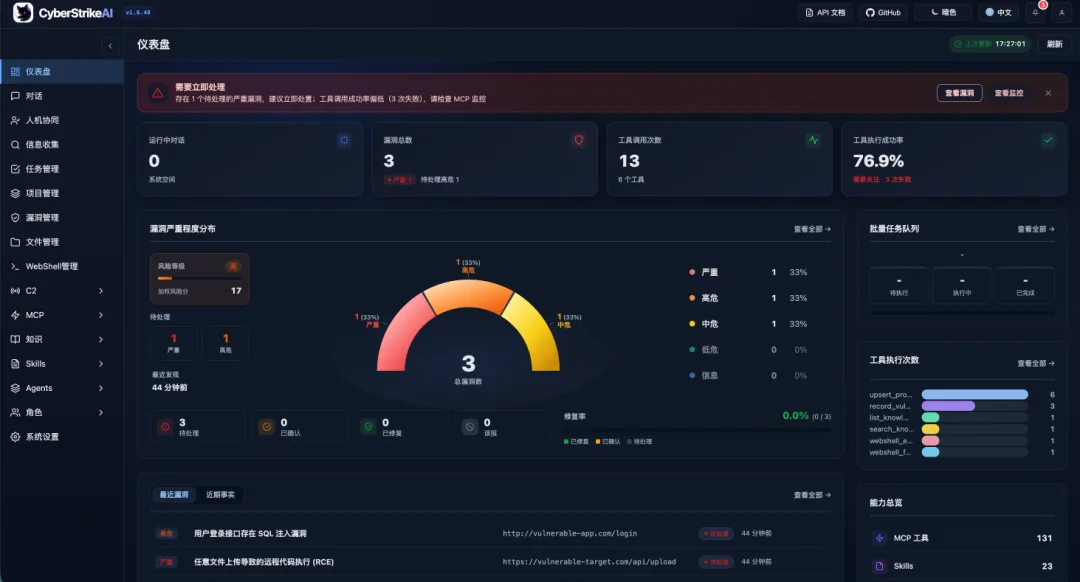
CyberStrikeAI 是这一类平台里做得比较完整的:上百款工具、C2 与 WebShell 会话管理、攻击链可视化、RBAC 权限、工具调用拦截、全链路审计。但我觉得最值得看的是它最近接入的审批机制——用决策模型来管「这个动作能不能执行」。
它是什么
一个 AI 原生的 Agent 渗透测试平台。基于 Eino 做多智能体编排,原生支持 MCP,可以把自然语言指令转成受控的攻防动作。
定位很明确:只用于已获得授权的安全评估和红蓝对抗演练。这句话不是免责套话,是它的产品边界——平台假设你已经有授权,它负责让授权范围内的操作更高效、更可审计。
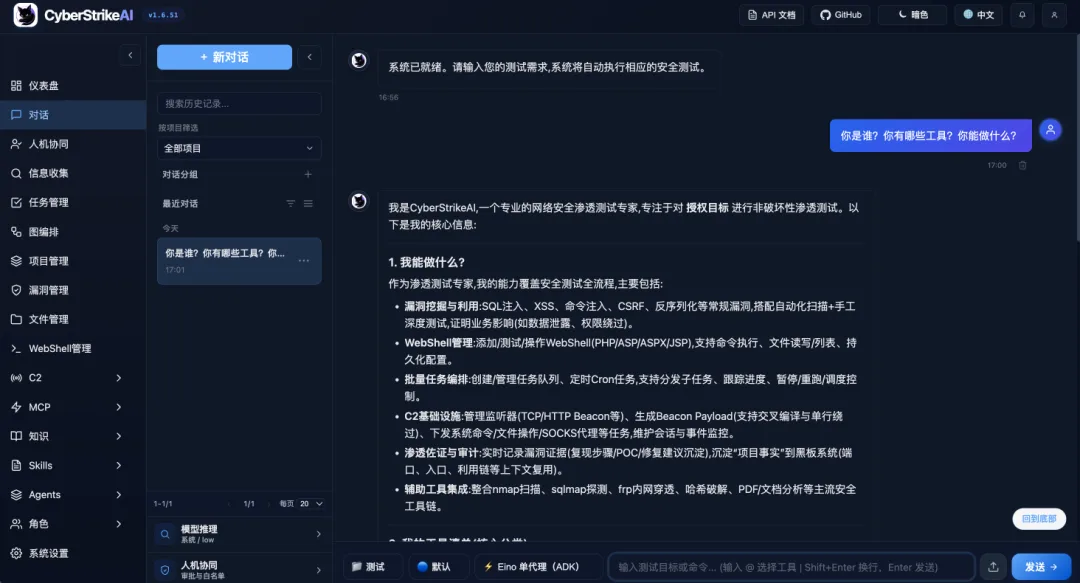
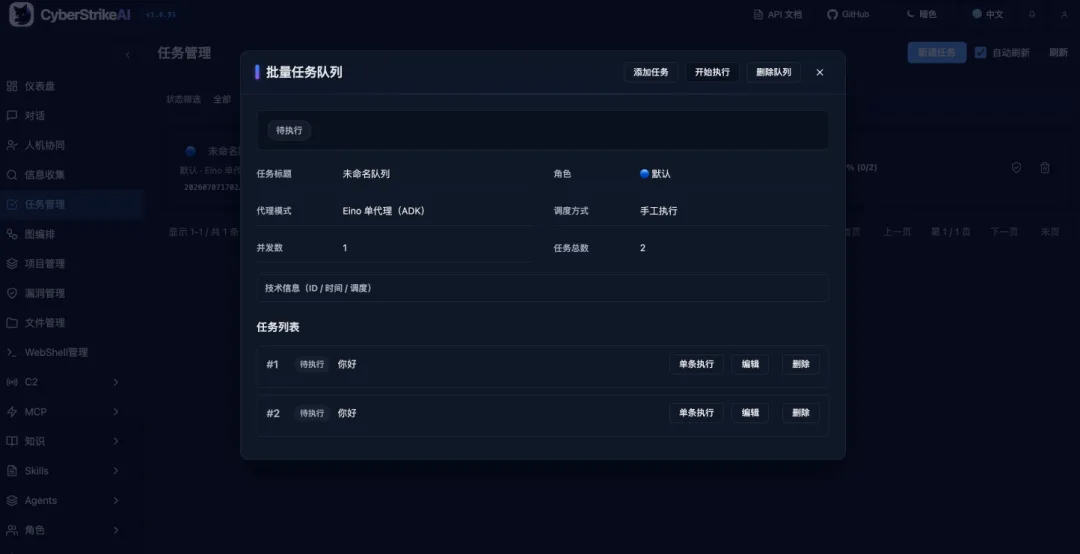
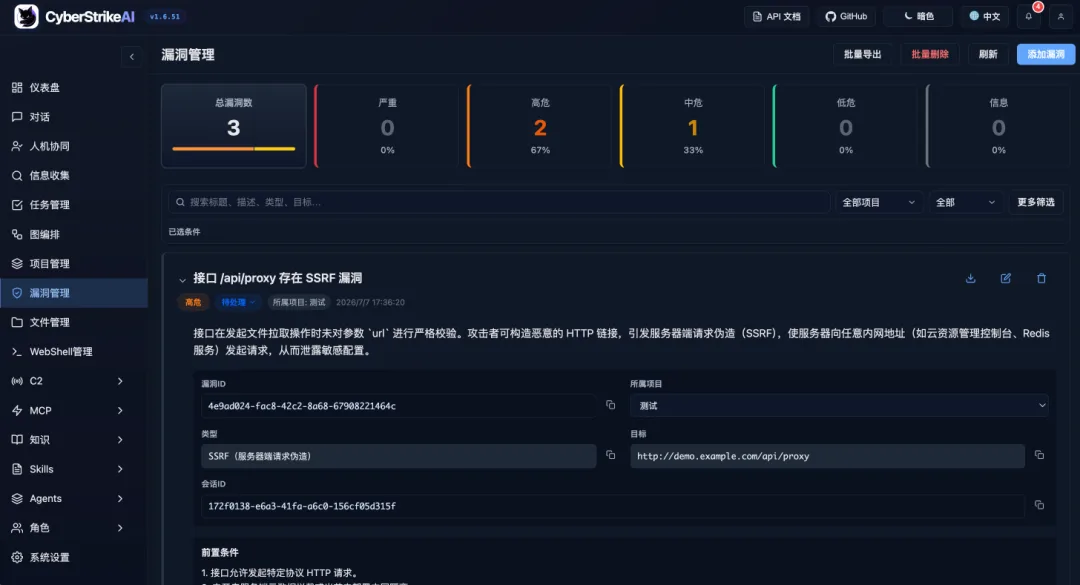
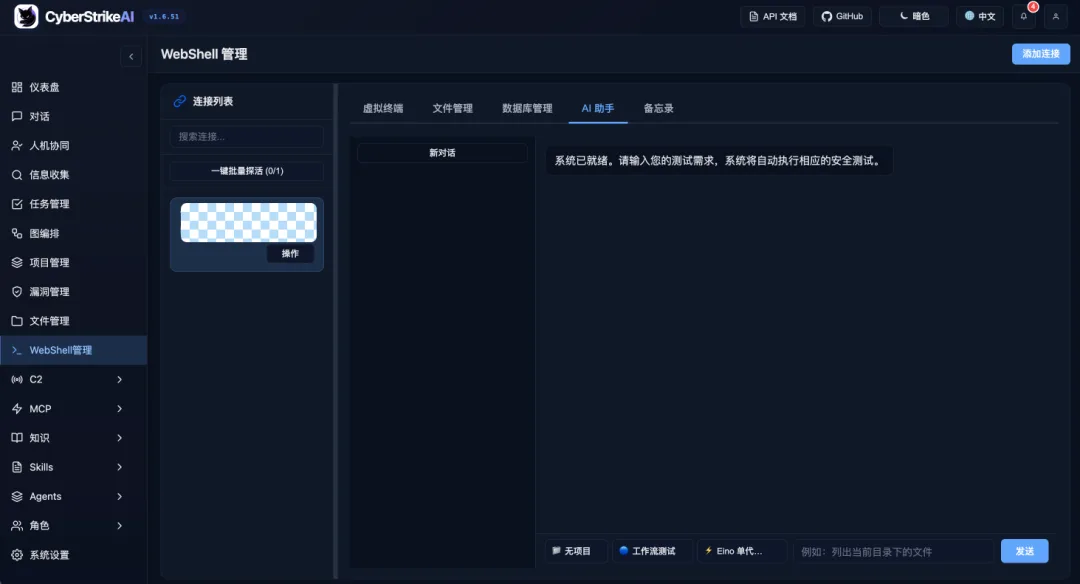
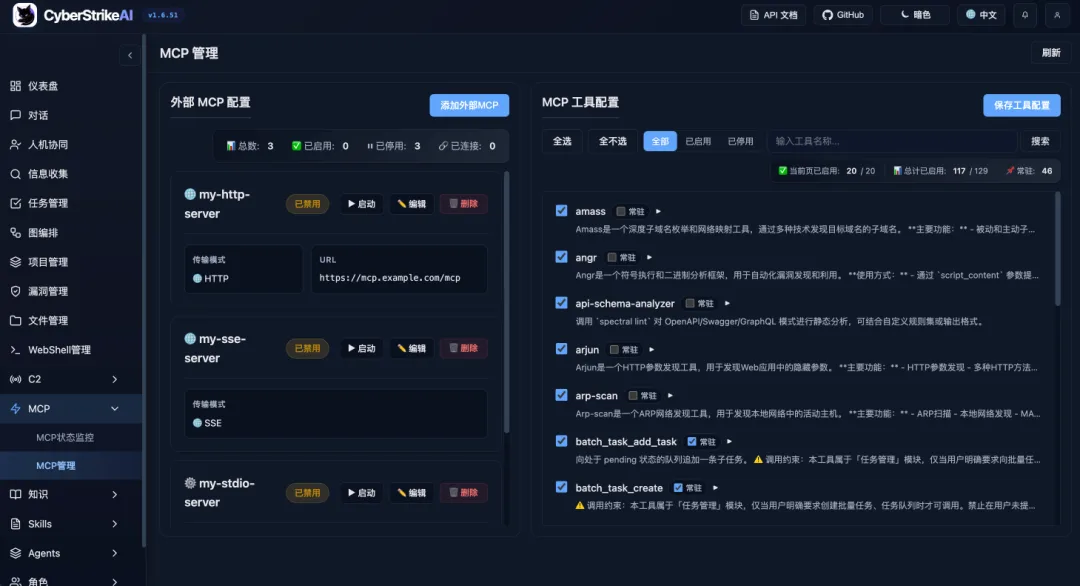
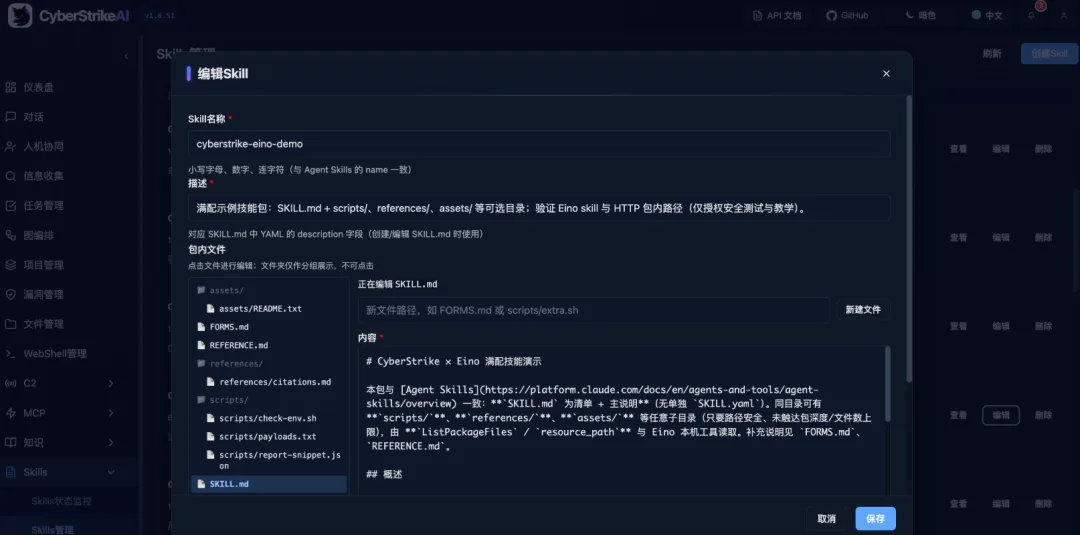
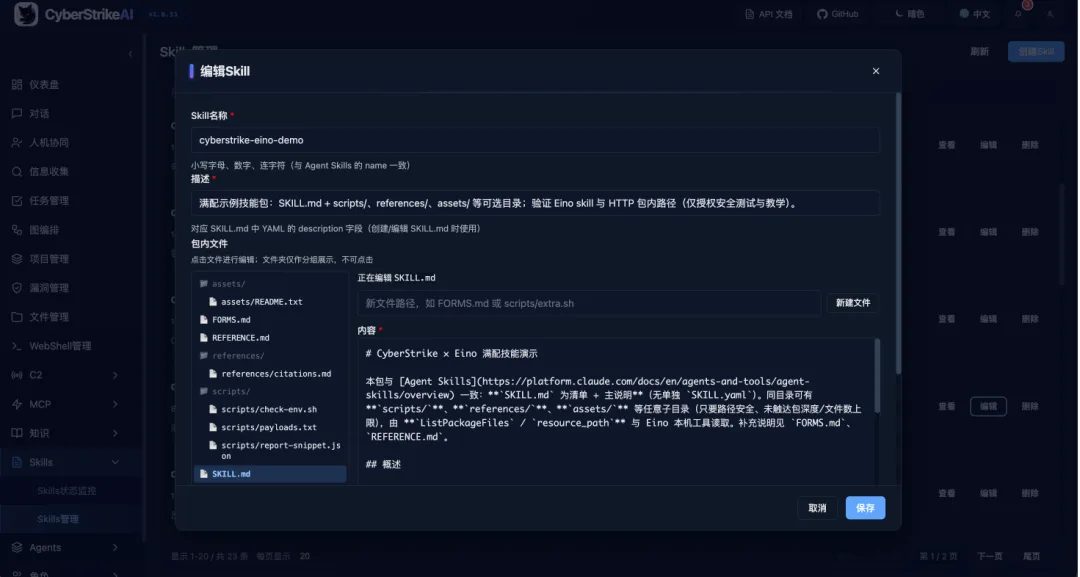
控制台覆盖的六个面
任务管理、漏洞管理、WebShell 管理、MCP 管理、Skills 管理、系统设置。这六个模块基本覆盖了一次完整评估的生命周期:从建任务、跑工具、拿 shell、管漏洞、出报告。
工具生态
100 多个精选的 YAML 工具配方,覆盖完整攻击链。按类别大致是这样:
- 网络扫描:nmap、masscan、rustscan、arp-scan、nbtscan
- Web 扫描:sqlmap、nikto、dirb、gobuster、feroxbuster、ffuf、httpx
- 漏洞扫描:nuclei、wpscan、wafw00f、dalfox、xsser
- 子域枚举:subfinder、amass、findomain、dnsenum、fierce
- 空间测绘:fofa、zoomeye、quake、shodan
- API 安全:graphql-scanner、arjun、api-fuzzer
- 容器安全:trivy、clair、docker-bench、kube-bench、kube-hunter
- 云安全:prowler、scout-suite、cloudmapper、pacu、terrascan、checkov
- 二进制分析:gdb、radare2、ghidra、objdump、strings、binwalk
- 漏洞利用:metasploit、msfvenom、pwntools、ropper、ropgadget
- 密码破解:hashcat、john、hashpump
- 取证分析:volatility、foremost、steghide、exiftool
- 后渗透:linpeas、winpeas、mimikatz、bloodhound、impacket、responder
YAML 配方的好处是可以按角色控制、可以自定义扩展。不同的人拿到不同的工具集,这在团队协作里是必要的。
编排:三种多智能体模式
基于 Eino,支持单智能体、Deep、Plan-Execute、Supervisor 四种形态。工作流可以用 Agent、工具、条件、审批、输出这几类节点自由拼装。
还有「角色化测试」:为常见安全场景预置提示词和工具策略。比如做外网打点时用一套,做内网横向时用另一套,不用每次从零写提示词。
审批:这次更新的重点
这是我写这篇文章最主要的原因。
Agent 每次调用非白名单工具时,会把工具名、参数和策略一次性交给 Jev(TypeSafe 的决策模型)做结构化的放通/拦截判断,不再依赖聊天模型输出 JSON 再由代码解析。
Jev 并行判断两件事:这个操作有多大的破坏性风险,以及它是否符合授权的渗透意图。本地规则合成 approve 或 reject。默认放行授权范围内的渗透动作,只拦截四类:打挂业务、毁数据、改账号权限、改线上配置。
为什么不用聊天模型来判断?因为「输出 JSON 再解析」这条路在安全场景里不可靠。字段名写错、多包一层解释、置信度自报,任何一个都会导致审批逻辑误判。决策模型直接输出概率,代码拿概率做阈值判断,链路短、可审计。
这个设计思路我在别处也见过:把「判断」和「表达」拆开。审批需要的是判断,不需要解释。
部署
环境要求:Go 1.25+、Python 3.10+。
cd CyberStrikeAI
chmod +x run.sh && ./run.sh
run.sh 会自动检查 Go 和 Python 环境、创建虚拟环境、装 Python 依赖、拉 Go 模块、编译、启动。
然后配 AI 通道,这是首次使用前必须做的:
ai:
  default_channel: openai-main
  channels:
    openai-main:
      name: OpenAI Main
      provider: openai_compatible
      api_key: "$OPENAI_API_KEY"
      base_url: "https://api.openai.com/v1"   # 或 https://api.deepseek.com/v1
      model: "gpt-4o"                          # 或 deepseek-chat, qwen3-max 等
      max_total_tokens: 120000
      max_completion_tokens: 16384
其他启动方式:
# 直接运行(需自行配环境),与 run.sh 默认一致可加 --https
go run cmd/server/main.go --https

# 手动编译
go build -o cyberstrike-ai cmd/server/main.go
./cyberstrike-ai --https
我的看法
这类平台真正的门槛不是工具数量,是「敢不敢让它连续跑」。工具谁都能集成,难的是让操作者在每一步都知道 Agent 在干什么、为什么这么干、能不能停下来。
CyberStrikeAI 在三个地方回应了这个问题:审批层用决策模型做确定性判断,不靠模型自觉;RBAC 加工具调用拦截,把权限边界做在平台里;全链路审计日志,事后能完整复盘。
但它仍然是一个高权限工具。部署在自己的隔离环境里,配独立的 API Key,不要和办公网混在一起。跑之前想清楚授权范围,跑的时候盯着审批日志。
本文涉及的平台仅面向已获得授权的安全评估与红蓝对抗演练。未授权测试属于违法行为,后果自负。

文章评论