用 Claude 做漏洞挖掘,最大的问题不是模型不够聪明,而是它不知道“该按什么流程做”。你问它一个接口有没有越权,它会给你一段泛泛而谈的分析;你让它审一个仓库,它会从入口文件一路读到半夜,最后给你一堆没法验证的猜测。
Claude-BugHunter 想解决的就是这件事:把漏洞挖掘和外部红队的工作流,拆成一套 Claude 能直接调用的技能包。
它到底装了什么
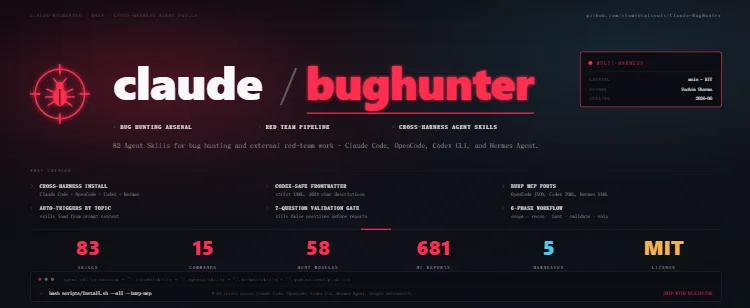
按项目自己的描述,这套技能包包含:
- 83 项技能,覆盖从侦察、指纹识别到具体漏洞验证的各个环节;
- 15 个斜杠命令,把常用流程固化成一键调用;
- 24 个核心漏洞类别下的 681 个已披露报告模式,其中 433 个可以单独引用和审计;
- 企业身份与基础设施攻击矩阵;
- 参与文件夹脚手架(engagement folder scaffolding),让每次测试的产出有固定结构;
- Burp MCP 集成。
最后一条值得单独说。Burp 是 Web 漏洞挖掘的事实标准,MCP 集成意味着 Claude 不只是“读代码猜漏洞”,而是能通过 Burp 拿到真实的请求响应、重放流量、查看扫描结果。这让它的结论有了可验证的来源,而不是纯文本推理。
681 个报告模式是什么意思
这是我觉得这套东西里最有价值的部分。所谓“报告模式”,不是让模型自由发挥写一段漏洞描述,而是给它一批真实披露过的案例作为参照:这类漏洞在真实项目里长什么样、触发条件是什么、危害怎么界定、修复建议怎么写。
好处有两个。一是输出更接近人类安全工程师写的报告,而不是“可能存在安全风险”这种废话;二是 433 个可单独引用的模式,意味着你可以让它针对某一个具体类别深挖,而不是每次都把整个知识库塞进上下文。
它把流程变成了可复用的东西
漏洞挖掘真正的难点从来不是“知道有 SQL 注入”,而是:先看什么、怎么判断优先级、什么信号值得深挖、什么时候该停。这套东西本质上是在把这些隐性经验显性化。
配合参与文件夹脚手架,一次测试的产出是结构化的:目标范围、收集到的资产、发现的候选点、验证过的漏洞、证据、报告。这对复现和交接很重要——半年后回来看,你还知道当时为什么这么判断。
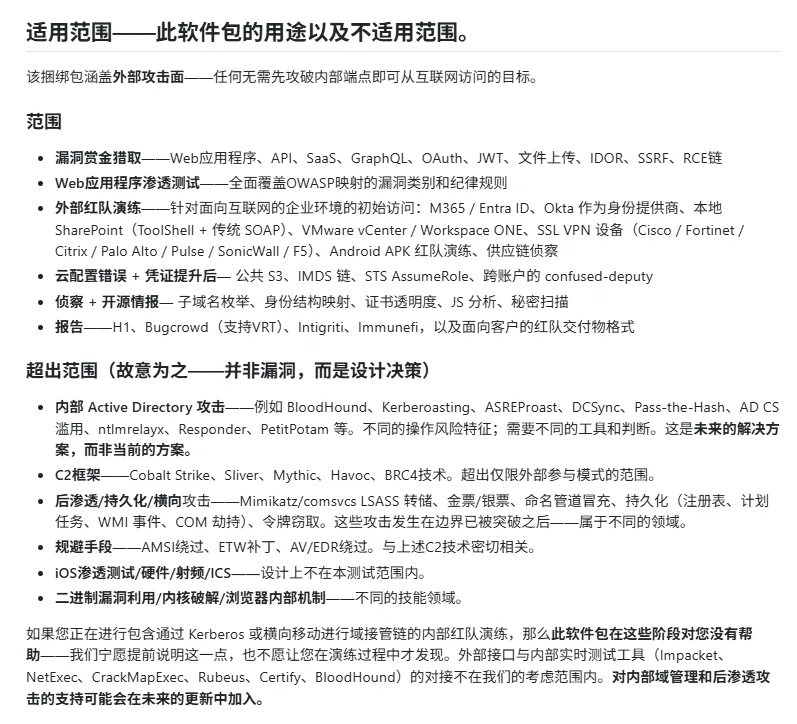
适用范围说清楚
把它接进一次真实测试
我自己的用法是把它放在“已经拿到授权、已经明确范围”之后。开工前先把范围写进参与文件夹:域名、IP 段、允许的测试类型、禁止的动作(比如不做拒绝服务、不碰生产数据)、联系人和时间窗口。这套脚手架的价值在这里体现得最明显——它逼你在动手前把这些写清楚,而不是边打边想。
之后按阶段调用:先让它把资产和入口梳理一遍,再针对具体接口做定向分析,最后用它把发现整理成报告。中间每一步的产出都留在文件夹里,形成可回溯的链条。这一点比“问一句答一句”重要得多,因为漏洞挖掘里最有价值的往往不是结论,而是“你为什么觉得这里可疑”。
需要提醒的是,模型仍然会编。它可能把一段正常的错误处理说成信息泄露,也可能把框架默认行为当成配置缺陷。所以任何一条发现,在写进报告之前都必须自己复现一遍。技能包能提高效率,但不能替代“亲手验证”这一步。
项目明确写了,它经过实战检验的场景是:经过授权的红队和漏洞挖掘活动,以及公共培训平台(DVWA、OWASP Juice Shop、Hacker101、testphp.vulnweb.com)。
这句话不是客套。这类工具的能力边界和法律责任是绑在一起的:技能包给你的是方法,不是授权。对没有书面许可的资产跑扫描、发测试请求,不管用的是 Claude 还是 Burp,性质都一样。
我的建议是把它当成“流程助手”而不是“自动化打点机”。它最擅长的是帮你把已有信息组织起来、提示你漏掉的检查项、把发现写成能交付的报告。真正决定测什么、测到哪一步停,仍然得是人。

文章评论