你可能遇到过这些微小但烦人的需求:
- 给网站加一个全站公告栏开关;
- 保存用户的夜间模式、语言偏好;
- 缓存一份几小时才刷新一次的天气或汇率 API。
很多人的第一反应往往是:上数据库。
紧接着便是一套熟悉的繁琐流程:选型 MySQL/PostgreSQL、创建云实例、配置连接池、写 Schema、配 ORM……功能逻辑还没写几行,基础设施维护先折腾了一整天。
为了轻量化,不少人把目光投向了 Cloudflare Workers KV。
不过先把核心结论放在前面:KV 的免费额度确实大方,但它从来不是数据库的平替。用对了省心省钱,用错了,数据不同步和竞态覆盖只是早晚的事。
1. KV 到底是什么?
KV 即 Key-Value(键值对) 存储,所有数据仅依靠“键”和“值”两项来组织。
你可以把它想象成一排贴着全球唯一标签的抽屉:只要报出门牌号与抽屉编号,就能瞬间拿出里面的东西:
site:notice$\rightarrow$ 存放网站公告内容user:1001:theme$\rightarrow$ 存放指定用户的界面主题api:weather:shanghai$\rightarrow$ 存放第三方天气接口的 JSON 缓存
它没有 SQL 中的多表关联(JOIN)、没有复杂范围过滤,更没有事务(ACID)保障。它最纯粹的职责,就是:给定一个明确的 Key,以最低延迟在全球边缘取回对应的 Value。
它的底层机制:中心写入,边缘缓存
Cloudflare 官方将 KV 定义为全球低延迟键值存储。它的运转逻辑分为两层:
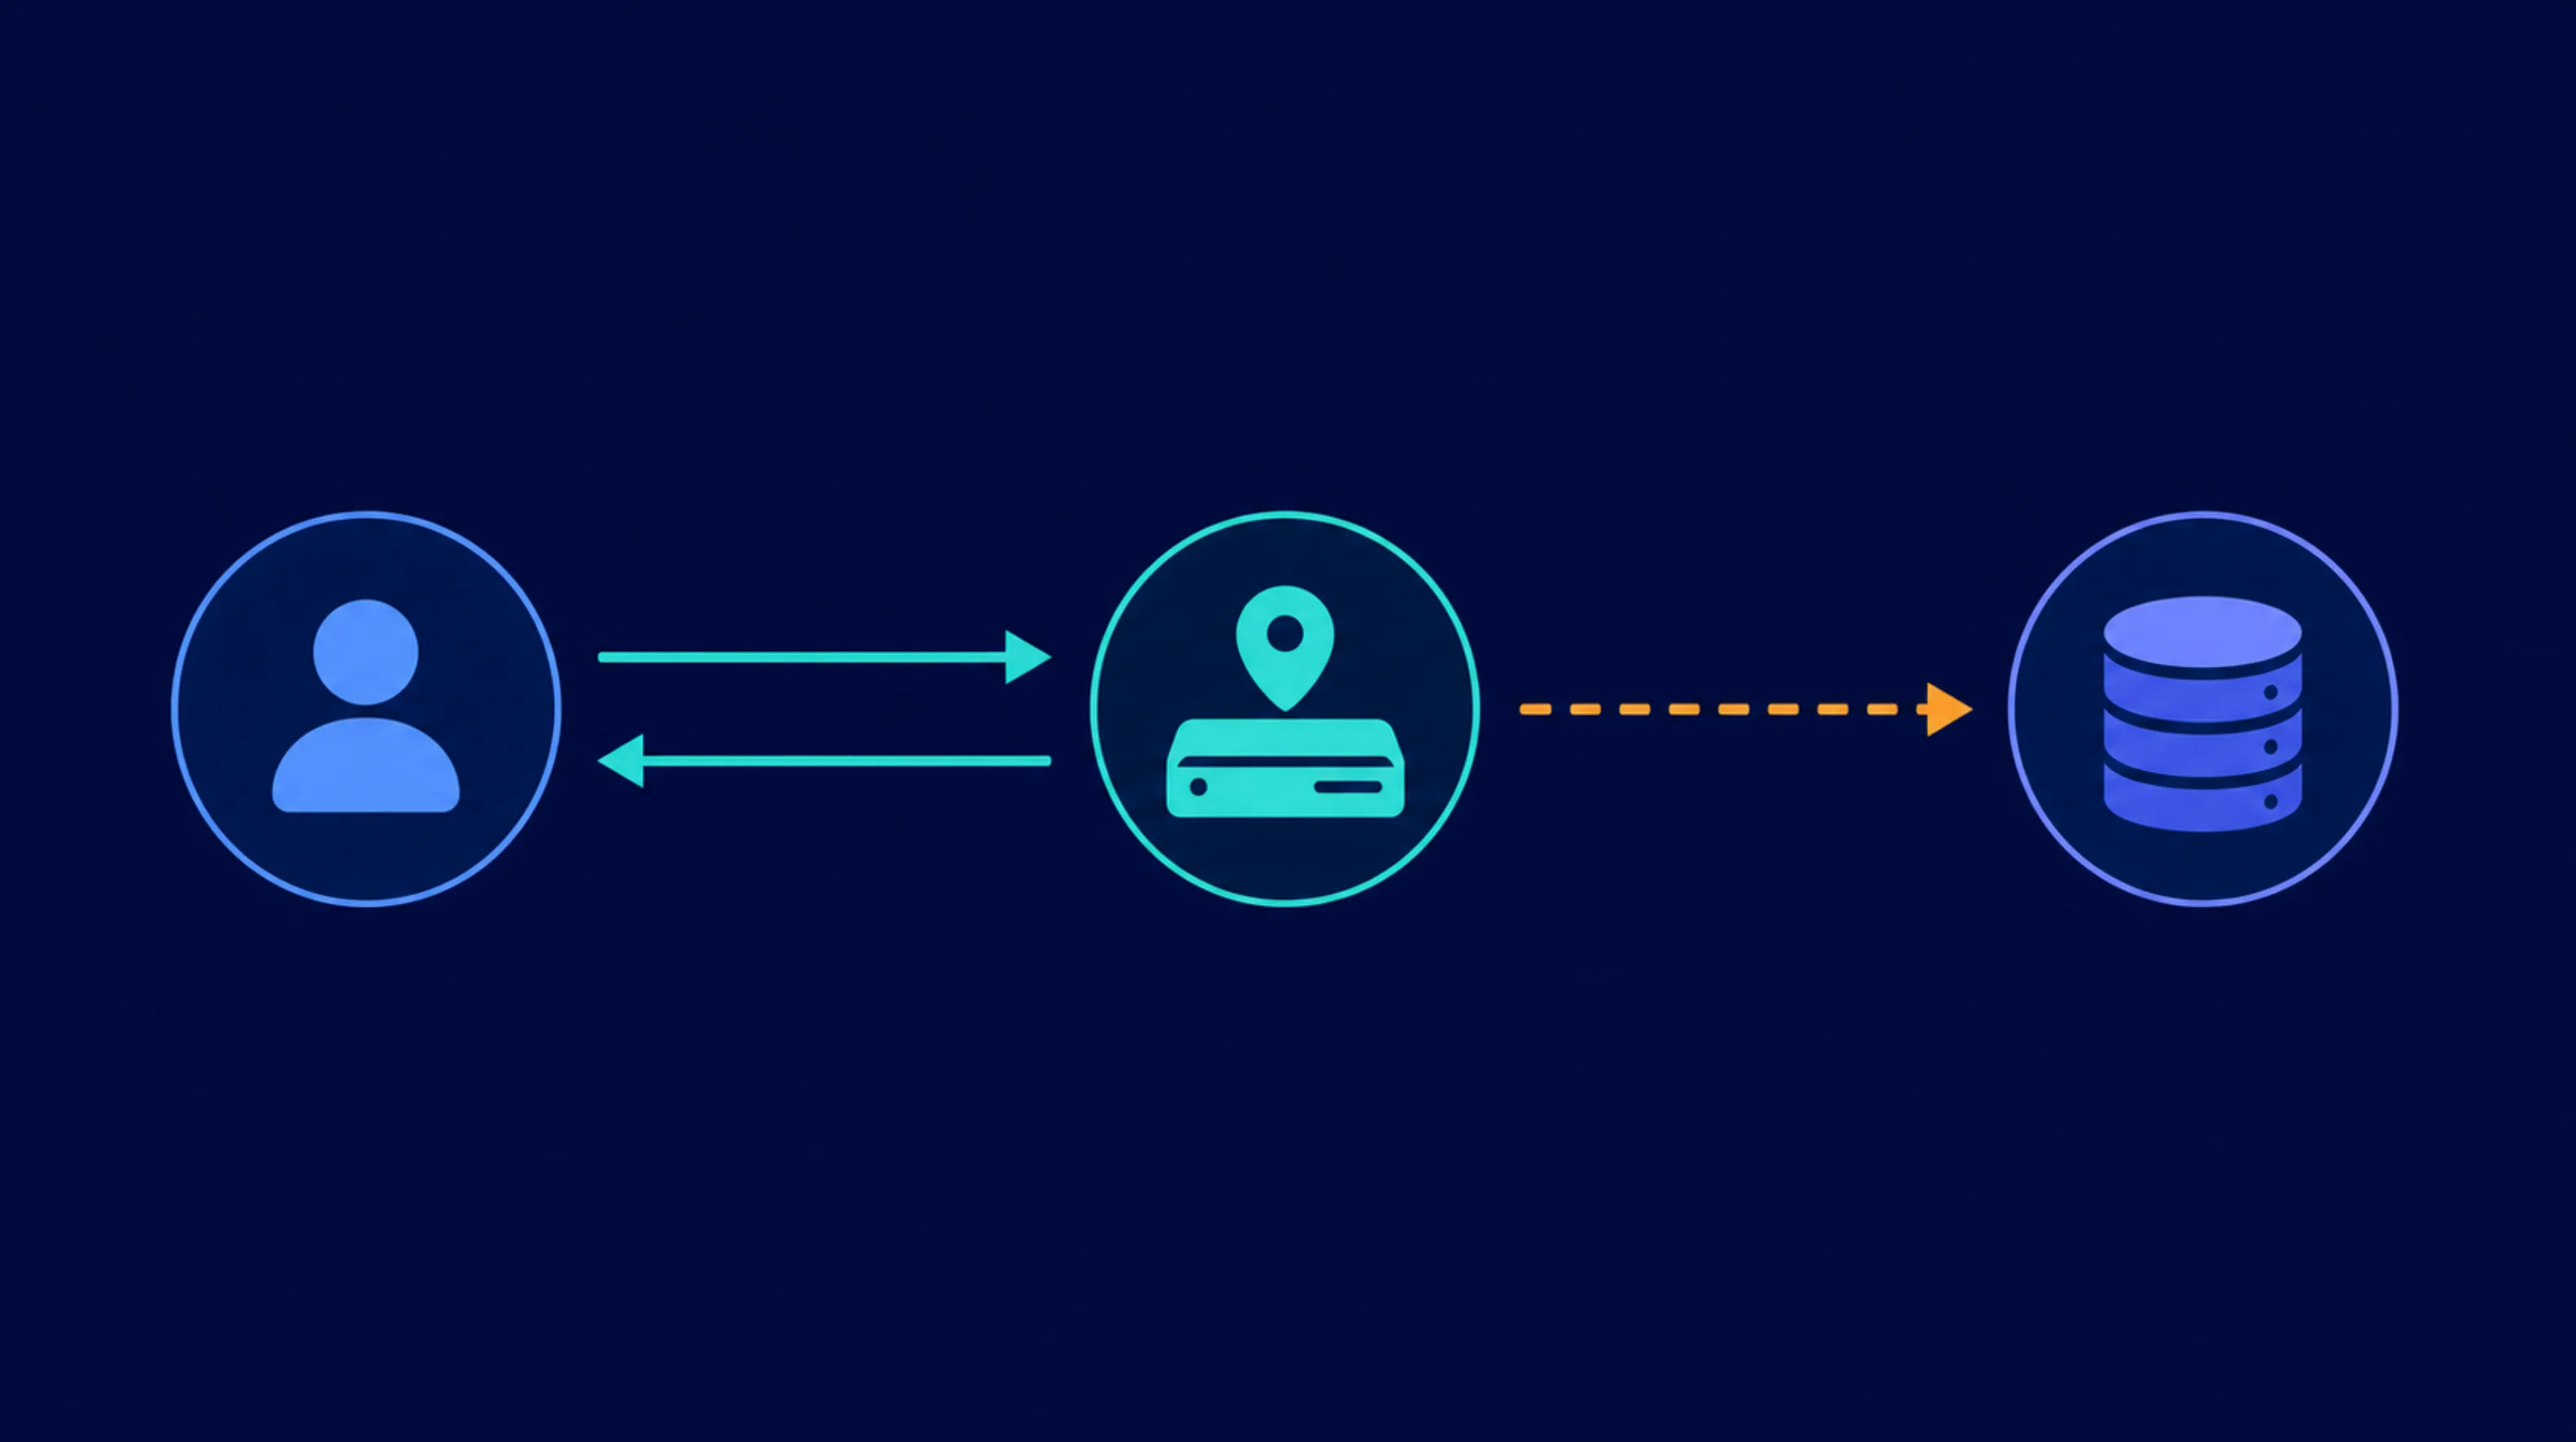
- 中心写入:新写入或修改的数据,会最先保存在中心主存储节点中。
- 边缘分发:某个地区的边缘节点第一次收到该 Key 的读取请求时,会发生冷读取(Cache Miss)并回源抓取;一旦返回成功,该数据便会在当地边缘节点形成本地缓存。
- 极速命中:后续该地区的相同请求,直接在物理距离最近的边缘节点就近返回,响应时间通常只有十几毫秒。
在 Cloudflare Worker 中调用 KV 非常简洁直观:
TypeScript
export interface Env {
  APP_KV: KVNamespace;
}

export default {
  async fetch(request: Request, env: Env): Promise<Response> {
    const key = "site:notice";

    // 写入配置
    if (request.method === "POST") {
      const payload = await request.text();
      await env.APP_KV.put(key, payload);
      return new Response("Saved successfully", { status: 200 });
    }

    // 读取配置(未命中则返回默认值)
    const notice = await env.APP_KV.get(key);
    return Response.json({ notice: notice ?? "No active notice" });
  },
};
2. 免费额度有多少?这组数字已经写明了它的定位
Cloudflare Workers 免费计划为 KV 提供了相当充裕但极具指向性的额度配额:
| 操作类型 | 免费配额(每日重置) | 超额表现 |
| 读取操作 (Read) | 100000 次 / 天 | 抛出配额异常 (429/Error) |
| 写入操作 (Write) | 1000 次 / 天 | 抛出配额异常 (429/Error) |
| 删除操作 (Delete) | 1000 次 / 天 | 抛出配额异常 (429/Error) |
| 列表查询 (List) | 1000 次 / 天 | 抛出配额异常 (429/Error) |
| 总存储容量 | 1 GB | 拒绝写入 |
注:配额在每日 UTC 00:00 统一重置。
⚠️ 两个极易踩坑的隐藏消耗
- 控制台与 CLI 也耗额度:你在 Cloudflare Dashboard 里手动点开查看 Key、或者通过 Wrangler 运行
wrangler kv:key list,每一次查看、写入、扫描同样会计入当天的配额。 - “空查”照样扣费:查询一个根本不存在的 Key(返回
null或 404),仍然会扎扎实实消耗一次 Read 配额,并且“不存在”的判定结果同样会在边缘节点被缓存一段时间。
100000 次读 vs 1000 次写。
这两者之间 100:1 的倾斜比例,赤裸裸地表明了 KV 的基因:专为“低频写入、超高频读取”的边缘静态化场景量身定制。
3. 哪些场景是 KV 的“天命领域”?
如果你的数据具备 “改得极少、查得极多、偶尔延迟几秒同步也死不了人” 的特征,放进 KV 体验极佳:
- 应用全站配置:全局公告、灰度分流比率、维护模式开关、版本强制更新号。
- 低频更新的配置型用户偏好:深色模式选择、展示语言偏好(写一次,每次页面加载都要读)。
- 静态白名单与鉴权元数据:封禁 IP 列表、静态 Token 白名单、特定功能放行名单。
- 第三方接口中继缓存:例如 GitHub Release 数据、汇率牌价、聚合新闻源,TTL 设为数小时,显著减轻上游 API 压力。
实战案例:一个全球访问的营销活动页,需要展示活动规则和各城市开放时间。运营人员一天顶多改一两次规则,但活动页每秒都在被全球成千上万的用户刷新。放进 KV,不仅省下了回源数据库的昂贵并发,还能让全球用户都享受毫秒级的加载速度。
4. 哪些数据碰都不要碰 KV?
很多人图方便,把订单、点赞、库存塞进 KV,结果很快就会被现实上课。以下场景严禁直连 KV:
① 强一致性业务(订单状态、余额、秒杀库存)
KV 依靠最终一致性(Eventual Consistency)来实现全球性能。
当你在东京写入了一个新值,写入位置会很快拿到最新结果;但位于法兰克福或美东节点的边缘缓存,可能需要 60 秒甚至更久 才会过期并同步新数据。如果你把库存扣减放在 KV,不同地区的用户看到的库存数量几乎肯定不同步,超卖不可避免。
② 高频并发写与计数(PV/UV、点赞数、消息流水)
每天只有 1000 次免费写入额度,稍微多几个人点赞就会直接打爆配额。此外,KV 不支持原子自增(INCR),多个并发写入会直接相互盲目覆盖。
③ 事务性操作(多表联合写入)
KV 不具备事务功能。你无法做到“修改 A 的同时修改 B,若 B 失败则自动回滚 A”。一旦网络波动,数据便会陷入状态分裂。
5. 决策自查:3 个问题决定是否用 KV
在为新功能选择存储时,问自己这 3 个问题:
- 同一个 Key 的访问,是否绝大多数都是读(读写比至少 10:1 以上)?
- 业务能否接受全球部分地区在短时间内(十几秒到 1 分钟)读到稍微过期的旧数据?
- 数据写入是否完全独立,不需要事务保证与并发原子操作?
- 三个答案都是“能”$\rightarrow$ 大胆使用 KV,架构极轻,运维成本几乎为零。
- 只要有一个答案是“否”$\rightarrow$ 果断放弃 KV,拥抱其他形态的存储。
以下为在原文 “第 6 节:不选 KV,Cloudflare 生态里还能选什么?” 中增强后的内容。直接用这部分替换或更新你文章中的第 6 节即可:
6. 存储横向对比:KV vs D1 vs Durable Objects
很多开发者在 Cloudflare 生态内纠结选型,本质上是因为这三者代表了三种完全不同的架构设计哲学:
- Workers KV:牺牲一致性,换取极致的全球就近读取与轻量化。
- D1 (Serverless SQL):传统的结构化关系型数据模型,主从架构,兼顾 SQL 查询与事务。
- Durable Objects (DO):内存协同 + 强一致持久化,专为高并发分布式协同与状态机设计。
| 评估维度 | Workers KV | Cloudflare D1 | Durable Objects (DO) |
| 数据模型 | Key-Value(键值对) | 关系型 SQL(基于 SQLite 引擎) | 状态机/内存对象 + 键值/SQL 存储 |
| 数据一致性 | 最终一致性 (Eventual) 全球节点可能延迟数秒至 60 秒生效 | 读后写一致 / 事务级一致 写入立刻一致,副本读取逐步同步 | 严格强一致性 (Strong) 全局单实例调度,无并发冲突 |
| 事务与原子操作 | 不支持 并发写相互覆盖 | 支持完整 ACID 事务BEGIN TRANSACTION | 天然支持 单线程事件循环处理,操作具原子性 |
| 读取延迟 | 极低(毫秒级) 直接在就近边缘节点命中缓存 | 低至中等 边缘就近读副本,或回源主库 | 取决于物理距离 请求需路由到该对象实例所在的单个数据中心 |
| 写入性能与成本 | 中心写入相对慢,每日配额严格 | 写入走主库,支持批量导入 | 高速内存写入 + 异步/同步持久化 |
| 免费计划配额 | • 读:100000 次 / 天 • 写:1000 次 / 天 • 容量:1 GB | • 读:500 万行 / 天 • 写:100000 行 / 天 • 容量:5 GB | • 请求:100000 次 / 天 • 运行时长:13000 GB-s / 天 • 存储容量:1 GB |
| 最适合场景 | • 全站公告与开关 • 静态配置与白名单 • 低频更新的第三方 API 缓存 | • 用户注册/登录表 • 文章与内容管理系统 (CMS) • 多条件过滤与关联查询业务 | • 实时在线协同(多人协作白板/文档) • 全局秒杀库存与精确计数器 • 房间聊天室与 WebSocket 状态管理 |
| 核心避坑点 | 严禁用于秒杀库存、高频递增计数、交易账单 | 存储上限默认 10GB/库,不适合海量非结构化静态缓存 | 对跨半球访问有一定延迟(因全局单实例),需要合理设计分片 |
一句话决策指南
- 如果只是要读个静态配置/公共开关,写得极少,无脑选 Workers KV。
- 如果需要建表、查条件、做登录注册、做关联业务,直接选 Cloudflare D1。
- 如果需要抢名额、扣库存、防重入、做多人实时联机,必须选 Durable Objects。
总结
Cloudflare KV 最被低估的价值,并不是它每天白送了 10 万次读取,而是它把原本需要自建数据库、Redis 缓存节点外加一套 CDN 全球分发的重型架构,提炼成了一个轻量简洁的云原生 API。
但白嫖神器也有坚固的边界。
KV 从来不是数据库,它只是一个被推到全球边缘、专为读取优化的静态储物格。 厘清边界,顺着它的特性去写代码,它才是你的省钱利器。

文章评论