我日常有一半的脚本在干同一件事:看一眼状态,然后决定走哪条路。这条日志该不该告警,这个工单归哪个组,这段报错算不算阻塞。
用聊天模型做这些,体验一直很别扭。我想要一个 technical,它给我三百字分析,我再写正则去抠。想要一个置信度,它自己报一个 0.9,我并不知道这个 0.9 是怎么来的。
Cloudflare 上个月开源了 Clef,思路是把「判断」从「生成」里拆出来:不输出文本,只输出每个选项的概率。llama.cpp 三天内就跟进了 /v1/systemone 端点,一条命令本地能跑。下面这篇笔记,一半是模型本身的机制,一半是别人的实测数据——我把能验证的部分核了一遍,也标出了哪些结论只在特定硬件上成立。
它到底做了什么
普通模型做分类的流程是:读 prompt,逐 token 生成一段话,你从话里解析答案。慢,而且答案的可靠性取决于它有没有听话。
Clef 冻结了 Qwen 基座,只训练两块东西:一个 rank-256 的 LoRA,和一个联合 schema 打分头。推理时只跑 prefill,一个字都不生成。打分头直接读骨干网络的最终隐藏状态,先把每个选项相关的证据从 state 里路由出来,再对所有问题的所有选项做联合打分,每个合法选项出一个 logit,softmax 完就是概率。
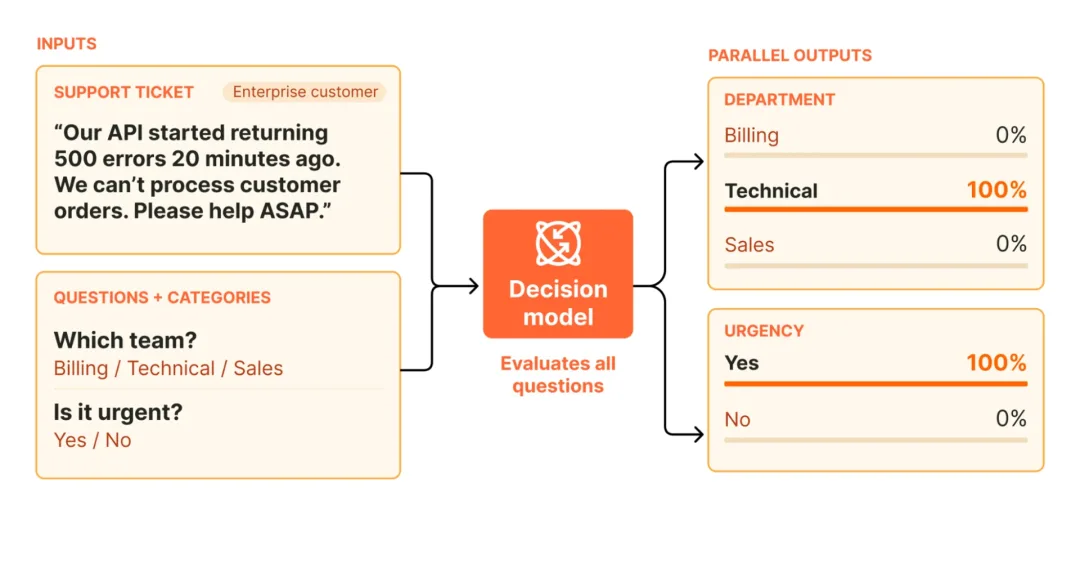
输入是两样东西:state(文本、JSON,甚至图片)和一组类型化问题。问题只有三种:
choice:从命名选项里选一个,返回各选项概率和置信度score:按有序等级打分,返回期望分数和置信度noul:是非判断,返回为真的概率
关键在于「问题相互独立」。加一个问题几乎不增加延迟,也不会让前面的判断跑偏。这一点在工程上比准确率更重要——它意味着你可以把判断拆到最细,组合逻辑放在自己的代码里。
为什么值得关注
我关心的不是又一个开源模型,是它带来的分工方式。
Agent 工作流里有大量「该走哪条路」的瞬间,这些瞬间根本不需要一段散文。以前我们只能用大模型硬扛,代价是延迟、成本和不可控的输出格式。现在多了一类专门干这个的模型,38 毫秒出结果,输出是代码能直接消费的结构。
Cloudflare 自己在用。威胁情报团队做域名分类,抓网页加判断整个流程 2.2 秒,输出多个类别的概率;同样的流程换成 gpt-oss-120b 要 4.7 秒,还只给两个分类。
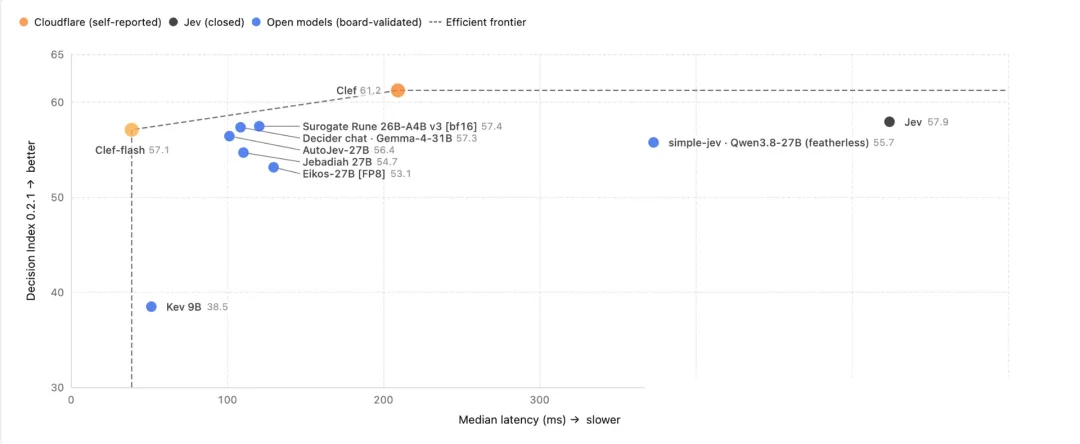
跑分上它在 Decision Index 0.2.1 排第一,但我不太在意榜一。我关心的是两个数字:BFCL 函数调用 98.8,BANKING77 意图分类 90.9。这两个恰好是我日常要做的判断。
本地部署,第一个坑
官方在 Hugging Face 放了 GGUF,也同步到了 ModelScope。国内网络直接下 ModelScope 的版本更省事:
llama-server -m ./Clef-Flash-Q4_K_M.gguf --port 8000 -b 4096 -ub 4096
有个坑值得提前说:bartowski 的量化版(5.84GB)发布得早、下载量高,但启动正常,一调 /v1/systemone 就返回 501:This model is not a decision model。
原因很明确:server 是靠 GGUF 元数据里的 clef.decision.type 判断这是不是决策模型的。bartowski 那份是在 Clef 支持合并之前转的,只有骨干网络的 427 个张量,缺了 160 个打分头张量。用 --override-kv 改元数据也没用,文件里根本没有那些权重。
必须用 ggml-org 官方转换的那份,或者拿最新 convert 脚本自己从 HF 权重转。
不过这份文件也不是白下:它可以当普通生成模型跑,正好构成一组对照——「生成 JSON 再解析」和「打分头直接出概率」到底差多少。下面的数据来自原作者在 RTX 4070 Ti SUPER 上的实测,我按接口文档核对了字段和语义。
两条路的实测对比
测试场景是工单分流。一段 502 故障描述,问三个问题:归哪个团队、紧急程度、是不是服务中断。
玩法一,生成模式。 用 chat completions,写一段提示词要求输出 JSON,开了 response_format: json_object 约束语法。
生成模式的结果不太好看。模型返回 {"department": "technical", "urgency":2, out:true},outage 被写成了 out,置信度三个字段全是 0.0。生成耗时 5.0 秒。
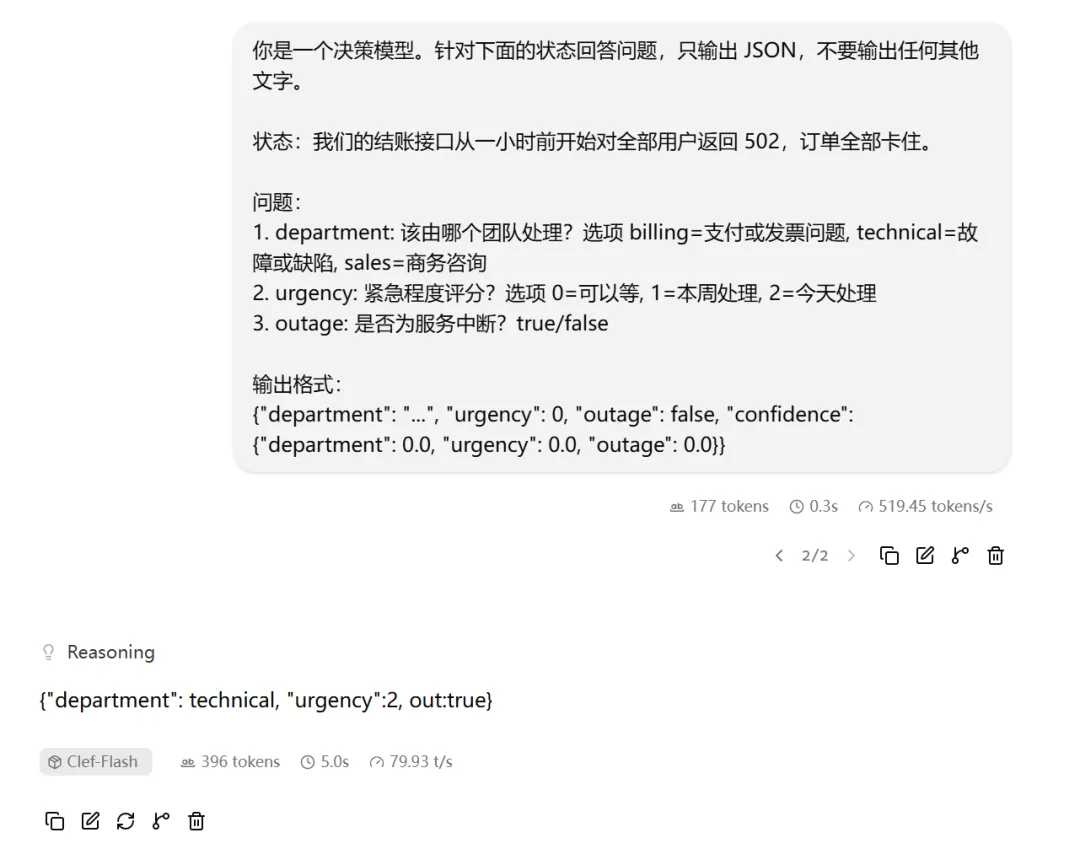
语法约束能保证它是合法 JSON,但保证不了字段名对、保证不了置信度有意义。这三个 0.0 就是模型「自报」的数字,跟真实概率没有关系。
玩法二,原生接口。 换成官方 GGUF,直接 POST /v1/systemone,没有提示词,没有解析。
{
  "state": "我们的结账接口从一小时前开始对全部用户返回 502,订单全部卡住。",
  "questions": {
    "department": {"type": "choice", "instructions": "该由哪个团队处理?",
      "criteria": {"billing": "支付或发票问题", "technical": "故障或缺陷", "sales": "商务咨询"}},
    "urgency": {"type": "score", "instructions": "紧急程度如何?",
      "criteria": ["可以等", "本周处理", "今天处理"]},
    "outage": {"type": "noul", "instructions": "是否为服务中断?"}
  }
}
返回:
department [choice] => technical (confidence 0.88)
             概率 billing 0.07 / sales 0.01 / technical 0.92
urgency    [score]  => 1.59 (confidence 0.38)
             概率 可以等 0.16 / 本周处理 0.10 / 今天处理 0.75
outage     [noul]   => P(true) = 0.90
usage: input_tokens 328, output_tokens 0
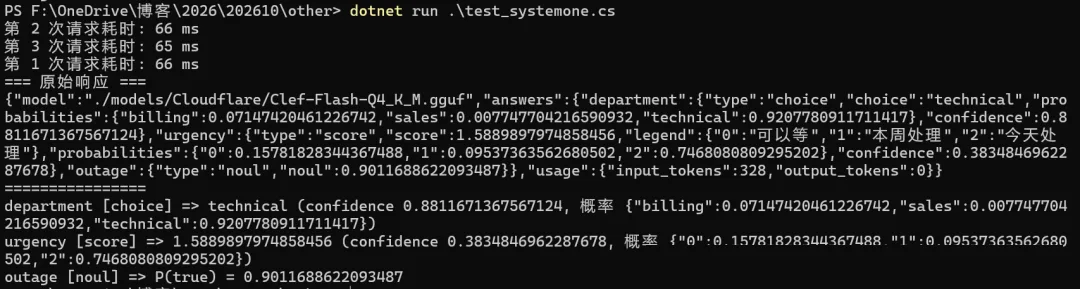
三题全部符合直觉,而且 output_tokens 是 0——它真的一个字都没生成。
有两个细节值得说。score 返回 1.59 而不是整数,这是按概率加权的期望级别,落在「本周」和「今天」之间,信息量比硬分类大。置信度是打分头算出来的,可以直接拿来做门控:低于 0.6 转人工,或者转给大模型兜底。
但官方也提醒了,概率是按模型文件里存好的温度缩放的,在你的数据上不一定校准过。门控阈值要拿自己的业务数据标定,不能照抄。
延迟和参数
RTX 4070 Ti SUPER,连续请求,单次稳定在 64~92ms(328 个输入 token,三个问题一次答完)。服务启动后第一次请求约 500ms,是计算图编译的一次性开销。
这个数字和官方宣传的 38.8ms 已经在同一量级,人家用的是 H200。
原作者顺手测了一轮参数:--flash-attn 开不开没差别,-b 4096 -ub 4096 加上去也没差别,把参数全砍掉,输出概率逐位一致,显存都是 8.1GB。原因不复杂,决策请求的耗时几乎全是 prefill,纯算力瓶颈,模型权重和计算图是固定的,-ngl、-c、-t 这些参数碰不到瓶颈。
真正影响的只有两件事:prompt 的 token 数和 GPU 算力。这一点和我自己跑其他 prefill 密集型任务的体感一致:batch 相关的参数在单次前向里没有发挥空间。
但有一个参数对「能不能跑」至关重要:-ub。Clef 要求整个 prompt 在一个物理 batch 里算完,默认只有 512。他测过 980 token 的 prompt,直接 HTTP 500,报 input is too large to process。所以启动命令必须带 -ub 4096,-b 要不小于 -ub,两个一起给。
我会怎么用它
我不会拿它替掉主力模型。它解决的是另一类问题。
我打算把自己脚本里凡是「看一眼然后分支」的地方,逐步迁到 /v1/systemone 上。日志分级、告警去重、工单路由、意图识别,这些判断以前要么写规则要么调大模型,现在多了一个 60ms 的选项,输出还带概率。
真正的价值在编排:决策模型负责在关键节点快速给出带概率的判断,大模型负责需要解释和生成的部分,代码在中间做路由。低于阈值的交给大模型,高于阈值的直接执行。
Apache 2.0,可商用,9B 的 Q4 只要 8GB 显存。对个人开发者来说,这就是一台不用付 API 费的分类器。
数据说明:文中 64~92ms 延迟、8.1GB 显存、980 token 报 500 等实测数字,来自原作者的 RTX 4070 Ti SUPER 环境;模型机制、接口语义与返回结构我按 llama.cpp 服务端文档和 Cloudflare 官方博客核对过。换硬件、换量化等级,延迟会变,结论的方向不会。

文章评论