过去几十年,数据库的核心问题一直是同一个:怎么更快、更可靠、更便宜地存和读。传统做法依赖本地 SSD、云盘或者专门的存储集群。对象存储(S3、GCS)虽然容量大、便宜、持久性高,但一直当不了数据库的底座——延迟高、按请求计费、只支持整体覆盖写,和数据库需要的随机小写完全不搭。
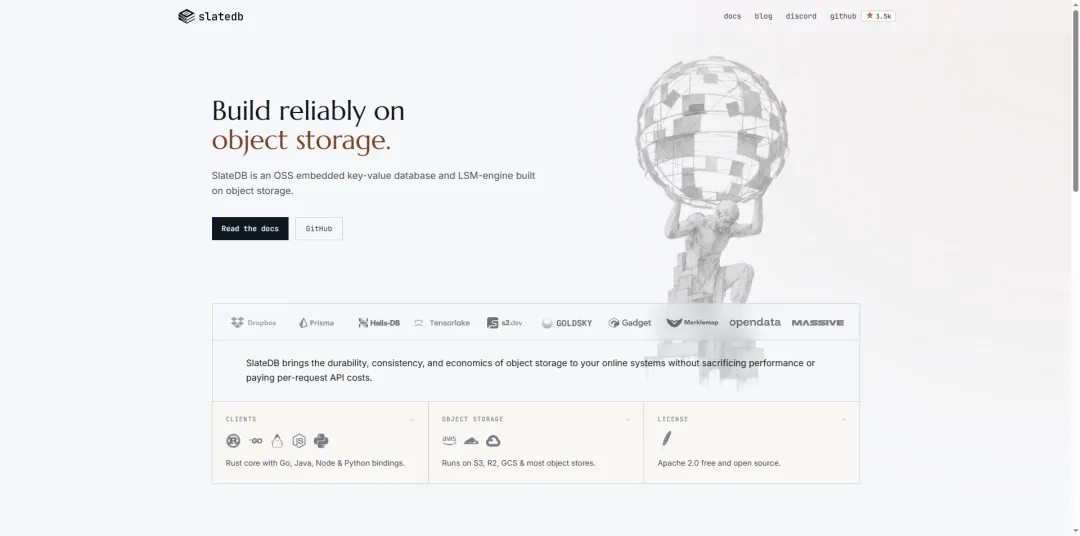
SlateDB 想试的就是这件事:能不能绕开本地磁盘那一套,直接把对象存储做成数据库的持久化层。它用 Rust 写,LSM Tree 做核心结构,Apache 2.0 开源。
先说清楚它是什么
SlateDB 是一个嵌入式键值存储引擎。嵌入式意味着它不是一个独立服务,而是以库的形式编进你的程序里,应用直接调它的接口,不用额外部署一个数据库进程。
和 RocksDB 这类成熟引擎最大的区别在于数据最终落在哪。RocksDB 依赖本地文件系统,SlateDB 把 SST 文件写到 S3、GCS、Azure Blob、MinIO 这类对象存储上。
这不是把文件换个地方存那么简单。对象存储的写入是整对象覆盖、读取有稳定延迟、按请求收费,数据库要在这套约束下重新设计写入、缓存、并发控制和后台合并。SlateDB 干的就是这件事。
为什么值得把数据库架在对象存储上
有两个变化是实打实的。
第一,计算和存储可以彻底分开。数据不在本地盘上,节点重启、替换、扩容时不用搬数据,本地状态管理的复杂度大幅下降。这对容器化和弹性伸缩是根本性的改善。
第二,扩容方式变了。数据放对象存储,计算资源和缓存按需配,不必把所有数据都塞进昂贵的本地 SSD。冷数据留在对象存储里,热数据靠缓存顶住。
代价也很明确:延迟更高,频繁小请求会带来额外费用。所以直接把每次写入都翻译成一次对象存储请求,是行不通的。SlateDB 的全部设计都在解决这个矛盾。
LSM Tree 为什么天生适配对象存储
LSM Tree 不是新技术,RocksDB、LevelDB 都用。核心思想是把写入先攒在内存里,批量生成有序的数据文件,而不是每次修改都直接更新磁盘结构。
写一条记录,先进 MemTable,配合 WAL 保证可恢复。攒到一定量,整理成有序的 SST 文件,再写到对象存储。数据多了之后靠 Compaction 合并整理,减少冗余、改善读效率。
这套流程和对象存储的特性高度契合:对象存储喜欢批量写不可变对象,LSM Tree 天然就把大量修改组织成批量文件操作。所以 SlateDB 不是「把 RocksDB 的文件挪个地方」,而是围绕对象存储重新设计了一遍。
Rust 在这里解决什么问题
不是为了跑分。存储引擎这种底层系统,Rust 的价值在三个地方:内存安全不用靠 GC,避免 GC 停顿带来的延迟毛刺;所有权模型让并发状态管理在编译期就能查出问题;异步生态成熟,适合大量等待 I/O 的场景。
SlateDB 的读写全程涉及对象存储请求,异步执行能让程序在等网络的时候干别的。但异步不等于更快,实际性能还是取决于对象存储延迟、缓存命中率、数据布局、并发度和批处理策略。
它怎么对付对象存储的性能问题
写入侧的核心是批量。多次修改先攒起来,定期生成 SST 文件再上传,把 N 次小请求压成一次大请求。
读取侧用的是 LSM 的常规优化组合:内存块缓存、压缩、Bloom Filter,以及可选的本地磁盘缓存。各自解决不同问题——缓存减少重复读对象存储的次数,Bloom Filter 快速判断某个 SST 是否可能包含目标键,压缩降低存储和传输成本,Compaction 改善文件组织。
并发模型是原生单写入者、多读取者。多个读节点可以同时访问同一个数据库,写入者隔离机制防止失效或过期的写进程继续改数据。此外支持事务和快照隔离,所以它不只是一个对象存储的读写封装。
需要提醒的是适用范围:官方文档把「能接受约 50—100 毫秒写入延迟」列为适用场景的参考之一,这不是性能保证,实际延迟取决于对象存储服务、配置和工作负载。如果你的场景要求个位数毫秒写入,它不合适。
开源与语言支持
Apache License 2.0,源码在 GitHub。除 Rust 外,官方提供 Go、Java、Node.js、Python 绑定,不必为了用它把整个应用改写成 Rust。
不过不同绑定的实现方式、运行时依赖和版本要求可能有差异,用之前先看对应语言的快速入门。对 Rust 开发者来说,更有价值的是读它的源码——LSM、异步 I/O、对象存储抽象、缓存策略、事务与一致性控制,是一个很完整的现代存储系统样本。
适合什么场景
它不打算取代 PostgreSQL、MySQL 或 RocksDB。适合的是那些能容忍一定对象存储延迟、又想拿到对象存储持久化和成本优势的应用。
几个典型场景:流处理系统需要持久化中间状态;工作流引擎需要保存任务进度;Serverless 应用需要存执行状态;缓存系统需要在节点变化后仍然保留数据。这些都能从「计算与持久化分离」里受益。
对 AI Agent 基础设施来说也值得看。一个大规模 Agent 平台要保存执行状态、任务元数据、检查点、可恢复的工作流信息,SlateDB 的嵌入式接口加对象存储持久化,是一个值得评估的选项。
但它不是向量数据库,也不能直接替代完整的关系型数据库。适不适合你的 Agent Memory 或任务存储,要结合查询模式、并发写入、一致性要求和延迟目标去验证。
我的判断
这类项目的意义不在于「又一个数据库」,而在于它把一条被默认接受的假设拆掉了:持久化必须落在本地盘上。
一旦这条假设松动,很多架构会跟着变。计算节点变成完全无状态,扩缩容不再需要数据搬迁,备份变成对象存储层面的版本管理。代价是延迟和请求成本,收益是运维复杂度的数量级下降。
现在还不是把它放进生产的时候,但值得放进观察清单。如果你的系统里有一块「写不频繁、读很多、状态必须持久」的数据,它就是最合适的试验田。

文章评论