表空间监控最容易犯的错,是把「当前实际大小」和「最大可扩展大小」混在同一个阈值里。固定大小表空间看到 90% 就该扩容;自动扩展表空间看到 90%,可能只是还没长到 MAXBYTES。等真正写满,报错已经是 ORA-01653 或 ORA-01654,业务先受影响。
第二类问题是 SYSAUX 不明原因膨胀。它不放业务数据,却能被 AWR 的 WRH$ 表撑到几十 G。清理不能直接 delete,也不能随便 drop 分区,正确路径是先让快照边界对齐分区边界,再按 snap_id 范围删除。
下面先给三套监控 SQL 及适用场景,再用一个 SYSAUX 涨到 55G 的现场走完定位、分区拆分和清理。
一、先确认表空间属于哪种类型
分水岭是 dba_data_files.maxbytes:
MAXBYTES = 0:固定大小,数据文件不会自动增长,监控基数用bytes。MAXBYTES > 0:自动扩展,能长到MAXBYTES,监控基数用MAXBYTES。
同一个库里两种表空间可能并存。用固定口径监控自动扩展表空间,会长期低报;用 MAXBYTES 监控固定表空间,使用率永远上不去。
先确认数据文件的真实状态:
set linesize 300
col tablespace_name for a26
col file_name for a130
col autoextensible for a5
select tablespace_name,file_name,autoextensible,bytes/1024/1024/1024 GB from dba_data_files where tablespace_name='SYSTEM';
输出:
TABLESPACE_NAME   FILE_NAME                                                 AUTOE     GB
----------------- --------------------------------------------------------- ----- ------
SYSTEM            /data/VOLTAGEDB/datafile/o1_mf_system_hdwbg1l3_.dbf       YES        2
这个例子很典型:文件当前 2G,AUTOEXTENSIBLE=YES,按 MAXBYTES 汇总出来是 32G。只看 2G 会以为很空,只看 32G 又会以为没有风险。两个口径要分开用,不能互相替代。
二、固定大小表空间:按实际分配监控
2.1 总体使用率
set linesize 150
set pagesize 999
col tablespace_name format a50
select a.tablespace_name,a.bytes/1024/1024 "Sum MB",(a.bytes-b.bytes)/1024/1024 "used MB",b.bytes/1024/1024 "free MB",round(((a.bytes-b.bytes)/a.bytes)*100,2) "percent_used"
from (select tablespace_name,sum(bytes) bytes from dba_data_files group by tablespace_name) a,
(select tablespace_name,sum(bytes) bytes,max(bytes) largest from dba_free_space group by tablespace_name) b where a.tablespace_name=b.tablespace_name
order by ((a.bytes-b.bytes)/a.bytes) desc ;
输出:
TABLESPACE_NAME     Sum MB    used MB    free MB   percent_used
----------------- ---------- ---------- ---------- ------------
SYSAUX              22588    20639.9375  1948.0625        91.38
SYSTEM              2048     1628.8125   419.1875         79.53
USERS               5        2.6875      2.3125           53.75
UNDOTBS1            5120     52.625      5067.375          1.03
这条语句用内连接关联 dba_data_files 和 dba_free_space,刚创建、还没有分配 extent 的表空间不会出现在结果里。做全量巡检时建议改成外连接,或者直接用第四节的视图。
2.2 只报「使用率超过 90% 且剩余低于 20G」
SELECT
    b.tablespace_name,
    b.autoextensible,
    b.total AS Sum_MB,
    (b.total - NVL(a.free, 0)) used_MB,
    NVL(a.free, 0) AS free_MB,
    ROUND((b.total - NVL(a.free, 0)) / b.total * 100, 2) AS percent_used
FROM (
    SELECT
        tablespace_name,
        SUM(bytes)/1024/1024 AS free
    FROM dba_free_space
    WHERE tablespace_name NOT LIKE '%UNDO%'
    GROUP BY tablespace_name
) a
RIGHT JOIN (
    SELECT
        tablespace_name,
        SUM(bytes)/1024/1024 AS total,
        autoextensible
    FROM dba_data_files
    WHERE tablespace_name NOT LIKE '%UNDO%'
    GROUP BY tablespace_name, autoextensible
) b
ON a.tablespace_name(+) = b.tablespace_name
WHERE ROUND((b.total - NVL(a.free, 0)) / b.total * 100, 2) > 90
  AND NVL(a.free, 0) < 20480;
输出:
  TABLESPACE_NAME   AUT   SUM_MB     USED_MB    FREE_MB  PERCENT_USED
------------------- --- ---------- ---------- ---------- ------------
SYSAUX              NO    22588    20639.9375  1948.0625        91.38
20G 是绝对值,不是百分比,适合大表空间;小表空间会被这条规则漏掉。阈值要按库的规模调整,不能直接照搬。
这条 SQL 把 ANSI 的 RIGHT JOIN 和 Oracle 的 (+) 写在了同一个 ON 条件里。Oracle 不允许两种外连接语法混用,执行会报:
ORA-25156: old style outer join (+) cannot be used with ANSI joins
保留这条 SQL 的同时,实际使用时删掉 (+) 即可:
ON a.tablespace_name = b.tablespace_name
2.3 需要精确到数据文件时
表空间级使用率只能说明「该扩容了」,不能说明「扩哪个文件」。进一步定位时查 dba_data_files 的 autoextensible、maxbytes、increment_by,再结合 dba_free_space 看最大连续空闲块。碎片严重时,总量够但最大连续块不够,照样会报 ORA-01653。
三、自动扩展表空间:按 MAXBYTES 监控
3.1 使用率的分母是上限
SELECT
    total.tablespace_name AS "tablespace_name",
    to_char(round(total.total_bytes / 1024 / 1024 / 1024, 3), 'fm99990.0099') AS "total_gb",
    to_char(round(total.now_bytes / 1024 / 1024 / 1024, 3), 'fm99990.0099') AS "now_gb",
    to_char(round(free.free_bytes / 1024 / 1024 / 1024, 3), 'fm99990.0099') AS "free_gb",
    to_char(round((total.now_bytes - free.free_bytes) / total.total_bytes * 100, 2), 'fm99990.0099') AS "used_rate"
FROM (
    SELECT
        tablespace_name,
        SUM(CASE MAXBYTES WHEN 0 THEN bytes ELSE MAXBYTES END) AS total_bytes,
        SUM(bytes) AS now_bytes
    FROM dba_data_files
    GROUP BY tablespace_name
) total
JOIN (
    SELECT
        tablespace_name,
        SUM(bytes) AS free_bytes
    FROM dba_free_space
    GROUP BY tablespace_name
) free ON total.tablespace_name = free.tablespace_name
JOIN dba_tablespaces t ON free.tablespace_name = t.tablespace_name
WHERE
    t.contents <> 'UNDO'
    AND t.contents <> 'TEMPORARY';
输出:
tablespace_name   total_gb   now_gb   free_gb     used_rate
---------------- ---------- -------- ----------- -----------
SYSTEM            32.00      2.00      0.409       4.97
SYSAUX            32.00      22.059    1.906       62.98
USERS             32.00      0.005     0.002       0.01
关键在 SUM(CASE MAXBYTES WHEN 0 THEN bytes ELSE MAXBYTES END):固定大小取实际,自动扩展取上限。now_gb 是当前已分配,free_gb 是表空间内空闲,used_rate = (now - free) / total。所以它回答的是「离写满上限还有多远」,不是「当前文件用了多少」。
3.2 超过 90% 告警
SELECT
    total.tablespace_name AS "tablespace_name",
    to_char(round(total.total_bytes / 1024 / 1024 / 1024, 3), 'fm99990.0099') AS "total_gb",
    to_char(round(total.now_bytes / 1024 / 1024 / 1024, 3), 'fm99990.0099') AS "now_gb",
    to_char(round(free.free_bytes / 1024 / 1024 / 1024, 3), 'fm99990.0099') AS "free_gb",
    to_char(round((total.now_bytes - free.free_bytes) / total.total_bytes * 100, 2), 'fm99990.0099') AS "used_rate"
FROM (
    SELECT
        tablespace_name,
        SUM(CASE MAXBYTES WHEN 0 THEN bytes ELSE MAXBYTES END) AS total_bytes,
        SUM(bytes) AS now_bytes
    FROM dba_data_files
    GROUP BY tablespace_name
) total
JOIN (
    SELECT
        tablespace_name,
        SUM(bytes) AS free_bytes
    FROM dba_free_space
    GROUP BY tablespace_name
) free ON total.tablespace_name = free.tablespace_name
JOIN dba_tablespaces t ON free.tablespace_name = t.tablespace_name
WHERE
    t.contents <> 'UNDO'
    AND t.contents <> 'TEMPORARY'
    AND round((total.now_bytes - free.free_bytes) / total.total_bytes * 100, 2) > 90;
输出:
no rows selected
没有结果不代表安全。如果 MAXBYTES 设成 32G,而磁盘只剩 5G,使用率仍然很低,写满时先在存储层或 ORA-01653 上报错。容量监控要同时看 MAXBYTES 之和与所在文件系统/ASM 磁盘组的剩余空间。
3.3 给监控 agent 的格式化输出
set linesize 300
set heading off;
SELECT
    total.tablespace_name || '@tablespace_name' AS "tablespace_name",
    to_char(round(total.total_bytes / 1024 / 1024 / 1024, 3), 'fm99990.0099') || 'G' || ':total_gb' AS "total_gb",
    to_char(round(total.now_bytes / 1024 / 1024 / 1024, 3), 'fm99990.0099') || 'G' || ':now_gb' AS "now_gb",
    to_char(round(free.free_bytes / 1024 / 1024 / 1024, 3), 'fm99990.0099') || 'G' || ':free_gb' AS "free_gb",
    to_char(round((total.now_bytes - free.free_bytes) / total.total_bytes * 100, 2), 'fm99990.0099') || '%:used_rate##' AS "used_rate"
FROM (
    SELECT
        tablespace_name,
        SUM(CASE MAXBYTES WHEN 0 THEN bytes ELSE MAXBYTES END) AS total_bytes,
        SUM(bytes) AS now_bytes
    FROM dba_data_files
    GROUP BY tablespace_name
) total
JOIN (
    SELECT
        tablespace_name,
        SUM(bytes) AS free_bytes
    FROM dba_free_space
    GROUP BY tablespace_name
) free ON total.tablespace_name = free.tablespace_name
JOIN dba_tablespaces t ON free.tablespace_name = t.tablespace_name
WHERE
    t.contents <> 'UNDO'
    AND t.contents <> 'TEMPORARY';
输出:
SYSTEM@tablespace_name    32.00G:total_gb   2.00G:now_gb        0.409G:free_gb       4.97%:used_rate##
SYSAUX@tablespace_name    32.00G:total_gb   22.059G:now_gb      1.902G:free_gb       62.99%:used_rate##
USERS@tablespace_name     32.00G:total_gb   0.005G:now_gb       0.002G:free_gb       0.01%:used_rate##
set heading off 去掉列名,@tablespace_name 作为记录分隔,:total_gb 这种后缀作为字段名,## 作为整行结束符。这样监控 agent 不需要依赖列宽和空格对齐,按分隔符解析即可。
四、DBA_TABLESPACE_USAGE_METRICS:日常巡检首选
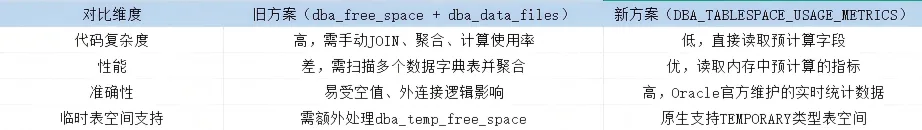
这个视图按 block 计数,需要 join dba_tablespaces 拿 block_size 换算成 MB。它直接给出 tablespace_size、used_space、used_percent,不需要自己聚合 dba_free_space。
SELECT
    m.tablespace_name,
    ROUND(m.tablespace_size * ts.block_size / 1024 / 1024, 2) AS total_MB,
    ROUND(m.used_space * ts.block_size / 1024 / 1024, 2) AS used_MB,
    ROUND((m.tablespace_size - m.used_space) * ts.block_size / 1024 / 1024, 2) AS free_MB,
    ROUND(m.used_percent, 2) AS percent_used
FROM dba_tablespace_usage_metrics m
JOIN dba_tablespaces ts
    ON m.tablespace_name = ts.tablespace_name
WHERE ts.contents NOT IN('UNDO','TEMPORARY');
输出:
TABLESPACE_NAME  TOTAL_MB   USED_MB   FREE_MB   PERCENT_USED
--------------- ---------- --------- --------- ---------------
SYSTEM           32767.98   1628.81   31139.17      4.97
SYSAUX           32767.98   20642.69  12125.3       63
TEMP             5120       0         5120          0
USERS            32767.98   2.69      32765.3      .01
注意 SYSTEM 实际数据文件只有 2G,视图里的 TOTAL_MB 却是 32767.98,与 MAXBYTES 上限一致。也就是说,在这个环境里视图按「可扩展到的大小」计算,而不是当前文件大小。不同版本、不同补丁下这个行为要以现场输出为准,不能拿它和 dba_data_files.bytes 直接对账。
4.1 带阈值的告警版
SELECT
    m.tablespace_name,
ROUND(m.tablespace_size * ts.block_size / 1024 / 1024, 2) AS total_MB,
    ROUND(m.used_space * ts.block_size / 1024 / 1024, 2) AS used_MB,
    ROUND((m.tablespace_size - m.used_space) * ts.block_size / 1024 / 1024, 2) AS free_MB,
    ROUND(m.used_percent, 2) AS percent_used
FROM dba_tablespace_usage_metrics m
JOIN dba_tablespaces ts
    ON m.tablespace_name = ts.tablespace_name
WHERE ts.contents NOT IN('UNDO','TEMPORARY')
  AND m.used_percent > 60
  AND (m.tablespace_size - m.used_space) * ts.block_size / 1024 / 1024 < 20 * 1024;
输出:
no rows selected
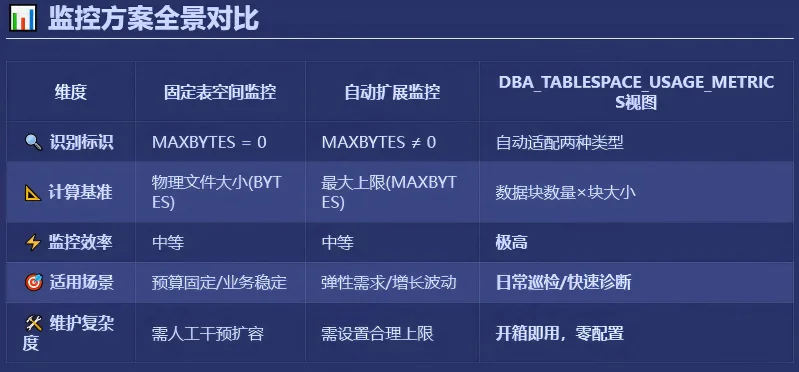
这里的 60 不是笔误,是针对「上限可能不够」场景给的更保守阈值。统一用 90 会在只剩 10% 时才报,自动扩展表空间可能来不及扩,尤其是增量 increment_by 很大、底层存储又紧张的时候。
4.2 三种方式怎么选
| 场景 | 推荐方式 | 说明 |
|---|---|---|
| 日常巡检、自动化采集 | DBA_TABLESPACE_USAGE_METRICS | 单视图、无需聚合、同时适配两类表空间 |
| 固定大小、预算严格控制 | DBA_DATA_FILES + DBA_FREE_SPACE | 按实际分配计算,阈值直观 |
| 自动扩展、要看离上限多远 | MAXBYTES 汇总 | 分母是上限,能提前发现 MAXBYTES 设得过大 |
| 定位到具体数据文件 | DBA_DATA_FILES | 看 autoextensible、maxbytes、increment_by |
阈值不要只设一条。按影响面分三层更实用:使用率到 80% 或剩余低于 30G 进预警,留给扩容审批的时间;到 90% 或剩余低于 20G 进严重,当天处理;到 95% 或剩余低于 5G 直接按故障响应。绝对值阈值和百分比阈值要同时满足才告警,否则大表空间会被百分比频繁打扰,小表空间会被绝对值漏掉。
比当前使用率更有价值的是增长速度。连续采集一周的已用空间,算出日均增量,再用「剩余可扩展空间 ÷ 日均增量」估算可支撑天数。低于 30 天就该排扩容窗口,而不是等告警。自动扩展表空间还要把 MAXBYTES 和底层剩余取小值,因为文件能长到 32G 不代表磁盘放得下 32G。
固定表空间的优点是逻辑简单,缺点是必须人工扩容,容易在无人值守时写满。自动扩展的优点是能弹性增长,缺点是 MAXBYTES 设成 32G 就等于把风险推给存储层,必须同时监控底层剩余。DBA_TABLESPACE_USAGE_METRICS 效率最高,但它是 Oracle 内部度量,老版本或某些补丁级别下结果可能有偏差,关键告警建议用两套口径交叉验证。
五、临时表空间不能漏
上面的查询都用 contents NOT IN('UNDO','TEMPORARY') 把 TEMP 排除了,因为临时表空间的使用率和永久表空间不是一回事:临时段在排序、哈希连接、全局临时表用完后会自动释放,占用高不等于快满。但 TEMP 撑爆同样会让业务报 ORA-01652,所以监控要单独做。
SELECT tablespace_name,
       ROUND(tablespace_size/1024/1024,2) AS total_mb,
       ROUND(allocated_space/1024/1024,2) AS allocated_mb,
       ROUND(free_space/1024/1024,2) AS free_mb
FROM dba_temp_free_space;
allocated_space 是当前已分配的临时段总量,free_space 是可复用的空闲部分。如果 free_space 长期接近 0,而 allocated_space 接近 tablespace_size,说明 TEMP 真的不够,需要扩临时文件或调大 PGA_AGGREGATE_TARGET 减少落盘排序。
TEMP 的另一个坑是 dba_free_space 里根本没有 TEMP 的记录,用第二节的 SQL 去监控 TEMP 会得到空结果或除零错误。这不是权限问题,是视图本身不覆盖临时段。
六、扩容时改哪个参数
确认要扩容后,有两条路。下面两条语句是通用写法,文件路径按现场替换,不要直接照抄示例路径:
-- 方式一:扩大现有数据文件
ALTER DATABASE DATAFILE '<datafile_path>' RESIZE 8G;

-- 方式二:新增数据文件并开启自动扩展
ALTER TABLESPACE SYSAUX ADD DATAFILE '<new_datafile_path>' SIZE 2G AUTOEXTEND ON NEXT 512M MAXSIZE 32G;
RESIZE 只能扩到不超过 MAXBYTES,且新大小必须大于当前高水位,否则报 ORA-03297。新增文件不受原文件 MAXBYTES 限制,但表空间总上限会变成各文件上限之和,监控口径要同步更新。
自动扩展的 NEXT 不要设得太小。NEXT 64M 在高并发写入时会导致频繁扩展,每次扩展都要短暂持有文件级锁,表现为间歇性卡顿。512M 到 1G 是常见取值,具体看底层存储的条带大小。
七、SYSAUX 膨胀:从 55G 清到 3G
7.1 SYSAUX 里到底放了什么
SYSAUX 是系统辅助表空间,建库时自动创建,作为 SYSTEM 的补充,存放各组件的非核心元数据,不放业务用户数据。主要占用来自:
- AWR 性能快照,即
WRH$系列表,最容易暴涨。 - 统计信息历史 OPTSTAT。
- SQL 管理基线、SQL 调优集、顾问任务日志。
- OEM 资料库、审计 AUDSYS、Statspack、文本索引等。
判断占用来源有个简单办法:按 owner 和段名前缀聚合。WRH$ 开头是 AWR,WRI$ 是 AWR 的基线元数据,OPTSTAT 或 SYS 下的 HIST 系列是统计信息历史,AUDSYS 是统一审计,SM$、SQLOBJ$ 之类多为 SQL 管理对象。先看哪一类占大头,再决定是调保留期、清基线,还是清审计。不要一上来就删段,很多组件表被 drop 后组件本身会失效。
本例中 SYSAUX 段合计 55404.875M,其中 WRH$% 段合计 52445.1875M,占 94% 以上。AWR 保留期是 61 天。也就是说,业务数据没怎么长,历史性能数据把系统表空间吃掉了。
7.2 确认总量与 WRH$ 占比
select sum(BYTES/1024/1024)||'M' from dba_segments where tablespace_name='SYSAUX';
SUM(BYTES/1024/1024)||'M'
--------------------------
55404.875M
select sum(BYTES/1024/1024)||'M' from user_segments where segment_name like 'WRH$%';
SUM(BYTES/1024/1024)||'M'
------------------------------
52445.1875M
第二条用的是 user_segments,必须在 SYS 用户下执行,否则看不到 WRH$ 段。换到别的用户执行会返回空或 0,容易误判。
7.3 找最大的 WRH$ 表
col SEGMENT_NAME for a30
select segment_name,sum(bytes)/1024/1024/1024 from dba_segments where owner='SYS' and segment_name like 'WRH$%' group by owner,segment_name having sum(bytes)/1024/1024/1024>1 order by 1;
输出 13 行,按段大小排序:
SEGMENT_NAME                   SUM(BYTES)/1024/1024/1024
------------------------------ -------------------------
WRH$_ACTIVE_SESSION_HISTORY                   7.27478027
WRH$_ACTIVE_SESSION_HISTORY_PK                1.12548828
WRH$_EVENT_HISTOGRAM                          6.26959229
WRH$_EVENT_HISTOGRAM_PK                       8.64556885
WRH$_LATCH                                    3.06842041
WRH$_LATCH_MISSES_SUMMARY                     2.75201416
WRH$_LATCH_MISSES_SUMMARY_PK                  3.34381104
WRH$_LATCH_PK                                 2.25396729
WRH$_PARAMETER                                1.12506104
WRH$_PARAMETER_PK                             1.25006104
WRH$_SQLSTAT                                  2.25592041
WRH$_SYSSTAT                                  1.56646729
WRH$_SYSSTAT_PK                               1.86627197

13 rows selected.
索引段单独列出,是因为本地索引按分区存储,drop 分区时会一起清理;如果某个索引是全局索引,drop 分区后它会变成 UNUSABLE,必须 rebuild。清理前先确认索引是 LOCAL 还是 GLOBAL。
7.4 看 AWR 保留期
col RETENTION for a30
col MOST_RECENT_PURGE_TIME for a30
select retention,most_recent_purge_time from wrm$_wr_control;
RETENTION                      MOST_RECENT_PURGE_TIME
------------------------------ ------------------------------
+00061 00:00:00.0              10-MAR-21 10.06.06.979 PM
61 天就是高危诱因:快照保留两个月,WRH$ 表持续写入,SYSAUX 只涨不降。
改成 30 天。单位是分钟:
30 * 24 * 60 = 43200
EXEC DBMS_WORKLOAD_REPOSITORY.MODIFY_SNAPSHOT_SETTINGS(retention => 43200);
注意三点:第一,单位是分钟,不是天;第二,retention => 0 表示永久保留,不要误设;第三,修改只影响后续的自动清理,已经占用的分区不会立刻释放,仍要走下面的步骤。默认值通常是 8 天(11520 分钟),60 天往往是人为调大或从模板继承下来的。
7.5 确认快照范围
select dbid,min(snap_id),max(snap_id) from dba_hist_snapshot group by dbid;
DBID         MIN(SNAP_ID)  MAX(SNAP_ID)
---------- ------------   ------------
4238011333        44041        47011
记住 dbid,后面的 DROP_SNAPSHOT_RANGE 要用。RAC 或多租户环境下写错 dbid 会清错实例的历史。
7.6 检查分区细节
以 WRH$_ACTIVE_SESSION_HISTORY 为例:
set linesize 300
col owner for a10
SELECT owner, segment_name, partition_name, segment_type, bytes/1024/1024/1024 Size_GB FROM dba_segments WHERE segment_name='WRH$_ACTIVE_SESSION_HISTORY';
OWNER      SEGMENT_NAME                   PARTITION_NAME                 SEGMENT_TYPE          SIZE_GB
---------- ------------------------------ ------------------------------ ------------------ ----------
SYS        WRH$_ACTIVE_SESSION_HISTORY    WRH$_ACTIVE_4238011333_0       TABLE PARTITION    7.27471924
SYS        WRH$_ACTIVE_SESSION_HISTORY    WRH$_ACTIVE_SES_MXDB_MXSN      TABLE PARTITION    .000061035
只有一个大数据分区 WRH$_ACTIVE_4238011333_0,7.27G;另一个 _MXDB_MXSN 是极小的心跳分区。AWR 表默认按 dbid 和快照范围分区,长期不分裂就会形成这种「一个分区装几年」的结构,drop 时无法按时间切。
7.7 分裂分区
alter session set "_swrf_test_action" = 72;
Session altered.
这个内部参数的作用是让 MMON 在当前快照边界分裂所有 AWR 分区,执行后立即生效,不需要重启实例。它不是官方文档承诺的接口,不同版本行为可能不同;生产执行前先在测试库验证,并确认没有正在运行的 AWR 报表、基线或导出任务。
执行后再查:
OWNER      SEGMENT_NAME                   PARTITION_NAME                 SEGMENT_TYPE          SIZE_GB
---------- ------------------------------ ------------------------------ ------------------ ----------
SYS        WRH$_ACTIVE_SESSION_HISTORY    WRH$_ACTIVE_4238011333_0       TABLE PARTITION    7.27471924
SYS        WRH$_ACTIVE_SESSION_HISTORY    WRH$_ACTIVE_4238011333_47013   TABLE PARTITION    .000061035
SYS        WRH$_ACTIVE_SESSION_HISTORY    WRH$_ACTIVE_SES_MXDB_MXSN      TABLE PARTITION    .000061035
新分区 WRH$_ACTIVE_4238011333_47013 只有几十 KB,47013 就是这次分裂出来的边界。原来的大分区仍然保留,等待被整体 drop。
7.8 列出每个分区的 SNAP_ID 范围
分区名不能直接当表名查,需要拼动态 SQL:
set serveroutput on
declare
CURSOR cur_part IS
SELECT partition_name from dba_tab_partitions
WHERE table_name = 'WRH$_ACTIVE_SESSION_HISTORY';
query1 varchar2(200);
query2 varchar2(200);
TYPE partrec IS RECORD (snapid number, dbid number);
TYPE partlist IS TABLE OF partrec;
Outlist partlist;
begin
dbms_output.put_line('PARTITION NAME SNAP_ID DBID');
dbms_output.put_line('--------------------------- ------- ----------');
for part in cur_part loop
query1 := 'select min(snap_id), dbid from sys.WRH$_ACTIVE_SESSION_HISTORY partition ('||part.partition_name||')
group by dbid';
execute immediate query1 bulk collect into OutList;
if OutList.count > 0 then
for i in OutList.first..OutList.last loop
dbms_output.put_line(part.partition_name||' Min '||OutList(i).snapid||' '||OutList(i).dbid);
end loop;
end if;
query2 := 'select max(snap_id), dbid from sys.WRH$_ACTIVE_SESSION_HISTORY partition ('||part.partition_name||')
group by dbid';
execute immediate query2 bulk collect into OutList;
if OutList.count > 0 then
for i in OutList.first..OutList.last loop
dbms_output.put_line(part.partition_name||' Max '||OutList(i).snapid||' '||OutList(i).dbid);
dbms_output.put_line('---');
end loop;
end if;
end loop;
end;
/
PARTITION NAME SNAP_ID DBID
--------------------------- ------- ----------
WRH$_ACTIVE_4238011333_0 Min 12101 4238011333
WRH$_ACTIVE_4238011333_0 Max 47010 4238011333
---
PL/SQL procedure successfully completed.
换表时两处表名都要改:游标里的 dba_tab_partitions 条件和动态 SQL 里的 sys.WRH$_...。OutList 定义为 record 表,bulk collect 一次取 min 或 max 的结果,写法略绕,但可以直接复用。
对 WRH$_EVENT_HISTOGRAM 重复同样的步骤:
SELECT owner, segment_name, partition_name, segment_type, bytes/1024/1024/1024 Size_GB FROM dba_segments WHERE segment_name='WRH$_EVENT_HISTOGRAM';
OWNER      SEGMENT_NAME                   PARTITION_NAME                 SEGMENT_TYPE          SIZE_GB
---------- ------------------------------ ------------------------------ ------------------ ----------
SYS        WRH$_EVENT_HISTOGRAM           WRH$_EVENT_HISTO_MXDB_MXSN     TABLE PARTITION    .000061035
SYS        WRH$_EVENT_HISTOGRAM           WRH$_EVENT__4238011333_0       TABLE PARTITION    6.26953125
SYS        WRH$_EVENT_HISTOGRAM           WRH$_EVENT__4238011333_47013   TABLE PARTITION    .000061035
再执行一次 alter session set "_swrf_test_action" = 72;,然后查分区内的 snap_id:
WRH$_EVENT__4238011333_0 Min 1 4238011333
WRH$_EVENT__4238011333_0 Max 47010 4238011333
这里 min 是 1,而 dba_hist_snapshot 的 min 是 44041。不同 WRH$ 表的建表时间和历史不同,不能假设所有表都从 44041 开始,必须逐表确认分区边界。
7.9 清理前把 max snap_id 推到边界前
这是整个流程最关键的一步。当前最大快照是 47011,新分区边界是 47013。要让 DROP_SNAPSHOT_RANGE 走分区 drop,删除范围必须完整覆盖旧分区,也就是要删到 47012,而不是 47011。
操作前先看清这段说明:
现在最大的snap_id是47011,
下个WRH$_EVENT__4238011333_47013分区的snap_id:47013,
一定要让MAX(SNAP_ID)到47013上个snap_id:47012,
手工执行(可能多次执行到47013上个snap_id:47012,
否则下面DROP_SNAPSHOT_RANGE会以Delete的方式清理表,
会花很长时间,并且产生大量的归档)
执行一次手工快照:
exec dbms_workload_repository.create_snapshot;
select dbid,min(snap_id),max(snap_id) from dba_hist_snapshot group by dbid;
DBID        MIN(SNAP_ID) MAX(SNAP_ID)
---------- ------------  ------------
4238011333        44041        47012
如果一次没到 47012,再执行一次 create_snapshot,直到 max 等于 47012。多执行几次只会多几个快照,不会影响历史。
原理是:DROP_SNAPSHOT_RANGE 只有在待删范围完整覆盖某个分区时才做 partition drop;边界落在分区内部时,只能退化成逐行 delete。delete 要写 undo 和 redo,几千万行的 AWR 数据就是长时间执行加大量归档,严重时把 SYSAUX 和 FRA 一起拖满。
7.10 执行清理
exec DBMS_WORKLOAD_REPOSITORY.DROP_SNAPSHOT_RANGE(1, 47012, 4238011333);
三个参数分别是起始 snap_id、结束 snap_id、dbid。执行前确认:
- 没有依赖这些快照的 AWR 基线、对比报表或性能归档。
- 当前不在业务高峰,drop 分区虽然快,但仍会持有短暂的库级锁。
- 这些历史确实可以丢弃。该操作不可逆,没有回收站。
执行后验证分区:
SELECT owner, segment_name, partition_name, segment_type, bytes/1024/1024/1024 Size_GB FROM dba_segments WHERE segment_name='WRH$_EVENT_HISTOGRAM';
OWNER      SEGMENT_NAME                   PARTITION_NAME                 SEGMENT_TYPE          SIZE_GB
---------- ------------------------------ ------------------------------ ------------------ ----------
SYS        WRH$_EVENT_HISTOGRAM           WRH$_EVENT_HISTO_MXDB_MXSN     TABLE PARTITION    .000061035
SYS        WRH$_EVENT_HISTOGRAM           WRH$_EVENT__4238011333_47013   TABLE PARTITION    .000061035
大分区已经消失,只剩心跳分区和新边界分区。
再查 WRH$ 段:
select segment_name,sum(bytes)/1024/1024/1024 from dba_segments where owner='SYS' and segment_name like 'WRH$%' group by owner,segment_name having sum(bytes)/1024/1024/1024>1 order by 1;
no rows selected
最后确认 SYSAUX 总量:
select sum(BYTES/1024/1024)||'M' from dba_segments where tablespace_name='SYSAUX';
SUM(BYTES/1024/1024)||'M'
--------------------------------
2959.6875M
从 55404.875M 降到 2959.6875M。
注意:段大小下降不等于数据文件立刻变小。SYSAUX 如果是自动扩展,释放的空间只是变成表空间内空闲,可以继续使用;要把空间还给操作系统,需要先确认高水位已经下降,再 resize 数据文件。直接 resize 到小于高水位会报 ORA-03297。
八、要点
- 监控前先分类型:
MAXBYTES=0看bytes,MAXBYTES>0看MAXBYTES,混用一定误报。 - 日常巡检优先用
DBA_TABLESPACE_USAGE_METRICS;要定位文件、判断碎片时再回到DBA_DATA_FILES+DBA_FREE_SPACE。 - 自动扩展表空间必须同时监控 MAXBYTES 和底层存储剩余,否则使用率永远「很健康」。
- SYSAUX 膨胀先算
WRH$占比,再看 AWR 保留期;保留期改小不会立刻释放空间。 - 清理前必须分裂分区,并把 max snap_id 推到新分区边界的前一个值,否则
DROP_SNAPSHOT_RANGE会退化成 delete。 DROP_SNAPSHOT_RANGE不可逆,执行前确认 dbid、范围和业务影响。- 清理后先确认段大小和高水位,再考虑
resize数据文件;段释放不等于文件变小。 - 把 AWR 保留期、分区拆分和清理步骤写进巡检脚本,否则几个月后同样的膨胀会再来一次。
待核对
- 2.2 的 SQL 同时使用 ANSI
RIGHT JOIN和 Oracle(+),会触发 ORA-25156;文中已给出删掉(+)的写法,原文未说明该语句是否实际执行过。 DBA_TABLESPACE_USAGE_METRICS的示例输出包含TEMP行,与WHERE ts.contents NOT IN('UNDO','TEMPORARY')矛盾,疑为粘贴时混入;现场以实际查询结果为准。_swrf_test_action是内部参数,没有官方文档承诺,不同版本的行为和副作用需要验证。- 文中的容量数字(55404.875M、52445.1875M、2959.6875M)和 dbid(4238011333)都来自原文环境,不能直接套用到其他库。
- 原文 2.10 的小标题写作「snap_id不是1」,但输出中
WRH$_EVENT_HISTOGRAM的 min 是 1,标题与内容不一致,本文按输出描述。
原文首发于微信公众号「止水研习社」。

文章评论