“调参数不用重启”这句话只对一部分参数成立。open_cursors、cursor_sharing 这类可以 scope=memory 立刻生效;processes、filesystemio_options 写的是 spfile,必须重启实例。调优前先分清这两类,否则要么白等窗口,要么在高峰改错。
下面按原编号讲 10 项(第 8 项含三个统计参数,第 10 项是 sqlnet.ora 配置),再讲 CDB/PDB 配置,最后说 THP 和 NUMA。
一、先学会判断参数能不能动态改
不用背,直接查:
select name, value, issys_modifiable, isdefault
from v$parameter
where name in ('open_cursors','processes','sessions','session_cached_cursors',
               'cursor_sharing','optimizer_mode','optimizer_index_cost_adj',
               'trace_enabled','statistics_level','timed_statistics',
               'timed_os_statistics','deferred_segment_creation')
order by name;
ISSYS_MODIFIABLE 三个值:IMMEDIATE 可 scope=memory 或 both 立即生效;DEFERRED 只对新会话生效;FALSE 是静态参数,必须写 spfile 再重启。
改前记原值,改完用 show parameter 确认。生产不要 scope=both 一把梭,先 scope=memory 验证,无副作用再写 spfile。
二、10 个参数逐项说明
2.1 open_cursors
单会话可同时打开的游标数,超了报 ORA-01000。
show parameter open_cursors;
select count(*) from v$open_cursor;
alter system set open_cursors=5000 scope=memory;
v$open_cursor 是当前打开的游标,不是峰值。判断是否调大,看高峰期单会话最大值,而非全库总数:
select max(cnt) from (
  select s.sid, count(*) cnt
  from v$open_cursor o, v$session s
  where o.sid = s.sid
  group by s.sid
);
调大只是缓解症状。游标数持续上涨通常是应用没关 ResultSet/Statement,或 session_cached_cursors 太小导致反复硬解析。
2.2 processes 与 sessions
processes 限制并发操作系统进程数,sessions 限制并发会话数。sessions 默认由 processes 推导(约 1.1 × processes + 5),一般只调 processes。
show parameter processes;
alter system set processes=1000 scope = spfile;
这是静态参数,改完必须重启。重启前确认 OS 侧 ulimit -u、kernel.pid_max 和内存能否支撑这么多进程;只改数据库参数,重启后可能起不来。
processes 与 sessions 不是一回事。一个会话可能对应多个进程(比如并行查询的 slave),所以 sessions 通常要比 processes 大一点。反过来,processes 调得比 sessions 小太多时,会话还没到上限,进程先不够了,报的是 ORA-00020 而不是 ORA-00018。两个上限都要看:
select resource_name, current_utilization, limit_value
from v$resource_limit
where resource_name in ('processes','sessions');
current_utilization 接近 limit_value 时才需要调,别凭感觉加个零。
调小更要小心:当前进程数已超过新值时实例可能无法启动。先用 select count(*) from v$process 看实际用量,留足余量。
2.3 session_cached_cursors
缓存已关闭的游标,减少重复解析,默认 50。
show parameter session_cached_cursors;
alter system set session_cached_cursors=200 scope=spfile;
alter system set session_cached_cursors=200;
第二条不带 scope,默认 both,立即生效并写 spfile。它按会话分配内存,调太大会增加 PGA 占用,并非越大越好;OLTP 系统 200-500 常见,跑批收益有限。
2.4 cursor_sharing
当前值 EXACT,只有 SQL 文本完全相同才共享游标。
可选值:FORCE 强制把字面值替换成绑定变量;SIMILAR 仅在安全时替换,Oracle 已不推荐。
show parameter cursor_sharing;
字面值多的 OLTP 系统改成 FORCE 能降低硬解析,但执行计划可能因“共享了不该共享的游标”变差,尤其是分布倾斜的列。改前抓 v$sql 看硬解析占比,改后盯住主要 SQL 的计划。SIMILAR 不要用。
这个参数可以动态改,但影响的是后续解析,已缓存的游标不会立刻失效。
FORCE 的副作用值得说清楚。绑定变量窥探只在第一次硬解析时发生,如果首次执行用的字面值恰好落在数据分布的一端,后续所有复用这个游标的语句都会沿用那个计划。历史上大量 FORCE 导致的性能事故都是这么来的。11g 之后有自适应游标共享(ACS)可以缓解,但前提是 cursor_sharing 保持 EXACT。这也是为什么现在不建议随便改成 FORCE。
2.5 optimizer_mode
当前 ALL_ROWS,按吞吐量优化,适合批处理和数据仓库。OLTP 交互查询可以用 FIRST_ROWS_N 优化响应时间。
show parameter optimizer_mode;
不要为“让某条 SQL 快点”改全局 optimizer_mode,那会改变所有 SQL 的优化目标。单条语句用 /*+ first_rows(10) */ 提示,或用 ALTER SESSION 调整。
2.6 optimizer_index_cost_adj
索引访问路径的成本调整因子,默认 100,范围 1-10000;越小越倾向走索引。
show parameter optimizer_index_cost_adj;
alter session set optimizer_index_cost_adj=50;
这是典型的“止血参数”。全局调小会让本该全表扫描的 SQL 也走索引,产生大量随机 I/O。只在确认某类 SQL 因成本偏差选错路径时才做会话级调整。
2.7 trace_enabled
控制 SQL 跟踪功能,默认 TRUE。
show parameter trace_enabled;
alter system set trace_enabled=false;
可以动态开关。关掉会失去部分诊断能力,sql_trace、10046 等事件的行为也受影响;只在确认没有排障依赖时关闭。
2.8 统计信息相关:statistics_level、timed_statistics、timed_os_statistics
STATISTICS_LEVEL 当前 TYPICAL,收集主要统计信息,是 AWR、ASH 正常工作的前提。BASIC 会关掉大部分性能视图的数据,ALL 增加额外统计、开销更大。
TIMED_STATISTICS 当前 TRUE,启用时间统计。它受 STATISTICS_LEVEL 影响,不建议单独设置。
TIMED_OS_STATISTICS 当前 0,不收集操作系统统计。设成非零值时,Oracle 按该间隔(秒)采集 OS 层统计,用于判断数据库到底在等 CPU 还是等 I/O,代价是额外的采集开销。
show parameter statistics_level;
show parameter timed_statistics;
show parameter timed_os_statistics;
这三项不改也能正常运行。statistics_level 可动态改;timed_os_statistics 在部分版本是静态参数,改前用 v$parameter.issys_modifiable 确认。
把 statistics_level 调成 BASIC 来“省性能”是常见误操作:AWR 快照、ASH 采样都受影响,出问题时证据变少。
2.9 deferred_segment_creation
延迟段创建。TRUE 时建表不立即分配段,第一次插入才分配。
show parameter deferred_segment_creation;
alter system set deferred_segment_creation=false;
可动态关闭。关闭后新建表立即分配段,dba_segments 与 dba_tables 结果一致,导出、监控不会漏掉空表;代价是大量空表占空间。
注意:改这个参数只影响之后新建的表,已按延迟方式建好的表不会自动补分配段;需要补时用 alter table ... allocate extent 逐表处理。
2.10 sqlnet.ora 的 expire_time
Dead Connection Detection(DCD),每隔 N 分钟探测无效连接,释放僵死会话资源。
sqlnet.expire_time=10
这是 sqlnet.ora 配置,不是数据库参数,改完不用重启实例;已建立会话是否生效取决于进程何时读取配置,稳妥做法是在维护窗口改并用新连接验证。
DCD 只能发现“连接已断但会话还在”,替代不了连接池校验,也解决不了会话泄漏。
三、CDB 与 PDB 层面的配置
多租户下参数分 CDB 级和 PDB 级。ALTER SYSTEM 在根容器执行影响整个 CDB;切到 PDB 后只影响该 PDB(部分参数仍是 CDB 级,会报错)。
3.1 监听地址
alter system set local_listener='(DESCRIPTION=(ADDRESS=(PROTOCOL=tcp)(HOST=192.168.109.201)(PORT=1526)))' scope=both;
确保实例注册到正确监听,改完用 lsnrctl status 确认;RAC 还要看 remote_listener 是否指向 SCAN。
3.2 游标与进程
alter system set open_cursors=3000 scope=both;
alter system set processes=3000 scope=spfile;
open_cursors 动态生效;processes 需要重启。processes 是 CDB 级参数,在 PDB 里执行会被拒绝,需在根容器改。
3.3 关闭自动索引
alter system set "_optimizer_use_auto_indexes"=OFF scope=spfile;
这是下划线参数,关闭优化器对自动索引的使用。只在人工精细控制索引、且确认自动索引干扰计划时使用;它不受支持,升级前要重新评估。
3.4 文件系统 I/O
alter system set filesystemio_options=setall scope=spfile;
启用异步 I/O 和直接 I/O,SETALL 同时开启 ASYNCH 和 DIRECTIO。这是静态参数,必须重启。
改之前先确认数据库文件到底放在哪。这个参数只对文件系统上的数据文件、日志文件有意义,ASM 管理的磁盘不受它影响:
select name from v$datafile where name not like '+%';
select member from v$logfile where member not like '+%';
两条都返回空,说明全部在 ASM 上,这个参数改了也没意义。改前还要确认文件系统支持 direct I/O。
3.5 保存 PDB 状态
alter pluggable database all save state;
重启 CDB 后 PDB 自动恢复到保存时的打开状态。保存的是“状态”而非“每次启动强制打开”;PDB 后来被手动关闭,保存状态也随之更新。
3.6 密码策略
@?/rdbms/admin/utlpwdmg.sql;
alter profile default limit password_verify_function verify_function;
alter profile default limit password_life_time unlimited;
第一句跑 Oracle 自带的密码复杂度脚本,后两句启用验证函数并把密码设为永不过期。
password_life_time 设成 unlimited 可避免密码到期中断应用,但也削弱了定期换密要求,合规环境应配合外部改密流程。
3.7 关闭自动维护任务
exec  DBMS_AUTO_TASK_ADMIN.DISABLE( client_name =>  'auto space advisor', operation => NULL,window_name => NULL);
exec  DBMS_AUTO_TASK_ADMIN.DISABLE( client_name => 'sql tuning advisor', operation => NULL,window_name => NULL);
关闭自动空间顾问和 SQL 调优顾问,减少后台消耗。代价是失去自动建议,要自己定期看空间和 Top SQL;资源不紧张没必要关。
关之前先看这些任务在什么窗口跑、跑多久。有些环境关掉之后,凌晨的统计信息收集也跟着没了,因为自动统计信息收集作业同样挂在维护窗口上:
select client_name, status from dba_autotask_client;
select window_name, repeat_interval, duration from dba_scheduler_windows;
只想避开业务高峰,更合适的做法是调整维护窗口,而不是把任务全关掉。
3.8 关闭 OCM 作业
exec dbms_scheduler.disable('ORACLE_OCM.MGMT_CONFIG_JOB');
exec dbms_scheduler.disable('ORACLE_OCM.MGMT_STATS_CONFIG_JOB');
关闭 Oracle Configuration Manager 的配置与统计作业。环境没配 OCM 时可能报作业不存在,先查 dba_scheduler_jobs。
3.9 简化统计信息收集
exec DBMS_STATS.SET_PARAM( 'method_opt','FOR ALL COLUMNS SIZE 1' );
所有列只收集基本统计信息,不建直方图。收集更快、计划更稳,但分布倾斜的列会因缺直方图选错计划。该设置全局生效,改前确认没有依赖直方图的关键 SQL。
3.10 切到 PDB 执行
alter session set container=TESTPDB;
之后配置只作用于该 PDB,切回根容器用 alter session set container=CDB$ROOT;。执行前用 show con_name 确认,避免改错容器。
3.11 网络层兼容旧客户端
cat << EOF >>$ORACLE_HOME/network/admin/sqlnet.ora
SQLNET.ALLOWED_LOGON_VERSION_SERVER=8
SQLNET.ALLOWED_LOGON_VERSION_CLIENT=8
EOF
允许低版本客户端连接会放宽认证协议、带来安全风险;只在确有老客户端且网络可控时使用。改完需重启监听,已建立的连接不受影响。
四、THP 与 NUMA:操作系统层的问题
这两项不是数据库参数,改的是内核行为,但影响往往比调参数更大。
4.1 为什么要关透明大页
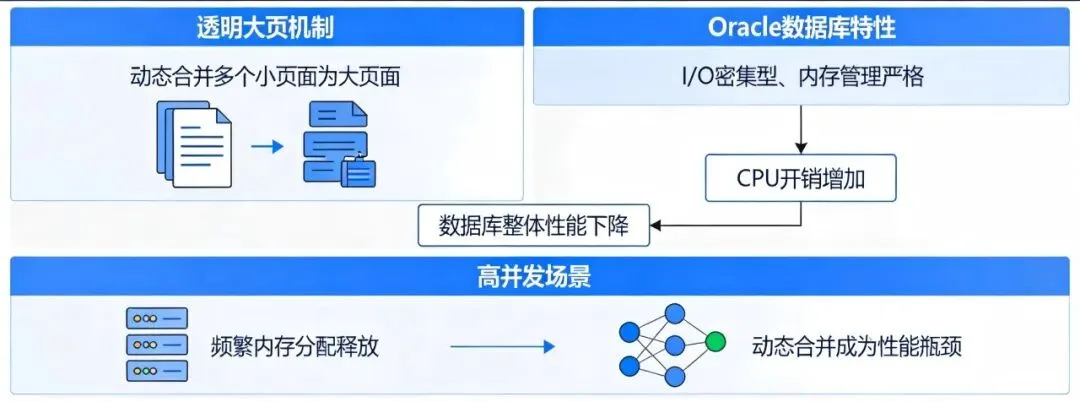
THP 会在内存分配时动态把小页合并成大页,合并本身消耗 CPU。Oracle 的 SGA 是一大片共享内存,频繁合并/拆分会让 khugepaged 持续占用 CPU,高并发时表现为莫名的系统态开销。
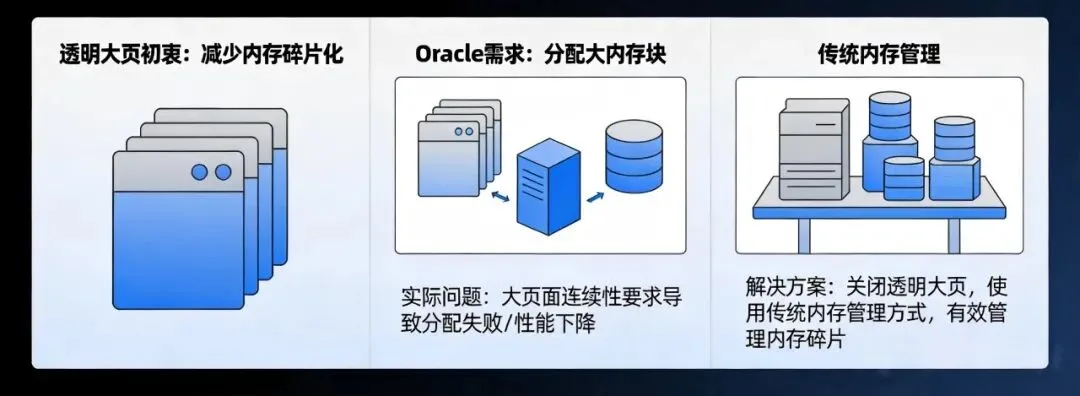
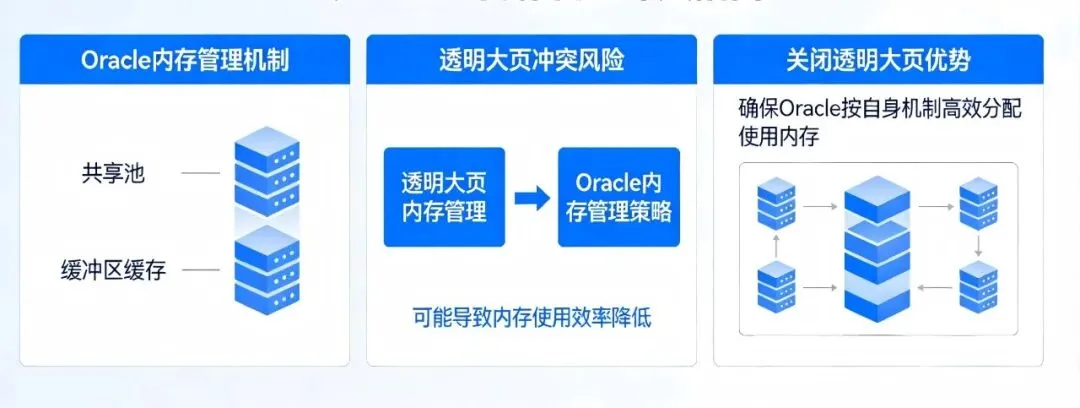
更麻烦的是碎片和分配失败:THP 要求连续大页,碎片化后可能分配不到,表现为 allocation stalled 或 OOM。Oracle 自己用 HugePages 管理 SGA,THP 的透明合并和它的策略会打架。
先确认状态:
cat /sys/kernel/mm/transparent_hugepage/enabled
cat /sys/kernel/mm/transparent_hugepage/defrag
grep -i huge /proc/meminfo
输出里 [always] 是启用,[never] 是关闭。关闭方式随 OS 版本不同:RHEL 7/8 可用 grubby 加内核参数,或用 tuned 的 virtual-guest/throughput-performance profile;具体命令按现场文档执行。
关闭 THP 不等于关闭 HugePages。Oracle 需要的是显式配置的 HugePages(vm.nr_hugepages),别一起关掉。
HugePages 的配置要和 SGA 对上。先看 SGA 目标大小,再按 2MB 一页换算,并留出余量:
grep -i huge /proc/meminfo
show parameter sga_target
show parameter sga_max_size
HugePages_Total × 2048 KB 要略大于 SGA 加上各实例的固定开销。配少了,SGA 用不满大页,实例可能起不来或在告警日志里留下提示;配多了,这部分内存被内核锁住,其他进程用不了。
改 vm.nr_hugepages 后要确认真的分配成功,HugePages_Rsvd、HugePages_Free 都要看,不能只看 Total;数据库启动后再查一次 /proc/meminfo,确认 HugePages_Free 的变化量接近 SGA 大小。
4.2 为什么要禁用 NUMA
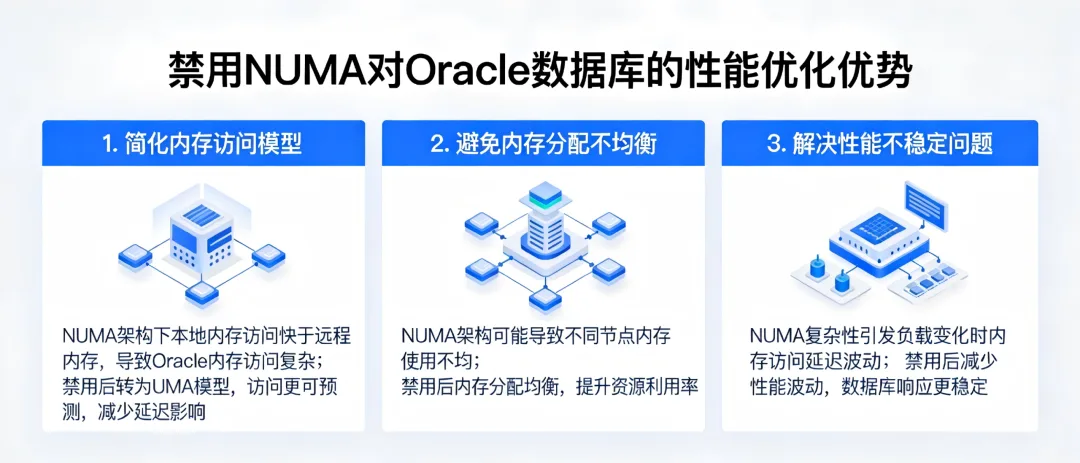
NUMA 下 CPU 访问本地内存快、远端慢。Oracle 进程跨节点分配内存时,会出现“一个节点内存吃满、另一个闲着”的不均衡,延迟也不可预测。
禁用 NUMA 把内存访问模型简化成 UMA,行为更可预测。代价是放弃 NUMA 的本地性优势,在大内存多路机器上不一定总是更快。
先看拓扑:
numactl --hardware
numastat
是否禁用要看硬件和负载。单实例、SGA 远小于单节点内存时禁用通常更稳;RAC 或多实例、已做好绑核和内存绑定时,禁用反而可能降性能。这件事必须按现场评估,没有通用答案。
比“一刀切禁用”更精细的做法是绑核加绑内存,让每个实例只在自己那个 NUMA 节点上跑:
numactl --hardware
numactl --cpunodebind=0 --membind=0 <启动命令>
这样既保留了本地内存访问的低延迟,又避免了跨节点漂移。RAC 多实例场景优先考虑这种方案,而不是直接关 NUMA。
另外,虚拟化平台上 NUMA 拓扑常常是“假”的,numactl --hardware 看到的是宿主机透传的结果。这种情况下按虚拟机规格评估,别照搬物理机的经验。
五、改动顺序建议
先查 issys_modifiable,把参数分成“立即生效”和“需重启”两批。前者先在会话级或 scope=memory 验证,观察至少一个业务高峰;后者攒到一个窗口,改 spfile 后重启,重启前确认 OS 限制和内存。
改完要能回退。每个参数改之前记下原值和修改时间,写进变更单;scope=both 的参数改错了,用原值再执行一次就能回去;scope=spfile 的参数必须重启才生效,也意味着回退同样要重启。没有回退方案的参数调整,在高峰期就是纯赌博。
验证不要只看“参数值变了”。open_cursors 改完要看 v$open_cursor 的峰值有没有下降,processes 改完要看 v$resource_limit 的使用率,filesystemio_options 改完要看 OS 层的 I/O 模式(iostat -x 的 await、%util)和数据库的 Average Synchronous Single-Block Read Latency。参数生效和问题解决是两件事。
THP/NUMA 这类内核改动放在建库前或独立维护窗口,改完重启 OS 验证;不要和数据库参数混在一起,否则分不清原因。内核参数改错的影响面比数据库参数大,回退也更慢,必须单独安排窗口。
勘误与待核对
timed_os_statistics的可修改性随版本不同,文中未给修改语句;执行前用v$parameter.issys_modifiable确认。_optimizer_use_auto_indexes是下划线参数,需按现场版本验证是否存在、行为是否符合预期。- THP/NUMA 的关闭命令随 OS 发行版和版本差异较大,文中只给检查方法,落地命令需按现场文档确认。
- CDB/PDB 示例中的 IP 192.168.109.201、端口 1526、PDB 名 TESTPDB 均为实验环境值。
utlpwdmg.sql的行为和验证函数名随版本不同(11g 为verify_function,12c 之后为ORA12C_VERIFY_FUNCTION等),执行前先读脚本头部说明。
原文首发于微信公众号「止水研习社」。

文章评论