误删几行、误改一批数据,业务还在跑,不可能为了几张表把整库回退到几个小时前。LogMiner 解决的正是这个场景:解析在线重做日志和归档日志,还原出每一行变更对应的 SQL_REDO 与 SQL_UNDO,用反向 SQL 把数据补回去。
它的前提比命令更重要:库必须处于归档模式,最好开启最小补充日志;误操作之后相关段的日志不能再被覆盖。本文按"能不能用 → 准备什么 → 怎么挖 → 怎么回滚"的顺序展开。示例环境为 CDB 架构(12c 及以上),归档路径取自原文的 SINCDB。
适用与不适用
| 场景 | 是否适用 | 说明 |
|---|---|---|
| 误 DELETE、误 UPDATE 部分行 | 适用 | 用 SQL_UNDO 反向回滚,不必停业务 |
| 应用 BUG 批量改数据 | 适用 | 按时间、表名、SCN 定位异常事务 |
| 事务审计与溯源 | 适用 | 定位谁、在什么时间、从哪个会话改的数据 |
| CDC 增量捕获 | 适用 | OGG、Debezium 的底层就基于 LogMiner |
| TRUNCATE TABLE | 不适用 | 只有 DDL,没有行镜像 |
| DROP TABLE | 不适用 | 同上,只能走 RMAN 备份恢复 |
行级误操作恢复
最常见的用法。业务不能停机,也不想做全库 RMAN 时间点恢复,只想把被删或被改的那部分行找回来。LogMiner 输出的是逐行的反向 SQL,恢复粒度可以精确到一行。
注意:TRUNCATE、DROP 表不能靠 LogMiner 恢复行数据,只能看到 DDL 语句,拿不到行镜像,这种场景只能 RMAN 备份恢复。
事务审计与溯源
业务数据莫名被篡改、找不到应用来源时,挖掘日志可以定位到具体用户、会话、时间和操作类型,满足合规审计要求。
故障逻辑排查
应用 BUG 批量修改数据后,分析归档日志、统计事务与修改行数,可以定位异常事务的 SCN 与时间范围,为回滚和修复划定边界。
CDC 增量捕获
需要把表的 DML 变化同步到下游时,LogMiner 可以作为变更源。OGG、Debezium 这类工具底层用的就是这套机制。
跨库离线分析
归档日志可以拷贝到另一台同平台数据库上挖掘,不在生产库执行分析,减少生产库压力。跨平台(不同字节序或不同操作系统)不在这个范围内。
前置条件:归档模式与补充日志
开启归档模式
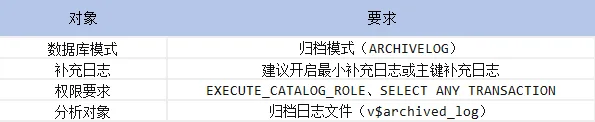
LogMiner 只能分析已经写入在线日志或归档日志的变更。数据库必须是 ARCHIVELOG 模式,否则日志被复用后,误操作那一段就再也找不回来了。
开启归档模式参考:👉 Oracle 开启归档模式
开启补充日志
补充日志决定 SQL_UNDO 能不能唯一定位到行。没有主键补充日志时,UPDATE 生成的 UNDO 可能只能靠全列比对,遇到重复行就不安全。
-- 开启最小补充日志(LogMiner 准确识别行所需)
ALTER DATABASE ADD SUPPLEMENTAL LOG DATA;

-- 开启主键补充日志(更精准的 SQL_UNDO 生成)
ALTER DATABASE ADD SUPPLEMENTAL LOG DATA (PRIMARY KEY) COLUMNS;

-- 验证补充日志状态
SELECT supplemental_log_data_min,supplemental_log_data_pk FROM v$database;

-- 期望值:YES / YES
这两条是数据库级设置,执行一次即可。补充日志会增加 redo 体积,属于用空间换可恢复性的取舍。
工作原理
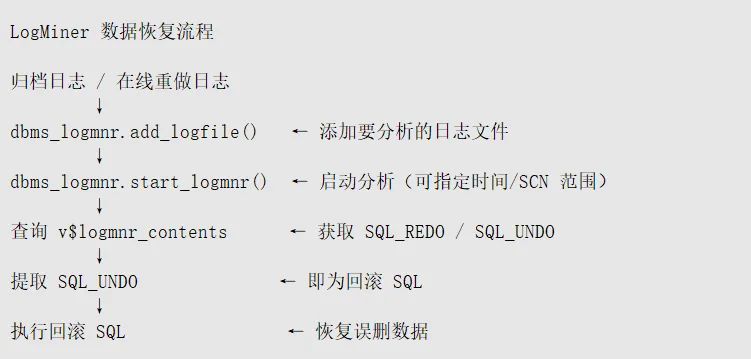
LogMiner 读取 redo 记录,结合数据字典把内部格式翻译成可读 SQL:
- SQL_REDO:重做 SQL,与原操作一致,例如
DELETE FROM t WHERE ... - SQL_UNDO:回滚 SQL,反向操作,例如
INSERT INTO t VALUES (...)
数据字典的来源有两种:DICT_FROM_ONLINE_CATALOG 直接使用当前在线字典,适合分析近期日志;预先用 DBMS_LOGMNR_D.BUILD 生成字典文件,适合分析表结构已经变化的旧日志。本文只用第一种。
实验:复现一次误删
创建测试表并制造误删
-- 建表
CREATE TABLE hruser.test_data(
    id      NUMBER PRIMARY KEY,
    name    VARCHAR2(50),
    remark  VARCHAR2(100),
    create_dt DATE
);

-- 插入1000条
INSERT INTO hruser.test_data(id,name,remark,create_dt)
SELECT
    ROWNUM,
    'USER_'||ROWNUM,
    '测试数据'||ROWNUM,
    SYSDATE - MOD(ROWNUM,30)
FROM dual
CONNECT BY ROWNUM <= 1000;
COMMIT;

-- 先查询确认结果
SELECT * FROM hruser.test_data WHERE id IN (998,999,1000);

-- 确认无误再执行delete + commit
DELETE FROM hruser.test_data WHERE id IN (998,999,1000);
COMMIT;
关键在最后两行:先查、再删、再提交。真实故障里往往没有这个确认步骤,所以恢复时更依赖日志里的时间与 SCN,而不是业务记忆。
动手挖日志前,先试闪回查询
归档文件选得准不准,取决于误操作时间定得准不准。现场可按三条线索交叉确认:
- 业务侧:订单、流水、对账文件里最早出现异常的时间点。
- 数据库侧:alert log 里该时段的 ORA 报错、归档切换记录。
- 会话侧:如果还能查到
v$sql、dba_hist_sqlstat,用 SQL_ID 反查首次执行时间。
确认时间后,以本文的测试表为例,先用 Flashback Query 探一下边界:
-- 以误操作前 1 分钟为界,试探数据是否还在 UNDO 中
SELECT * FROM hruser.test_data
AS OF TIMESTAMP TO_TIMESTAMP('2026-08-13 16:44:00','YYYY-MM-DD HH24:MI:SS')
WHERE id IN (998,999,1000);
能查到,说明 UNDO 还没被覆盖,可以直接用闪回查询取回数据,不必走 LogMiner;查不到(ORA-01555),说明 UNDO 保留期已过,才需要挖日志。这一步能把恢复成本降一个数量级,值得先做。
定位归档日志文件
先按误操作时间找到覆盖该时间段的归档文件。FIRST_TIME 与 NEXT_TIME 是日志的起止时间,用它们判断哪几个序列覆盖了误操作时刻。
-- 根据误操作时间,筛选相关归档文件
set linesize 300
col name for a120
SELECT name,first_time,next_time,sequence# FROM v$archived_log WHERE name IS NOT NULL ORDER BY first_time DESC;
NAME                                                                                         FIRST_TIME          NEXT_TIME          SEQUENCE#
------------------------------------------------------------------------------------------- ------------------- ------------------- ----------
/oracle/app/db/fast_recovery_area/SINCDB/archivelog/2026_08_13/o1_mf_1_92_o7vfcwp0_.arc     2026/08/07 22:00:19 2026/08/13 20:15:56        92
/oracle/app/db/fast_recovery_area/SINCDB/archivelog/2026_08_13/o1_mf_1_93_o7vfcwp0_.arc     2026/08/07 23:00:19 2026/08/13 21:15:56        93
-- 查看归档区时间
select sequence#,first_time,next_time,name from v$archived_log where sequence#=92;
误删发生在 2026-08-13 16:45 前后,序列 92 的 NEXT_TIME 已覆盖到 20:15,单文件就够。实际恢复时宁可多装一个序列,也不要在边界上漏掉。
添加归档日志文件到分析列表
BEGIN
  -- 第一个文件使用 NEW 选项(新建分析列表)
  sys.dbms_logmnr.add_logfile(
    logfilename => '/oracle/app/db/fast_recovery_area/SINCDB/archivelog/2026_08_13/o1_mf_1_92_o7vfcwp0_.arc',
    options    => sys.dbms_logmnr.NEW
  );

  -- 后续文件使用 ADDFILE 选项(追加到分析列表)
  sys.dbms_logmnr.add_logfile(
    logfilename => '/oracle/app/db/fast_recovery_area/SINCDB/archivelog/2026_08_13/o1_mf_1_93_o7vfcwp0_.arc',
    options    => sys.dbms_logmnr.ADDFILE
  );
END;
/
参数说明:
logfilename        ----> 归档日志完整路径(文件系统或 ASM 均可)
options = NEW      ----> 新建分析列表(只能调用一次)
options = ADDFILE  ----> 追加日志文件到列表(可多次调用)
DBMS_LOGMNR 包位于 SYS schema 下,建议显式加 sys. 前缀避免权限问题。12c 以上需要在 CDB 下执行,PDB 下执行无效。
启动 LogMiner 分析
BEGIN
  sys.dbms_logmnr.start_logmnr(
    options => sys.dbms_logmnr.DICT_FROM_ONLINE_CATALOG
  );
END;
/
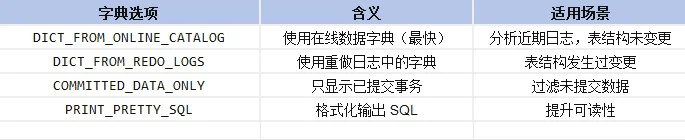
DICT_FROM_ONLINE_CATALOG:直接使用当前在线数据字典,无需预先生成字典文件,是最常用的方式。它要求被分析的表结构从操作发生到现在没有变过;如果中间做过 DDL,解析出的列名和类型会对不上,需要改用字典文件。
查询分析结果
先确认分析确实读到了数据,再按表名、操作类型和时间收窄范围。
-- 查看所有分析结果(谨慎使用,数据量可能很大)
SELECT
  username,scn,timestamp,operation,sql_redo
FROM v$logmnr_contents
WHERE username IS NOT NULL
ORDER BY scn;
-- 根据表名及操作类型,精准定位误操作
SELECT timestamp,
       username,
       operation,
       sql_redo,                 -- 原操作 SQL
       sql_undo                  -- 回滚 SQL(执行即可恢复数据)
FROM v$logmnr_contents
WHERE table_name  = 'TEST_DATA'  -- 被误操作的表名(大写)
  AND operation   = 'DELETE'     -- 操作类型:DELETE/UPDATE/INSERT
  AND timestamp   >= SYSDATE - 1 -- 时间范围(避免全表扫描)
ORDER BY scn;
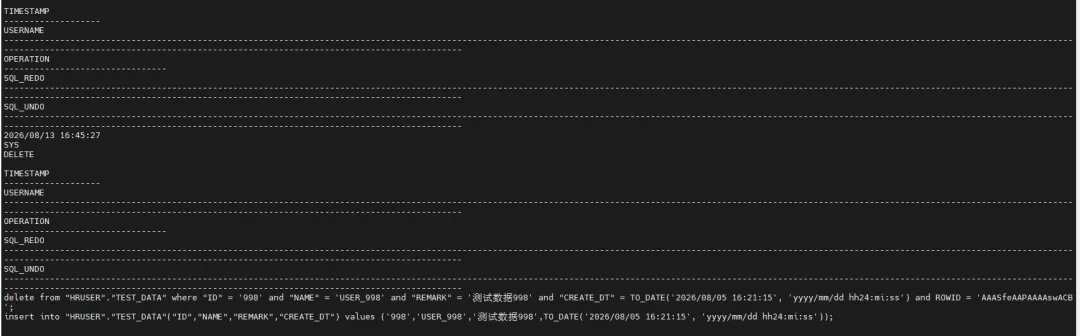
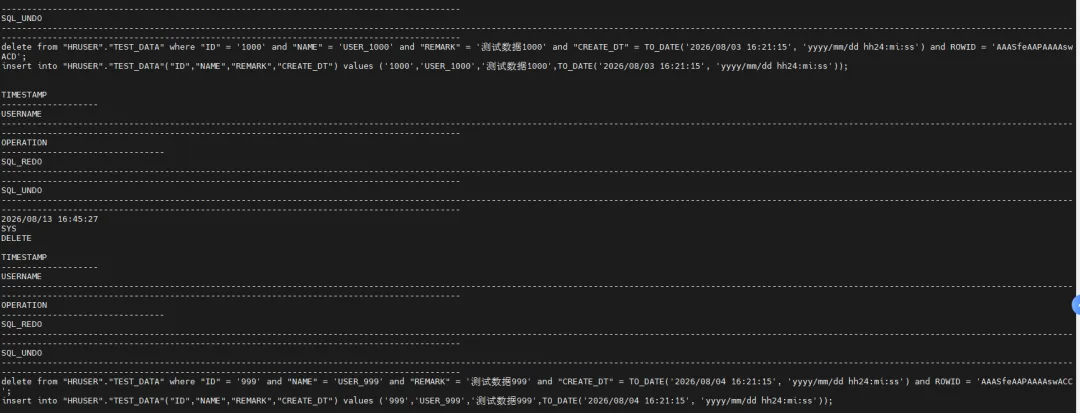
字段含义:
USERNAME        执行操作的数据库用户
SCN             系统变更号(可用于精准回放)
TIMESTAMP       操作发生时间
OPERATION       操作类型(DELETE/UPDATE/INSERT/DDL)
SQL_REDO        重做 SQL(重新执行该操作)
SQL_UNDO        回滚 SQL(反向操作,用于恢复)
注意:v$logmnr_contents 是管道视图,每次查询都会重新解析日志,建议加 WHERE 条件限制范围,避免全量扫描。表名必须大写,因为字典里存的是大写标识符。
生成并执行回滚 SQL
方式 1:直接从视图提取并执行。 适合行数很少的场景,PL/SQL 循环逐条执行 SQL_UNDO。
DECLARE
  v_sql VARCHAR2(4000);
BEGIN
  FOR r IN (
    SELECT sql_undo
    FROM v$logmnr_contents
    WHERE table_name = 'TEST_DATA'
      AND operation = 'DELETE'
      AND sql_undo IS NOT NULL
  ) LOOP
    EXECUTE IMMEDIATE r.sql_undo;
  END LOOP;
  COMMIT;
END;
/
BEGIN
  sys.dbms_logmnr.end_logmnr;
END;
/
-- 关闭后 v$logmnr_contents 视图不再可查
注意:end_logmnr 会释放 PGA 内存,长时间不关闭可能导致内存溢出。
数据量大时不推荐这种方式:中间没有人工审核,一条错误的 SQL_UNDO 会被直接执行,等于二次误操作。
方式 2:先导出到文件,审核后执行。 生产环境应走这条路径。
-- 第一步:关闭当前分析(如需重新指定时间范围)
BEGIN
  sys.dbms_logmnr.end_logmnr;
END;
/
-- 第二步:重新启动分析(指定时间范围,精准定位)
BEGIN
  sys.dbms_logmnr.start_logmnr(
    startTime => TO_DATE('2026-08-13 16:45:00', 'YYYY-MM-DD HH24:MI:SS'),
    endTime   => TO_DATE('2026-08-13 16:49:00', 'YYYY-MM-DD HH24:MI:SS'),
    options   => sys.dbms_logmnr.DICT_FROM_ONLINE_CATALOG
  );
END;
/
-- 第三步:SPOOL 导出回滚 SQL
SPOOL /tmp/rollback_undo_test_data.sql
SELECT sql_undo || ';' FROM v$logmnr_contents WHERE table_name = 'TEST_DATA' AND operation = 'DELETE' AND sql_undo IS NOT NULL;
SPOOL OFF
导出后先看三件事:行数是否与误删行数一致;WHERE 条件是否只命中目标行;UNDO 里的主键值是否都在预期范围内。确认无误再执行:
@/tmp/rollback_undo_test_data.sql
恢复后的验证
回滚 SQL 执行完不要立刻关单,按下面三步确认:
-- 1. 行数与业务预期比对
SELECT COUNT(*) FROM hruser.test_data WHERE id IN (998,999,1000);

-- 2. 关键列与原值比对(如果业务侧留有导出或对账文件)
SELECT id,name,remark,create_dt
FROM hruser.test_data
WHERE id IN (998,999,1000)
ORDER BY id;

-- 3. 确认没有多补、重复补
SELECT id, COUNT(*) FROM hruser.test_data GROUP BY id HAVING COUNT(*) > 1;
如果表上有触发器、物化视图日志或审计策略,回滚操作会再次触发它们。执行前应确认这些副作用可以接受,必要时在测试库先跑一遍。对于有外键引用的表,先恢复父表再恢复子表,否则插入会被约束拒绝。
最后把本次分析的归档序列、SCN 范围、执行的 UNDO 条数记入故障单。下次遇到同类问题时,这份记录能直接把定位时间从小时级压到分钟级。
权限与常见问题
执行 LogMiner 的账号需要能调用 SYS 下的包,并查询动态视图。生产上通常用 DBA 或单独授权的账号:
GRANT EXECUTE_CATALOG_ROLE TO hruser;
GRANT SELECT ON v_$logmnr_contents TO hruser;
GRANT SELECT ON v_$archived_log TO hruser;
几个现场高频问题:
- ORA-01291: missing logfile:分析列表里的文件与实际归档不匹配,或日志已被删除。用
v$logmnr_logs核对列表,重新add_logfile。 - SQL_UNDO 为空:表没有主键、没开补充日志,或者操作是 DDL。补开
SUPPLEMENTAL LOG DATA (ALL) COLUMNS只对之后的日志生效,救不了已经发生的操作。 - 查不到误操作:先确认归档文件覆盖了那个时间段;再确认误操作是在 CDB 根容器发生的,PDB 内执行
start_logmnr不会报错,但视图是空的。 - 分析很慢:不要一次装入全部归档。按
FIRST_TIME/NEXT_TIME先圈定 1 到 2 个序列,必要时用startTime/endTime再收窄。
分析期间占用的 PGA 与日志量成正比。挖掘几个 GB 的归档时,先在测试库估算内存,再决定是否在生产库直接跑。
标准流程
1、归档模式确认: ARCHIVELOG = ENABLED
2、开启补充日志: ALTER DATABASE ADD SUPPLEMENTAL LOG DATA;
3、定位归档文件: SELECT name FROM v$archived_log WHERE ...
4、添加日志文件: dbms_logmnr.add_logfile() 、 第一个用 NEW
5、启动分析:dbms_logmnr.start_logmnr()、DICT_FROM_ONLINE_CATALOG
6、查询定位: SELECT sql_undo FROM v$logmnr_contents WHERE ...
7、导出回滚SQL: SPOOL /tmp/rollback_undo_test_data.sql
8、审核并执行: @/tmp/rollback_undo_test_data.sql
9、关闭分析:  dbms_logmnr.end_logmnr;
注意事项
1、生产环境务必开启归档模式 + 最小补充日志
2、误操作后立即停止业务写入、备份当前归档日志
3、回滚 SQL 先导出到文件,审核后再执行(避免二次误操作)
4、v$logmnr_contents 查询务必加时间/表名过滤条件
5、分析完成后及时调用 end_logmnr 释放资源
另外两点在恢复现场必须确认:
- 误操作后不要急着重启实例。重启不会让数据回来,先停业务写入、备份归档日志,再决定恢复方式。
- 如果误操作事务已提交,之后又有其他事务改了同一批行,直接执行 SQL_UNDO 会覆盖后来的正确数据。这种情况要按 SCN 只回滚目标事务,或先在测试库演练。
待核对
- 归档文件列表的示例输出中,序列 92、93 的 FIRST_TIME 都是 2026/08/07,NEXT_TIME 都是 2026/08/13,与"每小时一个归档"的常规不符,疑为原文列对齐错位;实际以
v$archived_log查询结果为准。 - 原文称"12c 以上需要在 CDB 下执行,PDB 下执行无效",该说法适用于 CDB 架构;非 CDB 库仍在根容器执行,建议在目标库实测确认。
原文首发于微信公众号「止水研习社」。

文章评论