代码审计这件事,工具一直没真正解决。规则引擎漏报多、误报更多,跑一遍出来几百条,安全工程师的时间全花在关误报上;换成大模型,一条一条读代码又太贵,几十万行的仓库跑不完。
阿里把内部在用的 OpenCodeReview 开源了,思路不是「让 AI 替代规则」,而是把确定性工程和 Agent 分工:文件筛选、分组、定位、结果反思交给代码,只有真正需要判断的地方才交给模型。官方给的数据是:对比 Claude Code 处理 1000 个 PR,Token 成本只有 1/9。
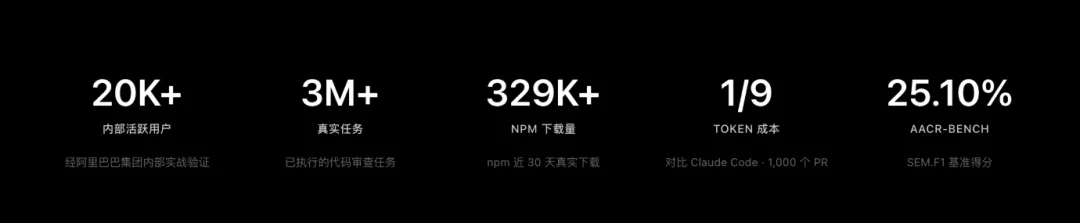
它是什么
OpenCodeReview 是一个 CLI 工具,命令是 ocr。安装完就能在任意仓库里跑,支持增量 diff 审查和全量代码扫描。定位很明确:不是替代专业渗透测试或人工审计,而是做「每次提交都跑得起的高精度日常防线」。
它要解决的是传统 SAST 的两个老毛病。漏审意味着漏洞带病上线;误报意味着审计报告没人信。纯 LLM 方案能压住漏报,但成本和稳定性都不行。OpenCodeReview 选的是中间路线:内置规则引擎保证覆盖率,LLM Agent 负责在规则命中的位置上做深度判断。
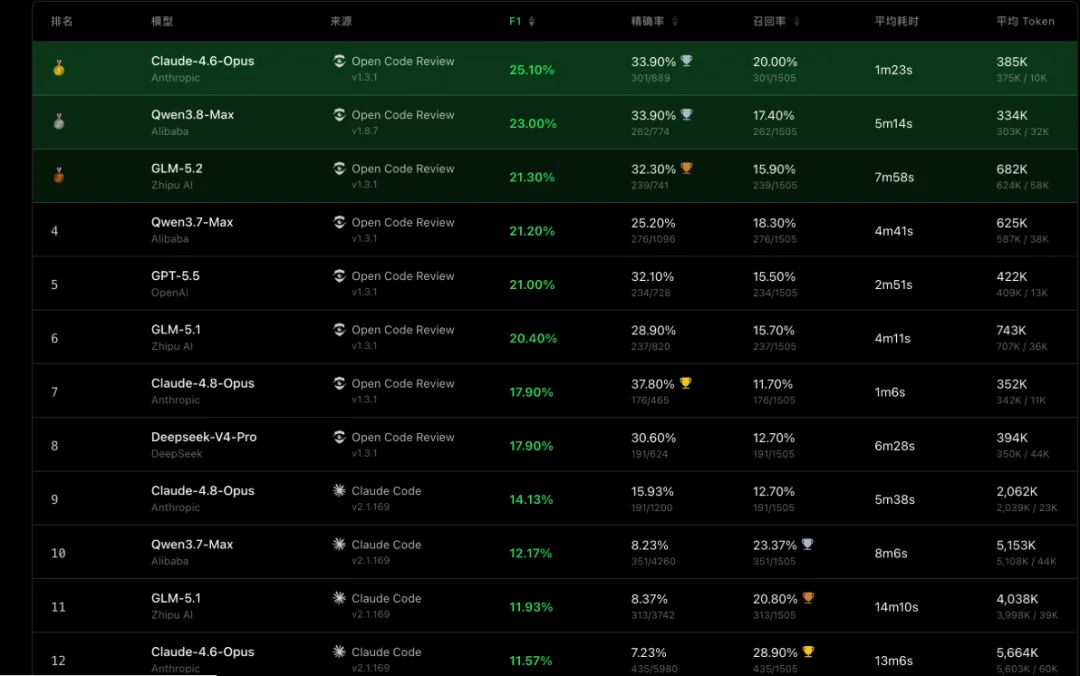
上图是它自己的评测榜。Claude-4.6-Opus 走 OpenCodeReview 的链路拿到 25.10% 的 F1,比同一个模型直接走 Claude Code 的 11.57% 高出一倍多。有意思的不是排名,是同一个模型换一套工程约束,效果能差这么多。
内置规则:先按文件类型分流
这是它和「把仓库丢给大模型」最本质的区别。规则不是无差别触发,而是按文件特征精细化命中:Java 文件重点审 NPE 和线程安全,MyBatis 的 XML Mapper 重点审 SQL 注入,前端文件重点审 XSS。
模型每次只看一小段、且只看它该看的东西,注意力和上下文都不会被稀释。内置覆盖的类型大致是这样:
| 漏洞类型 | 审计重点 |
|---|---|
| SQL 注入 | Mapper 里的拼接、动态 SQL |
| XSS | 前端不可信输出未转义、危险 DOM 操作 |
| 命令注入 | 拼接用户输入执行系统命令 |
| 路径穿越 | 文件读写路径拼接未校验 |
| SSRF | URL 参数可控、未过滤内网地址 |
| 反序列化 | 不可信数据反序列化、危险类实例化 |
| 硬编码密钥 | 源码里的 AK/SK、密码、Token、私钥 |
| 线程安全 | 共享变量无同步、map 并发读写 |
| NPE / 资源泄漏 | 空指针、句柄未释放 |
| goroutine 泄漏 | 无退出条件、channel 阻塞 |
官方给的一个例子很能说明问题:一段看起来无害的 Go map 读写,被内置线程安全规则直接标成 Critical 级竞态,并附上带 sync.RWMutex 的完整修复方案。这种问题靠正则永远抓不到,靠大模型又很容易被上下文淹没。
不是正则,是看懂上下文
传统 SAST 被编码绕过、拼接绕过耍得团团转,是因为它只看语法形状。OpenCodeReview 的 Agent 能做三件规则做不到的事:读完整文件判断这处拼接到底有没有经过过滤;搜索整个代码库追溯数据来源;跨文件关联,比如 Controller 层缺了参数校验,会在 Service 层埋雷。
这三件事决定了它能不能用在真实项目上。真实项目的漏洞很少长在一个函数里,都是「入口没校验 → 中间透传 → 底层拼接」这样跨三四个文件的链路。
没有 Git 历史也能审
安全场景里最实用的能力之一。你要审计的经常是接手的不熟悉系统、外包交付的没有提交历史的代码、或者一个根本没有 diff 可比的目录。
ocr scan 直接审查整个文件而不是 diff,不需要 Git 历史。配合 --path 指定目录,可以对一个模块做定向排查。这一点比很多只支持 PR diff 的工具实用得多——真实的安全评估,往往发生在你还没有版本历史的时候。
把团队的安全红线写进配置
内置规则之外,规则系统支持四层优先级:CLI 参数 > 项目配置 > 全局配置 > 内置规则。团队可以在项目根目录的 .opencodereview/rule.json 里定义自己的标准:
{
  "rules": [
    {
      "path": "**/*mapper*.xml",
      "rule": "检查 SQL 是否存在注入风险、参数错误、标签未闭合"
    },
    {
      "path": "force-api/**/*.java",
      "rule": "所有新增方法必须对必填参数做 null 校验"
    }
  ]
}
OWASP Top 10 里的反序列化、SSRF、路径穿越、硬编码密钥,都可以用这种方式纳入日常审计。意义在于把安全规范从「Wiki 里的一份文档」变成「每次提交自动执行的检查」——文档没人看,检查跑得过就跑不过。
两个关键设计
委托模式。 涉密项目不能把代码发给外部 API,可以让私有部署的 LLM 或宿主 AI Agent 执行审查,OpenCodeReview 只负责文件筛选和规则解析,代码不出内网。这是它能进金融、政企环境的前提。
CI/CD 卡点。 接入 GitHub Actions 或 GitLab CI 后,每个 PR 自动审查,审查意见直接回贴成行级评论。漏洞在合并前被拦下,而不是等季度审计才发现。
客观说一句:它的 Recall 低于通用 Agent,Benchmark 作者也明确说明不要指望它替代专业安全审计工具。它的定位是「每次提交都跑得起的高精度日常防线」。
这句话很重要。一个工具的适用边界说清楚了,才值得放进流程里。把它当季度审计的替代品会出事,当每天的守门人则很合适。
安装与使用
npm install -g @alibaba-group/open-code-review装完 ocr 命令全局可用。也支持安装脚本、GitHub Release 二进制、Homebrew 等方式。
先配模型通道:
ocr config provider   # 选择内置供应商或添加自定义供应商
ocr config model      # 为当前供应商选择模型
交互界面会引导输入 API Key 并自动测试连通性。然后就可以审了:
cd your-project

# 工作区模式:审查所有变更
ocr review

# 分支范围审查
ocr review --from main --to feature-branch

# 单个提交
ocr review --commit abc123

# 全量文件扫描
ocr scan --path internal/agent

# 输出 JSON(CI / Agent 推荐)
ocr review --format json --output result.json
怎么用才不浪费
我自己的判断是,这类工具的价值不在「发现多少个漏洞」,而在「能不能长期挂在流程里」。一个误报率高的工具,团队用两周就会关掉。
所以落地顺序应该是:先只开内置规则,观察一周误报;再按团队真实踩过的坑写两三条自定义规则;最后才接 CI,设成不阻塞合并、只留评论。等规则稳定了再考虑卡点。
它不适合当唯一的审计手段。适合当那个「每次提交都会看一眼」的东西——绝大多数高危漏洞,本来就是在这种日常疏忽里埋进去的。

文章评论