开发者 Akhila 开源了 Jev-Omni,一个支持文本、图像、音频、视频四类输入的多模态决策模型。用法与纯文本版 Jev 一致:传入当前状态、问题和候选选项,模型不输出长解释,直接返回每个选项的概率分布,用于分类、路由和动作选择。
上一篇开源版 Jev 的教程发出去后,有读者在评论区留言「可惜没有多模态」。这次补上了。
实际业务里这类需求很常见:视频审核要看画面,质检要听设备声音,监控要判断镜头里有没有人,纯文本输入无法覆盖这些场景。本文整理 Jev-Omni 的定位、本地部署全流程,以及它用单一模型支持四种模态的实现思路。文中延迟与显存数据均在一张 GB10 算力卡(121 GB 统一内存,驱动 580.173.02,Python 3.12,PyTorch 2.14)上实测采集;安装命令、测试脚本和全部执行日志收录在实验仓库,显存或内存不足、只想查看运行结果的读者,可以直接查阅仓库中的执行日志,无需下载模型权重。
Jev-Omni 是什么
Jev-Omni 是一款面向多模态输入做判别的决策模型,以 Apache-2.0 协议开源。它在 Gemma 4 12B IT 底座上完成了约 3 万题微调,官方基准成绩为 JevBench 86.15%、DecisionBench Medium 87.57%。
校准方面,DecisionBench Medium 上的 ECE 为 0.04,数值越低代表预测概率越贴近实际发生频率,校准曲线基本落在对角线上:模型给出 0.9 置信度时,实际大约就是 0.9 的把握。业务系统可以直接把输出概率当作路由阈值,不需要额外换算。
它的定位不是在所有指标上追上大模型。模型卡提供了一张性价比对比图,把它与 Jev 1.13、Gemini 3.8 Flash、GPT-5.6 Luna、Claude Sonnet 5 放在同一坐标系下比较:约九成的准确率,配上很低的单次调用成本。在成本敏感、需要高频调用的场景里,这个组合有工程价值。
它也容易与 Laya 混淆,两者分工明确:要求极低延迟与高并发的纯文本判定,选择 Laya;需要多模态输入、且能接受百毫秒至秒级延迟的场景,选择 Jev-Omni。
部署四步走
第一步,环境准备
部署需要 CUDA 显卡,官方参考加载器暂不支持纯 CPU 运行。FP32 分发的决策骨干权重约 48 GB,叠加约 24 GB 的 Gemma 4 底座,加载阶段的内存峰值接近 60 GB,建议准备 60 GB 以上可用显存或内存;统一内存架构设备可正常运行。加载完成后,运行时常驻显存实测约 27 GB。音频和视频预处理依赖 ffmpeg,需要提前安装并配置到 PATH。运行环境要求 Python 3.10 以上,本次实测为 3.12。
建议新建独立虚拟环境,终端执行(Windows 环境将第二行替换为 .venv\Scripts\activate):
python -m venv .venv
source .venv/bin/activate
依赖清单 requirements.txt 可直接从实验仓库下载;国内网络直接拉取 raw 链接受阻时,可在链接前附加 GitHub 代理加速前缀:
curl -L -o requirements.txt https://ghfast.top/https://raw.githubusercontent.com/li-xiu-qi/XiaokeAILabs/main/experiments/test_jev_open_source/jevomni/requirements.txt
pip install -r requirements.txt
有两项版本约束需要严格对齐:transformers 必须安装 5.17.0,底座 Gemma 4 的模型结构在更低版本中无法被识别导入;torch 与 torchvision 建议结合本机 CUDA 驱动版本安装匹配构建。
从 HuggingFace 官方源拉取权重速度受限时,可配置国内镜像源地址。新版下载客户端默认启用的 Xet 传输协议在部分镜像站暂未支持,可能引发 401 报错,因此需要配置环境变量,回退到常规下载模式:
export HF_ENDPOINT=https://hf-mirror.com
export HF_HUB_DISABLE_XET=1
第二步,下载权重
权重总计约 72 GB,包含 Jev-Omni 的 48 GB FP32 决策骨干(13 个分片)与 24 GB 的 Gemma 4 底座(BF16 格式)。实验仓库提供自动化下载脚本,国内环境可附带 --mirror 参数使用镜像节点:
python scripts/download_models.py --mirror需要把权重归档至自定义目录时,可指定 --target-dir 参数,后续在验证脚本中传入匹配的 --models-dir 即可准确定位。运行下载脚本后,文件会自动保存至 models/ 目录;未声明 --target-dir 参数时则保存在 HuggingFace 默认缓存目录。权重体积大,仓库未打包存储权重文件,克隆仓库本身很快。
第三步,准备测试素材
图像、音频与视频测试素材同样通过脚本在运行时拉取:
python scripts/download_assets.py脚本执行完成后,assets/ 目录下会准备好三组免费且可商用的独立素材:虎斑猫照片 cat.jpg、约 12 秒的英文双人对话音频 conversation.mp3、约 19 秒的人物近景视频 person-reading.mp4。三组素材来自独立文件而非同一段视频的切片截取,分别对应图像、音频与视频三种模态;素材来源于 Flickr、Freesound 与 Pexels 开源集,下载过程中包含哈希校验。
需要执行更全面的基准评测时,给脚本追加 --full 参数,可在 assets/eval/ 路径下扩充 10 类图片和 3 段音频测试集:
python scripts/download_assets.py --full第四步,最小验证
完成环境配置、权重下载与素材准备后,执行最小验证脚本。它仅加载一次模型,随后依次遍历四个模态的样例:
python scripts/quickstart.py初次运行需要将 48 GB 的 FP32 分片载入内存,实测模型加载耗时约 8 分钟(423 到 449 秒),时间开销主要集中在磁盘读取阶段。加载完成后,终端将依次输出五个测试用例的判定结果,覆盖文本、图像、音频、视频四种模态。
看懂返回结果
以中文工单分类用例为例,调用代码传入三个核心参数:状态描述、问题文本以及候选选项集合:
clf.predict(
    state="我这个月信用卡被扣了两次费,请尽快把多扣的钱退给我",
    question="这个请求应该由哪个部门处理?",
    options=["账务", "技术", "销售", "其他"],
)
输入数据结构是标准的「状态 + 问题 + 固定选项」。模型不展开生成解释文本,仅在给定候选中计算各选项的概率分布。GB10 算力卡上实测输出如下:
{
  "prediction": "账务",
  "prediction_index": 0,
  "confidence": 0.997093677520752,
  "probabilities": {
    "账务": 0.997093677520752,
    "技术": 0.000299832783639431,
    "销售": 0.0003560602490324527,
    "其他": 0.002250370336696055
  }
}
返回对象是原生结构化字典,业务端可以直接提取键值,无需额外编写正则匹配规则,也不必防范 JSON 解析语法异常。四个字段的含义:
- prediction:置信度最高的选项;
- prediction_index:该选项在候选列表中的下标;
- confidence:对应概率值,工程落地中最核心的判断依据,可直接用作业务路由阈值;
- probabilities:全部候选的概率分布。
置信度达到设定阈值时执行自动化路由;置信度不足时,交由大模型二次判别,或回退至人工审核。
延迟方面,GB10 上文本、图像、音频单次推理耗时均在 1 秒以内;视频用例需要处理 16 帧,单次约 4 秒。首次推理因模型预热开销耗时稍长,生产调用前建议先空跑一次预热请求。
延迟数据分两个口径:官方基准在 H200 上启用优化后端推理环境测得,仅统计预热后的核心中位数耗时,未计入系统预处理与网络传输开销;GB10 数据为分位数口径的实测值。两者不是同一档硬件,延迟差距主要来自算力规格,横向比较时需要注意口径。
一个模型怎么支持四种模态
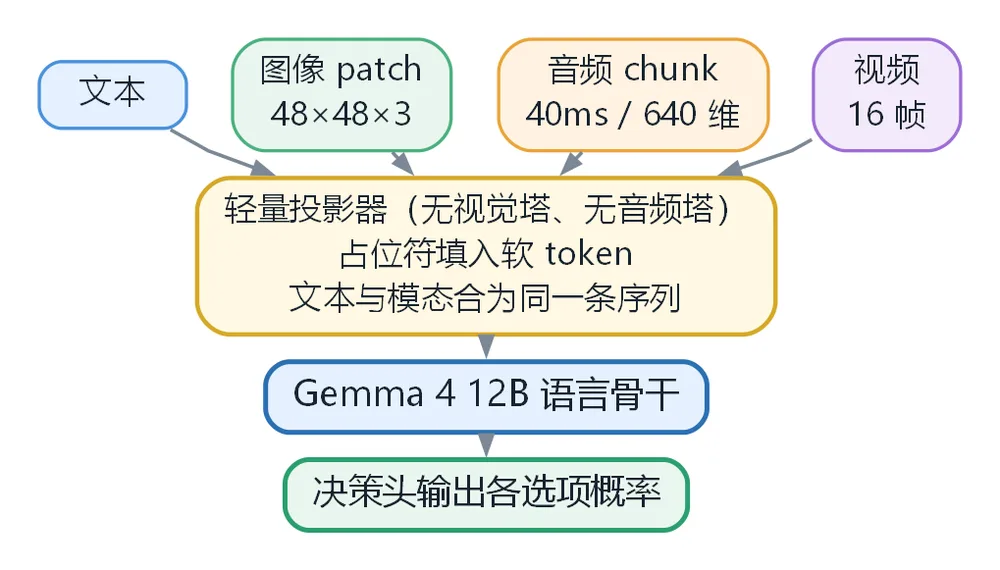
Jev-Omni 的多模态能力来自 Gemma 4 底座。文本、图像、音频与视频输入先各自经过一个轻量投影器,转化为统一维度的 token 表示;随后这些 token 与文本拼进同一条序列,送入同一个底座语言模型,最终由顶层的分类头给出各选项的置信概率。
这种设计没有采用独立的重量级视觉塔或音频塔,多模态前端变换非常轻量,端到端延迟很低;代价是对高复杂度图像或超长音频的深层特征抽取能力相对有限。
实验仓库
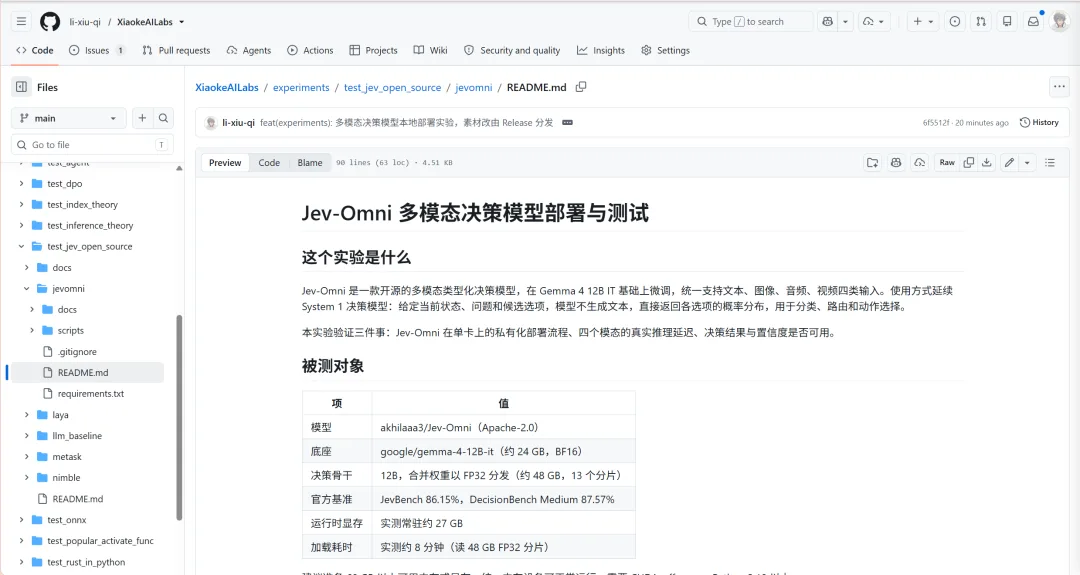
文中涉及的测试脚本、配置清单与实测终端日志均已整理至实验仓库,克隆仓库后即可按步骤完整复现:
git clone https://github.com/li-xiu-qi/XiaokeAILabs.git
cd XiaokeAILabs/experiments/test_jev_open_source/jevomni
仓库内仅包含代码与文档。按上述步骤执行脚本后,会在本地自动创建并填充 models/、assets/ 与 results/ 目录。仓库中还包含延迟基准测试与批量评估脚本,全部脚本的原始终端运行日志保存在 experiments/test_jev_open_source/docs/执行日志/ 目录。
写在最后
多模态决策是个很实际的需求:判断画面里有没有人、声音是不是异常。这类问题选项明确,要的是一个带置信度的判断,不需要一段生成式描述。Jev-Omni 把文本、图像、音频、视频统一到同一个决策接口,权重也已开放下载,本地就能低成本验证这些想法。
它更适合选项明确、需要概率判定的场景。建议先把环境搭好、最小脚本跑通,再换成自己的真实素材测一测,决定它在流水线里承担什么角色。

文章评论