随着AI大模型的兴起,尤其是近期DeepSeek驱动下AI端侧推理需求爆发,存算一体技术开始被部分产业人士和投资人关注。根据我们的调研,存算一体技术也是人形机器人产业较为看好的技术方向,如果技术成熟,未来将是人形机器人的理想算力形态。本文我们将介绍这一技术并讨论其在人形机器人领域的前景。
存算一体兴起的背景——冯诺依曼结构与瓶颈
目前,主流的CPU、GPU、DPU芯片普遍按照冯诺依曼结构设计,计算与存储分离。一个典型的冯诺依曼结构CPU设计如下图所示,CPU与存储器互相传输数据并产生输出。
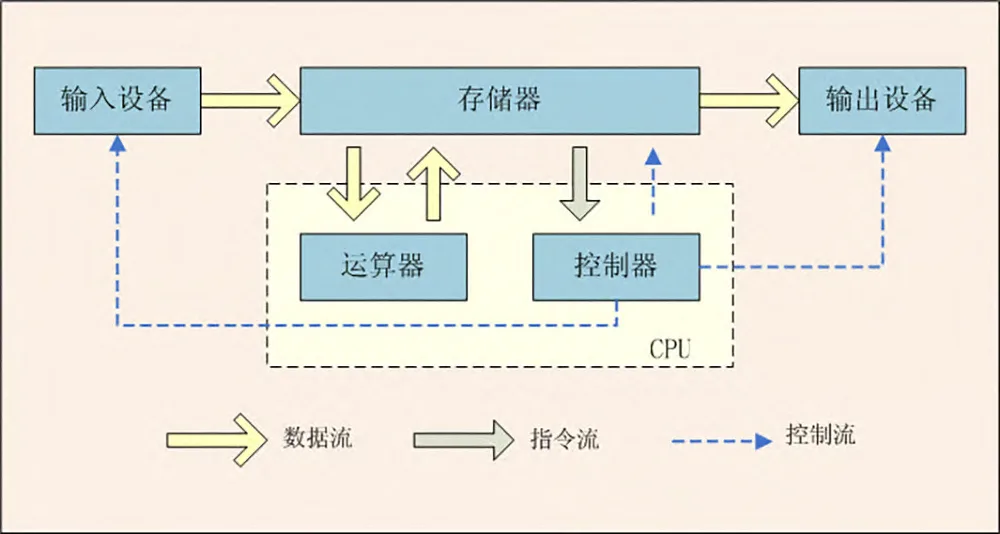
计算与存储的分离会产生所谓的冯诺依曼瓶颈,指计算单元对数据的处理、计算能力受到其与存储器之间的数据传输带宽限制,芯片空有计算能力,但拿不到计算需要的数据。这一瓶颈的主要原因是存储芯片的性能发展与成本下降长期滞后于计算芯片:
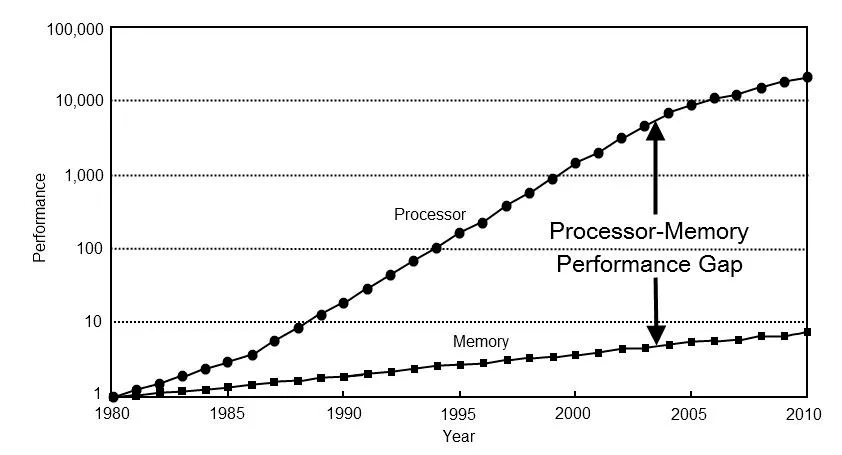
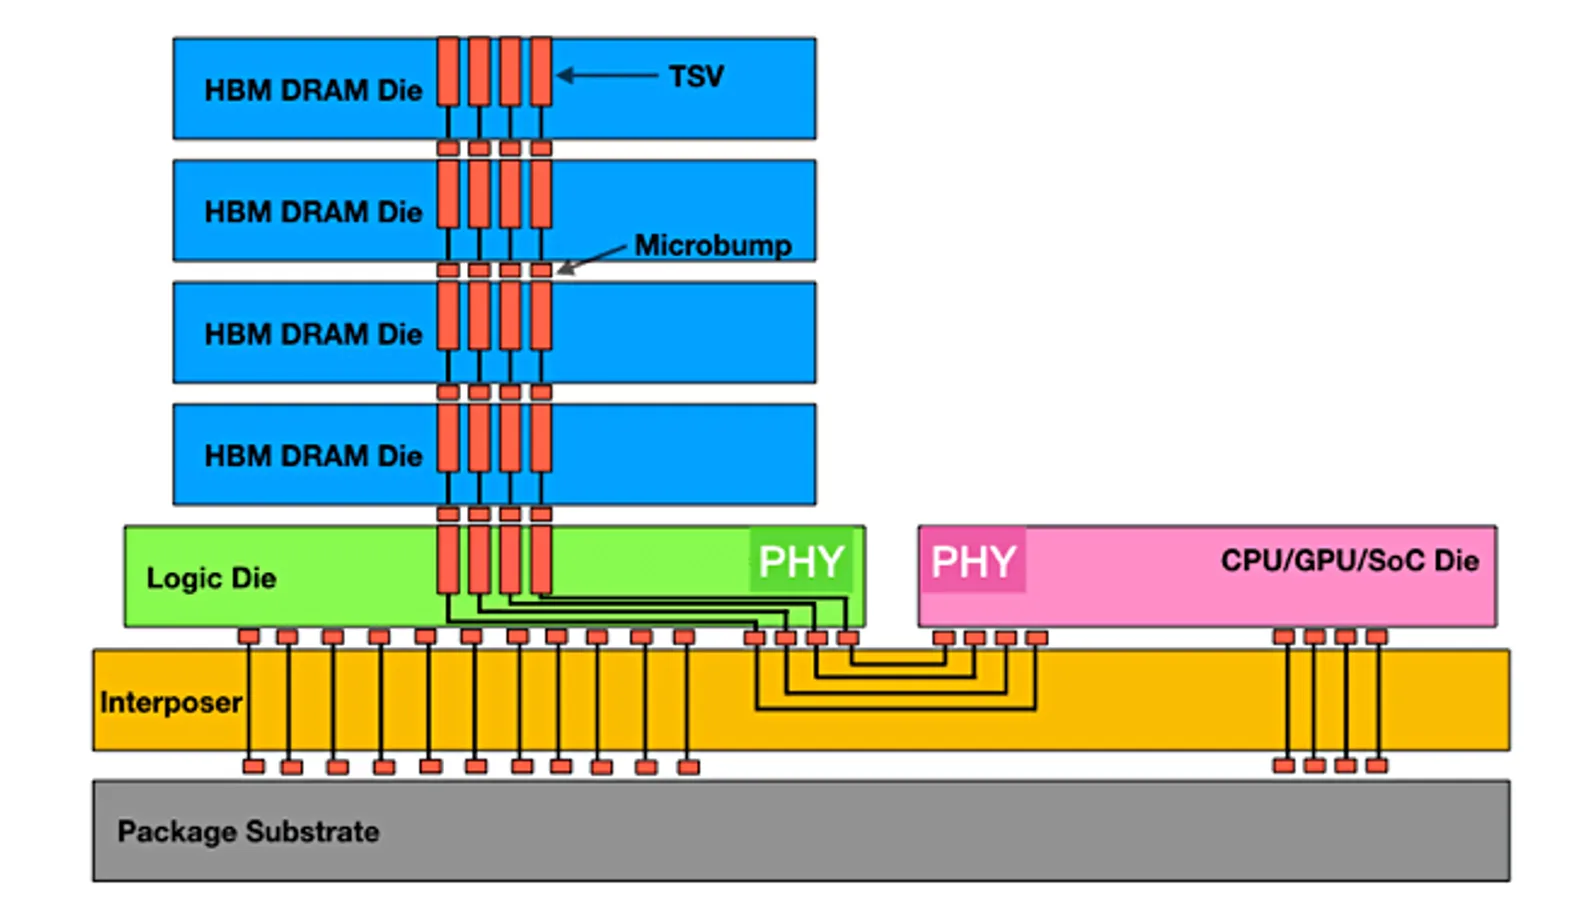
随着近年来摩尔定律发展日益趋缓,计算芯片的计算能力提升速度趋缓,芯片公司普遍开始改善与计算芯片配套的存储器以提升芯片的整体性能,比如当前热门的HBM(高带宽内存),提升的就是计算芯片与存储器之间的传输带宽。然而,搭配HBM的芯片依然属于冯诺依曼架构,计算单元与存储器是分离的,未来仍有可能面临冯诺依曼瓶颈。
什么是存算一体?近存计算、存内处理与存内计算
存算一体的界定并不严格,有广义、狭义之分,其技术理念其实不算新鲜。虽然严格意义的存算一体芯片(指存内计算)尚未成熟,但广义的存算一体架构早就被纳入现代CPU、GPU芯片的设计中。比如下图是现代典型的CPU+存储器架构。存储器被分为三级,第一级是CPU的三级缓存(L1-L3 cache,一般采用SRAM,L1 cache在CPU内部),与CPU交换数据的速度较快,但容量小、成本高,缓存的加入本身就涉及存算一体的技术理念。在第一级存储之外,才是以DRAM为主的第二级存储,以及SSD、HDD为主的第三级存储。

现代GPU的架构与之类似,实际上也配有高速但小容量缓存,以英伟达A100芯片为例,其计算单元内部有192 KB L1缓存,下一层级是40 MB L2缓存,再下一级才是40 GB的DRAM(HBM2)。
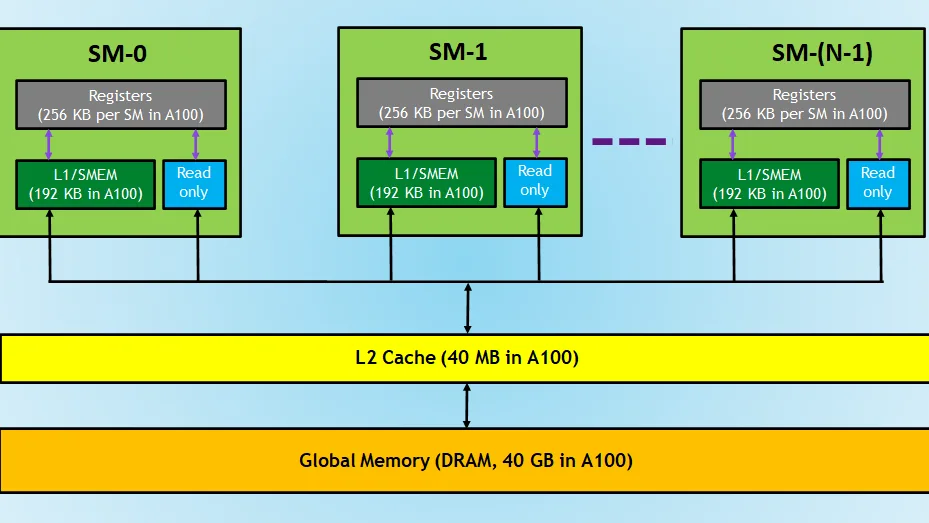
这里描述的CPU和GPU的多级缓存以及HBM,实际上就是一种近存计算或存内处理。
近存计算(Processing Near Memory, PNM):指采用先进封装等技术将计算单元和存储器尽可能地靠近,使得计算单元和存储器之间数据传输的带宽提升、环节减少。HBM就算是一种近存计算,将DRAM内存颗粒通过硅通孔(TSV)多层堆叠以实现存储容量提升,再基于硅中介板的高速接口与计算单元互联提高互联带宽。
存内处理(Processing In Memory, PIM):指将计算单元和存储器集成在同一个晶粒(Die)中,相比近存计算存算间距更近。CPU、GPU中的L1缓存可以视为一种存内处理,只是存储器容量极小。近年来也有HBM-PIM、PIM-DIMM等存内处理方案,在DRAM Die中内置计算单元,提供大吞吐量、低延迟的片上处理能力,可用于语音识别、数据库检索等场景。比如三星提出的HBM-PIM方案,将PIM单元、DRAM集成在同一个Die中再进行3D堆叠,这样DRAM的数据可以预先通过PIM进行初步处理再传输至GPU,从而加强数据处理的效率。
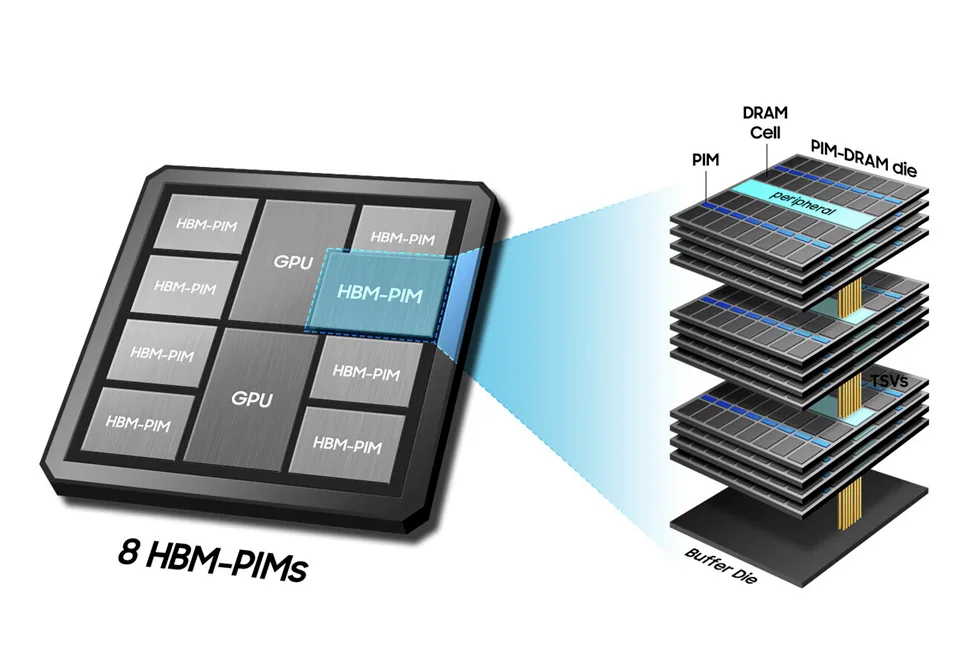
存内计算(Computing In Memory,CIM):不再区分存储单元和计算单元,而是真正融合存储单元和计算单元,这种技术路线是真正狭义上的存算一体。存内计算最典型的场景是为AI算法提供向量矩阵乘法加速,目前的AI大模型背后的运算基本都是向量矩阵乘法,存内计算有望加速AI模型的运算速度。
存算一体芯片的可能形态
目前最为知名的以存算一体为特色的芯片可能是Groq开发的LPU,LPU是一款针对AI模型推理能力定制的ASIC芯片。其在设计上最主要的特色是并没有采取英伟达等公司采用的HBM存储器,而是选择了SRAM,即上文中一般用作小容量缓存的SRAM(静态随机存取存储)。SRAM历史悠久,早在上世纪便被开发出来,后来一般继承于SoC芯片中作为缓存使用。其具有高带宽、读写速度快、耐久度高的特征,但成本较高且受到芯片内部空间限制(SRAM单位面积大、功耗高),一般容量较小。而LPU通过搭载大容量的SRAM(是普通缓存用SRAM容量的千倍以上),使得其AI推理运算速度大幅提升。
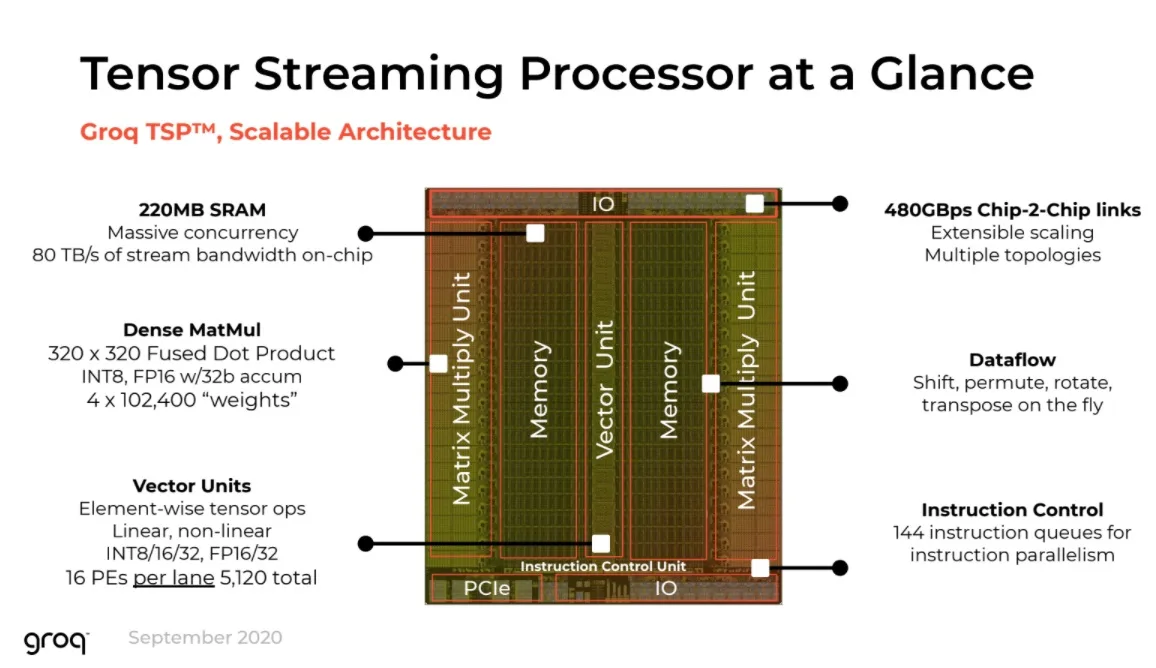
除SRAM之外,其他可能用于存算一体芯片的存储器还包括NOR Flash、RRAM(阻变随机存储、忆阻器)、MRAM(磁性随机存储)、PCM(相变存储)等。
为什么端侧AI推理芯片需要存算一体?
AI推理任务可以简单理解为数据输入——带入模型运算(矩阵乘法)——产生输出。所谓大模型,指的就是模型庞大、参数多、矩阵运算规模大。随着AI大模型的不断迭代,人们逐渐发现了“内存墙”的问题,主要指AI芯片存储容量的提升滞后于AI模型规模的提高,比如英伟达从Pascal架构到Hopper架构的显存容量只有4倍,但大模型规模的提升却有十万倍以上。
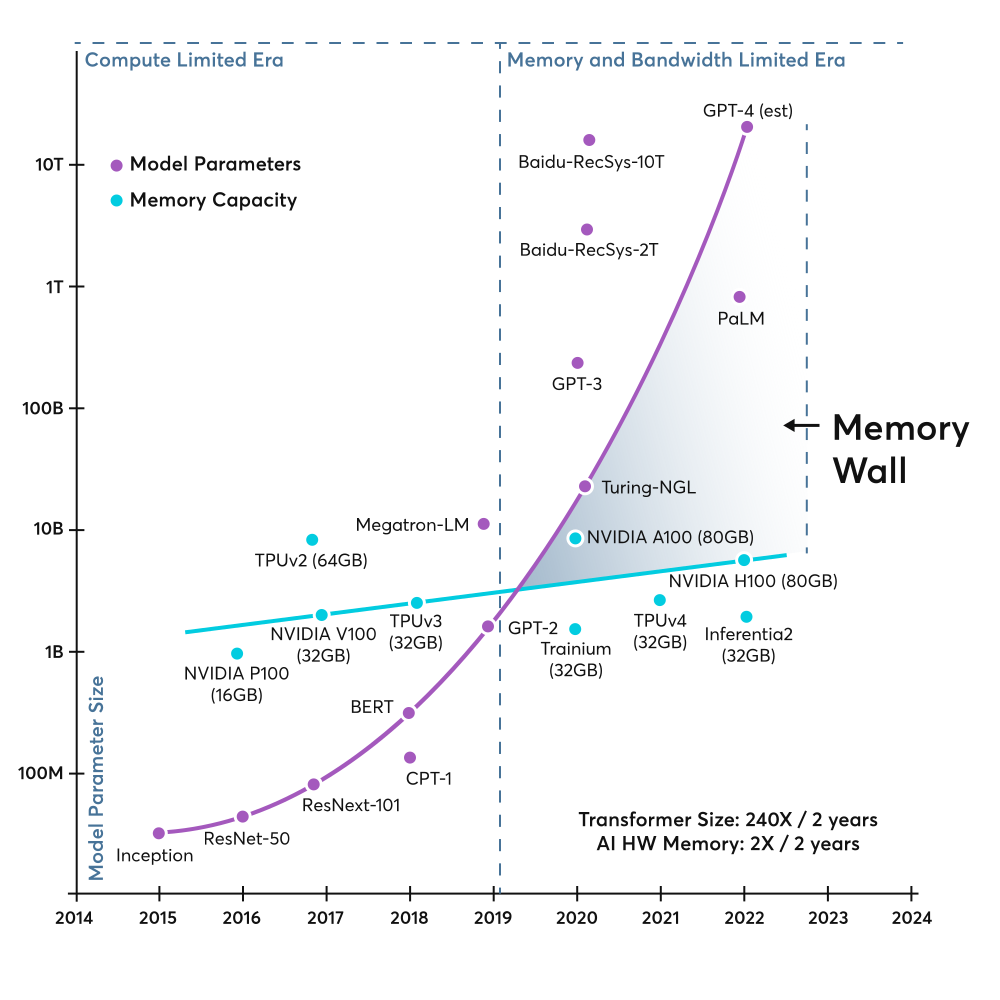
事实上,当前不管是训练还是推理,主要的瓶颈都是在存储而不是芯片计算能力。尽管DeepSeek V3/R1模型能够大幅提升硬件调用和计算效率,但想要在端侧部署仍然需要相当大的内存容量,否则就只能牺牲模型效果去选择参数小、蒸馏过的模型。存内计算可能是未来这一限制、使得端侧能够本地运行高性能模型的关键。
存算一体在人型机器人领域的展望
不同于一般的AI应用,人形机器人的大脑芯片对推理的延迟性、稳定性、端侧计算能力要求极高,需要能够在不联网状态下进行低延迟且稳定的推理。自动驾驶也是同理,但自动驾驶芯片搭载在车上不太受体积、散热制约,而人形机器人芯片需要考虑体积、散热的性质。因此,为了提高端侧推理的能力和效率,存算一体可能是未来人形机器人端侧算力的理想形态。
目前已经有不少人形机器人产业的开发者开始关注存算一体技术或开发相关芯片。例如英国一家AI芯片公司Fractile正在利用存算一体技术开发高效率的AI推理芯片,宣称能够以100倍的速度、十分之一级别的成本(与H100对比)进行大模型推理,并且认为这款芯片将成为人形机器人大脑的关键。
此前我们的文章已经介绍过人形机器人AI模型的复杂程度。人形机器人需要通过机体内部和外部的多种传感器接收各种复杂信息,再带入到比自动驾驶模型复杂得多的AI模型内进行运算,且需要及时、稳定地输出结果,以保证人形机器人能够动态地与环境交互并完成任务。
目前,除特斯拉自行开发推理芯片(FSD芯片)外,人形机器人最为强大的端侧推理芯片应该是英伟达的Jetson系列,当前的旗舰版本搭载64GB DDR5显存、能够提供275TOPS算力。根据我们的分析,未来的人形机器人要具备完成多种任务的能力,可能需要1000TOPS以上的计算能力。在GPU摩尔定律趋缓的当下,存算一体可能是值得关注的未来趋势。
View Jetson Orin Technical Specifications
| Jetson AGX Orin series | Jetson Orin NX series | Jetson Orin Nano series | |||||||
| Jetson AGX Orin Developer Kit | Jetson AGX Orin 64GB | Jetson AGX Orin Industrial | Jetson AGX Orin 32GB | Jetson Orin NX 16GB | Jetson Orin NX 8GB | Jetson Orin Nano Super Developer Kit | Jetson Orin Nano 8GB | Jetson Orin Nano 4GB | |
| AI Performance | 275 TOPS | 248 TOPs | 200 TOPS | 157 TOPS | 117 TOPS | 67 TOPS | 67 TOPS | 34 TOPS | |
| GPU | 2048-core NVIDIA Ampere architecture GPU with 64 Tensor Cores | 1792-core NVIDIA Ampere c GPU with 56 Tensor Cores | 1024-core NVIDIA Ampere architecture GPU with 32 Tensor Cores | 1024-core NVIDIA Ampere architecture GPU with 32 Tensor Cores | 512-core NVIDIA Ampere architecture GPU with 16 Tensor Cores | ||||
| GPU Max Frequency | 1.3 GHz | 1.2 GHz | 930 MHz | 1173MHz | 1173MHz | 1020MHz | 1020MHz | 1020MHz | |
| CPU | 12-core Arm® Cortex®-A78AE v8.2 64-bit CPU 3MB L2 + 6MB L3 | 8-core Arm® Cortex®-A78AE v8.2 64-bit CPU 2MB L2 + 4MB L3 | 8-core Arm® Cortex®-A78AE v8.2 64-bit CPU 2MB L2 + 4MB L3 | 6-core Arm® Cortex®-A78AE v8.2 64-bit CPU 1.5MB L2 + 4MB L3 | 6-core Arm® Cortex®-A78AE v8.2 64-bit CPU 1.5MB L2 + 4MB L3 | ||||
| CPU Max Frequency | 2.2 GHz | 2.0 GHz | 2.2 GHz | 2 GHz | 1.7 GHz | 1.7 GHz | 1.7 GHz | ||
| DL Accelerator | 2x NVDLA v2 | 1x NVDLA v2 | - | ||||||
| DLA Max Frequency | 1.6 GHz | 1.4 GHz | 1.23 GHz | - | |||||
| Vision Accelerator | 1x PVA v2 | - | |||||||
| Safety Cluster Engine | - | - | - | ||||||
| Memory | 64GB 256-bit LPDDR5 204.8GB/s | 64GB 256-bit LPDDR5 (+ ECC) 204.8GB/s | 32GB 256-bit LPDDR5 204.8GB/s | 16GB 128-bit LPDDR5 102.4GB/s | 8GB 128-bit LPDDR5 102.4GB/s | 8GB 128-bit LPDDR5 102 GB/s | 8GB 128-bit LPDDR5 102 GB/s | 4GB 64-bit LPDDR5 51 GB/s | |
| Storage | 64GB eMMC 5.1 | - (Supports external NVMe) | - (SD Card Slot & external NVMe via M.2 Key M) | - (Supports external NVMe) | |||||
| Video Encode | 2x 4K60 (H.265) 4x 4K30 (H.265) 8x 1080p60 (H.265) 16x 1080p30 (H.265) | 1x 4K60 (H.265) 3x 4K30 (H.265) 7x 1080p60 (H.265) 15x 1080p30 (H.265) | 1x 4K60 (H.265) 3x 4K30 (H.265) 6x 1080p60 (H.265) 12x 1080p30 (H.265) | 1080p30 supported by 1-2 CPU cores | |||||
| Video Decode | 1x 8K30 (H.265) 3x 4K60 (H.265) 7x 4K30 (H.265) 11x 1080p60 (H.265) 22x 1080p30 (H.265) | 1x 8K30 (H.265) 3x 4K60 (H.265) 7x 4K30 (H.265) 11x 1080p60 (H.265) 23x 1080p30 (H.265) | 1x 8K30 (H.265) 2x 4K60 (H.265) 4x 4K30 (H.265) 9x 1080p60 (H.265) 18x 1080p30 (H.265) | 1x 4K60 (H.265) 2x 4K30 (H.265) 5x 1080p60 (H.265) 11x 1080p30 (H.265) | |||||
| CSI Camera | 16-lane MIPI CSI-2 connector | Up to 6 cameras (16 via virtual channels) 16 lanes MIPI CSI-2 D-PHY 2.1 (up to 40Gbps) | C-PHY 2.0 (up to 164Gbps) | Up to 4 cameras (8 via virtual channels***) 8 lanes MIPI CSI-2 D-PHY 2.1 (up to 20Gbps) | 2x MIPI CSI-2 22-pin Camera Connectors | Up to 4 cameras (8 via virtual channels***) 8 lanes MIPI CSI-2 D-PHY 2.1 (up to 20Gbps) | ||||
| PCIe* | x16 PCIe slot supporting x8 PCIe Gen4 M.2 Key M slot with x4 PCIe Gen4 M.2 Key E slot with x1 PCIe Gen4 | Up to 2 x8 + 1 x4 + 2 x1 (PCIe Gen4, Root Port, & Endpoint) | 1 x4 + 3 x1 (PCIe Gen4, Root Port, & Endpoint) | M.2 Key M slot with x4 PCIe Gen3 M.2 Key M slot with x2 PCIe Gen3 M.2 Key E slot | 1 x4 + 3 x1 (PCIe Gen3, Root Port, & Endpoint) | ||||
| USB* | USB Type-C connector: 2x USB 3.2 Gen2 USB Type-A connector: 2x USB 3.2 Gen2, 2x USB 3.2 Gen1 USB Micro-B connector: USB 2.0 | 3x USB 3.2 Gen2 (10 Gbps) 4x USB 2.0 | 3x USB 3.2 Gen2 (10 Gbps) 3x USB 2.0 | USB Type-A Connector: 4x USB 3.2 Gen2 USB Type-C Connector for UFP | 3x USB 3.2 Gen2 (10 Gbps) 3x USB 2.0 | ||||
| Networking* | RJ45 connector with up to 10 GbE | 1x GbE 1x 10GbE | 1x GbE | 1xGbE Connector | 1x GbE | ||||
| Display | 1x DisplayPort 1.4a (+MST) connector | 1x 8K60 multi-mode DP 1.4a (+MST)/eDP 1.4a/HDMI 2.1 | 1x 8K30 multi-mode DP 1.4a (+MST)/eDP 1.4a/HDMI 2.1 | 1x DisplayPort 1.2 (+MST) connector | 1x 4K30 multi-mode DP 1.2 (+MST)/eDP 1.4/HDMI 1.4** | ||||
| Other I/O | 40-pin header (UART, SPI, I2S, I2C, CAN, PWM, DMIC, GPIO) 12-pin automation header 10-pin audio panel header 10-pin JTAG header 4-pin fan header 2-pin RTC batter backup connector microSD slot DC power jack Power, Force Recovery, and Reset buttons | 4x UART, 3x SPI, 4x I2S, 8x I2C, 2x CAN, PWM, DMIC & DSPK, GPIOs | 3x UART, 2x SPI, 2x I2S, 4x I2C, 1x CAN, DMIC & DSPK, PWM, GPIOs | 40-Pin Expansion Header(UART, SPI, I2S, I2C, GPIO) 12-pin button header 4-pin fan header microSD Slot DC power jack | 3x UART, 2x SPI, 2x I2S, 4x I2C, 1x CAN, DMIC & DSPK, PWM, GPIOs | ||||
| Power | 15W - 60W | 15W-75W | 15W - 40W | 10W - 15W - 25W - 40W | 10W - 15W - 25W - 40W | 7W - 15W - 25W | 7W - 15W - 25W | 7W - 10W - 25W | |
| Mechanical | 110mm x 110mm x 71.65mm (Height includes feet, carrier board, module, and thermal solution) | 100mm x 87mm 699-pin Molex Mirror Mezz Connector Integrated Thermal Transfer Plate | 69.6mm x 45mm 260-pin SO-DIMM connector | 100 mm x 79 mmx 21 mm (Height includes feet, carrier board, module, and thermal solution) | 69.6mm x 45mm 260-pin SO-DIMM connector | ||||

文章评论