CVE 挖掘这件事,过去是典型的“人力密集型”:挑项目、读代码、找可疑点、写 PoC、验证、写报告,每一步都要人盯着。AutoCVE 想做的,是把这条链路拆给一组 Agent,让它们自己跑完。
它把自己定义为“一键挖掘 CVE”的自动化平台:筛项目、审源码、验漏洞、出报告,全流程自动化。
五个 Agent,各管一段
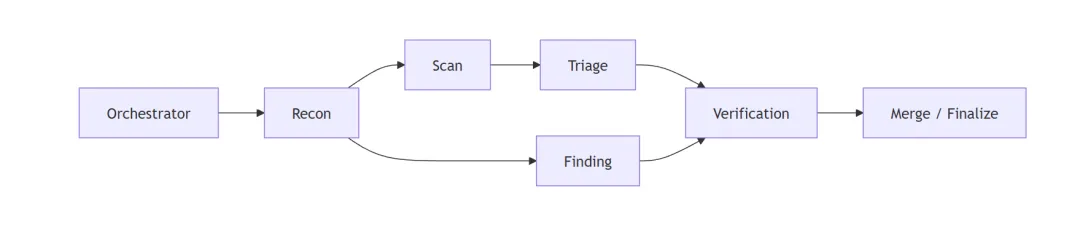
AutoCVE 的核心是 Multi-Agent 协同审计,由一个 Orchestrator 统一调度:
- Recon:信息收集,摸清项目结构、依赖、入口;
- Scan:调用工具做初步扫描,产出候选点;
- Triage:过滤误报,判断哪些值得深挖;
- Finding:针对候选点做漏洞深挖,形成可验证的假设;
- Verification:动态验证,确认漏洞是否真实可利用。
这个拆分方式和人类团队的协作很像。真正有意思的是 Triage 这一环——扫描工具最大的问题从来不是漏报,而是误报太多,多到没人愿意看。把“过滤”单独交给一个 Agent,并且让它有明确的判断依据,是这套流程能不能跑通的关键。
部署:一条 Docker 命令
sudo usermod -aG docker $USER
curl -fsSL https://raw.githubusercontent.com/larlarua/AutoCVE/v1.0.0/docker-compose.prod.cn.yml | docker compose -f - up -d
起来之后访问 http://<你的IP>:3000,默认账号是 [email protected] / demo123。第一次登录后第一件事应该是改密码,这个默认口令显然是给本地体验用的。
http://192.168.23.137:3000
邮箱:[email protected]
密码:demo123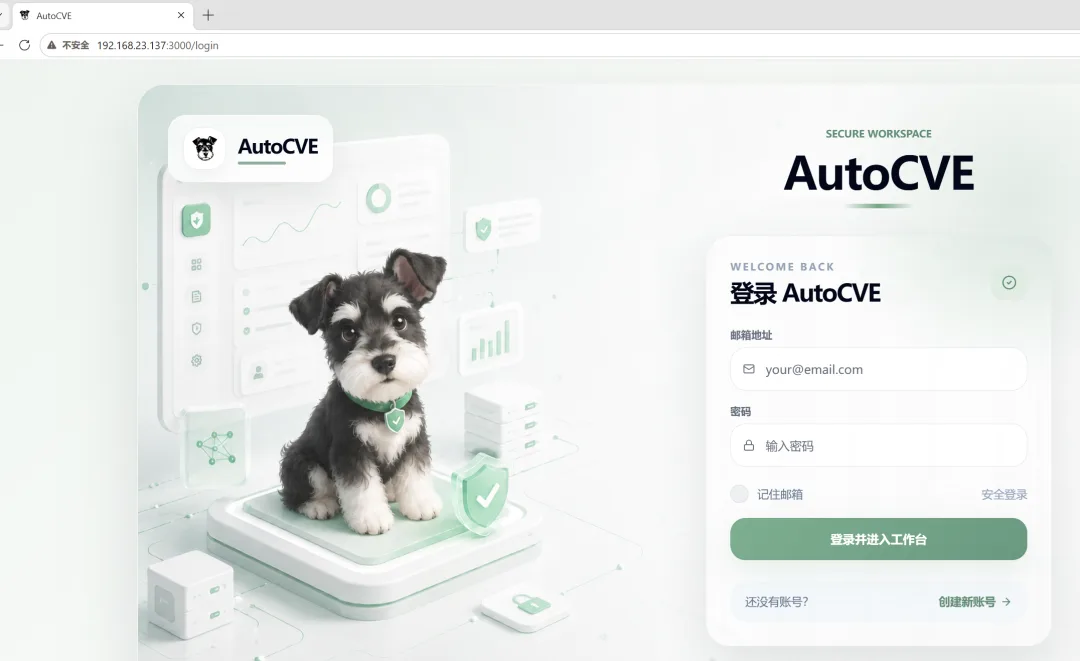
跑一次挖掘的流程
登录之后的操作路径大致是:上传源码 → 新建审计任务 → 选扫描范围 → 等 Agent 跑完 → 看报告。
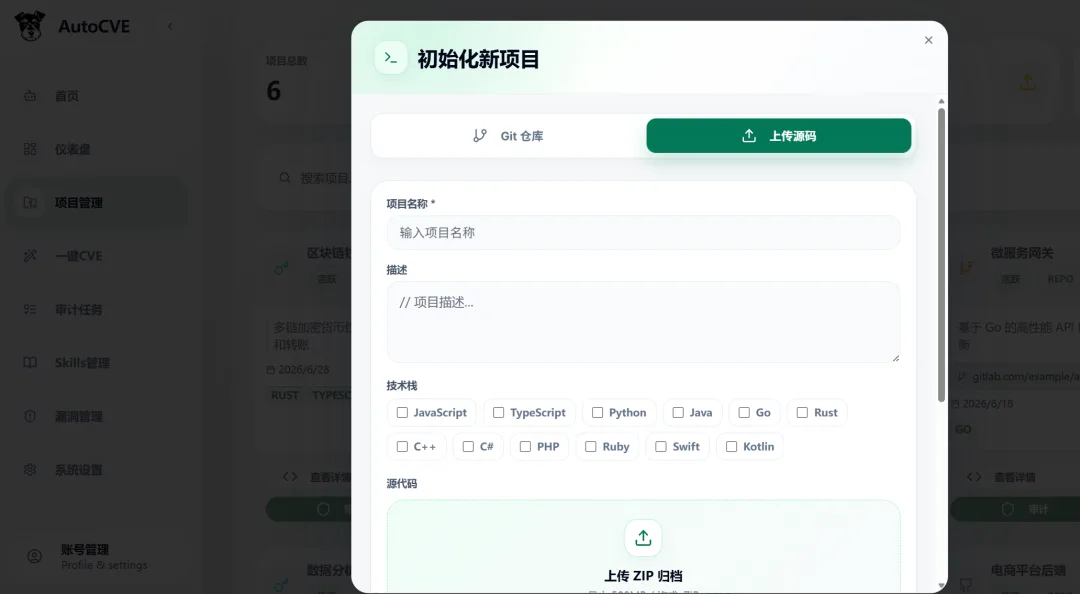
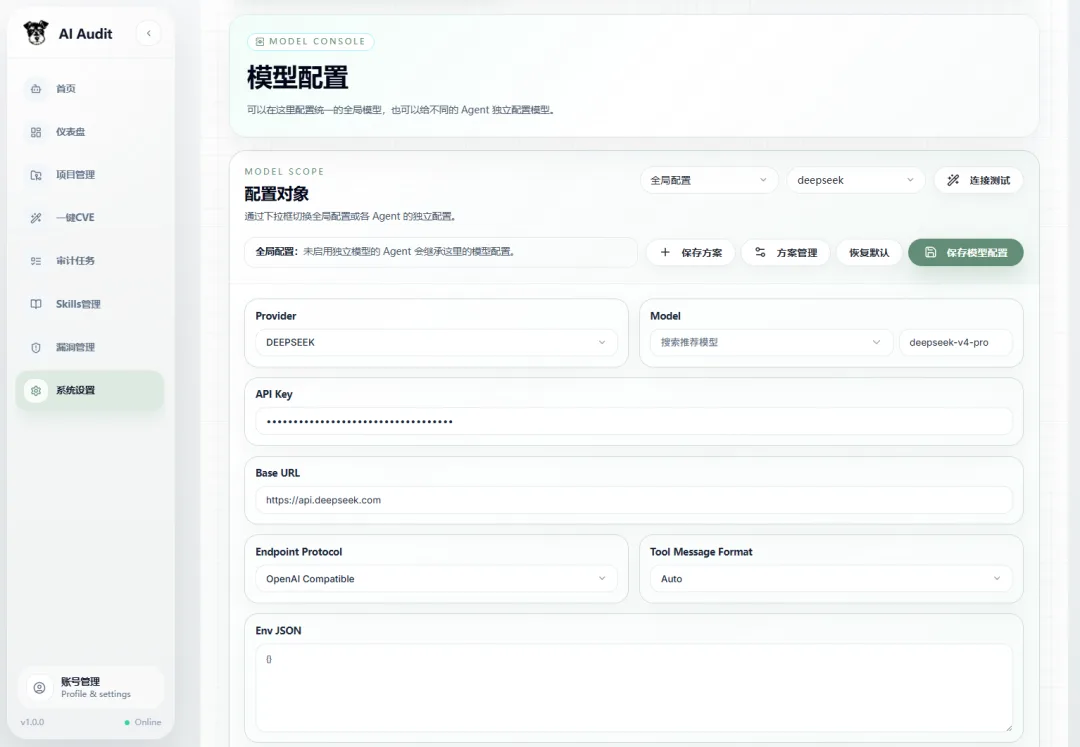
模型配置页可以接 OpenAI 兼容接口,比如 DeepSeek。这一步决定了成本:多 Agent 协同意味着同一个仓库会被反复读很多遍,token 消耗不是线性增长,而是随 Agent 数量和轮次叠加。
产出长什么样
跑完之后给的是 CVE 申报级别的报告:漏洞类型、位置、触发条件、影响、复现步骤,带 CVSS 评分。项目方的说法是,用户复制报告内容就能去提交 CVE 申请。
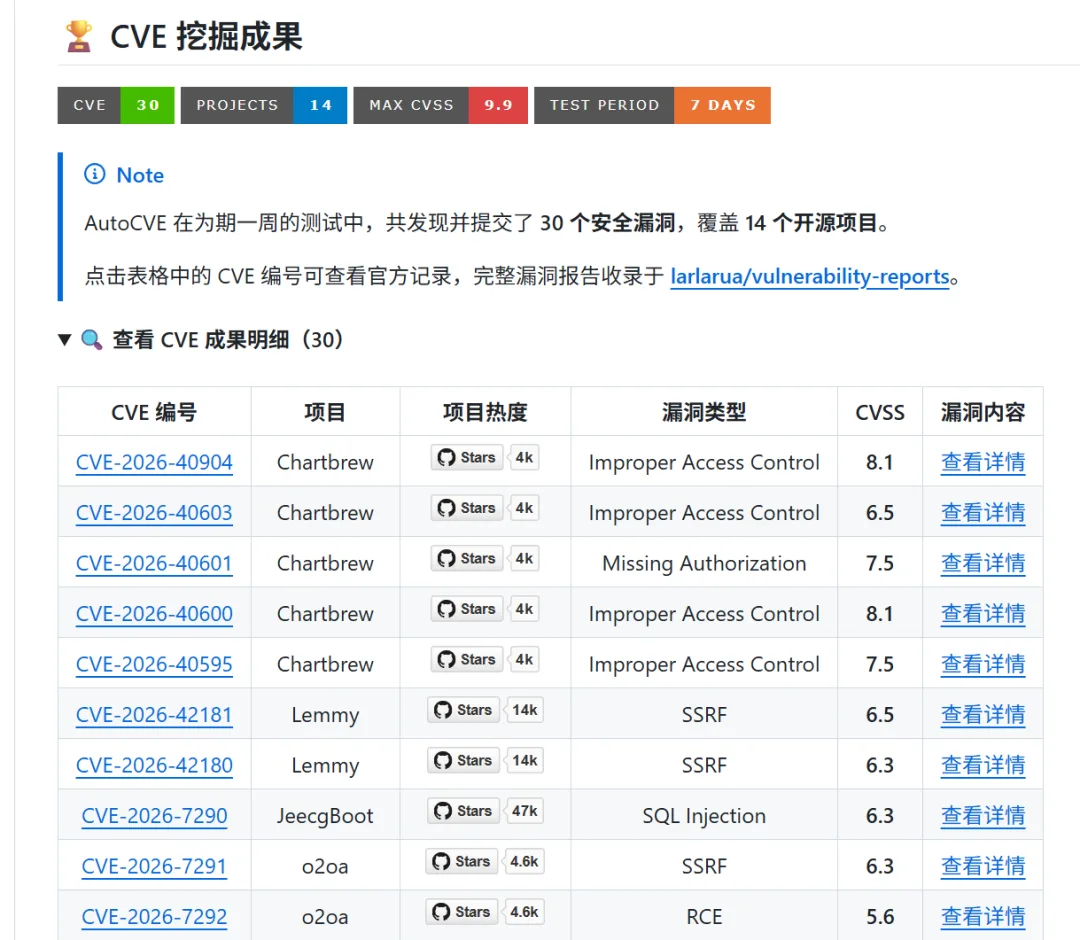
这里要泼一点冷水。自动生成的报告能不能被 CVE 编号机构接受,取决于证据是否充分、影响是否可复现,而不是格式是否完整。Agent 能帮你把材料组织好,但不能替你把“这个漏洞真的能被利用”这件事证实。
几个现实问题
- 成本:多 Agent + 反复读仓库,token 消耗比单轮对话高一个量级,跑大项目前先算一下账;
- 误报:Triage 能过滤掉大部分噪音,但静态分析的局限还在,最终仍要人工复核;
- 授权:只对你自己拥有或明确授权的代码跑。挖别人项目的漏洞并提交报告,边界要看对方的安全政策和法律要求;
- 默认口令:demo 账号一定要改,别把 3000 端口直接暴露到公网。
它适合的场景很明确:手里有一批开源项目想做系统性审计,或者想给自己维护的代码做一次体检。不适合指望它“自动挖出 0day 然后发财”——那条路上真正稀缺的从来不是扫描能力。
项目地址:larlarua/AutoCVE,使用文档见仓库里的 docs/USER_GUIDE.md。

文章评论